inrouch历史数据服务器同步没有统一按钮,核心思路是按数据重要性分层处理:关键业务走增量日志实时同步,历史归档走离线批量迁移,两者结合才能保证数据完整性和业务连续性。
inrouch历史数据迁移到新服务器,怎么同步?
inrouch系统升级或机房搬迁时,历史数据同步是运维最头疼的环节,很多团队会问inrouch的历史数据服务器怎么同步,实际处理时,我们建议把同步动作拆成三个步骤:先盘点,再全量,后增量。
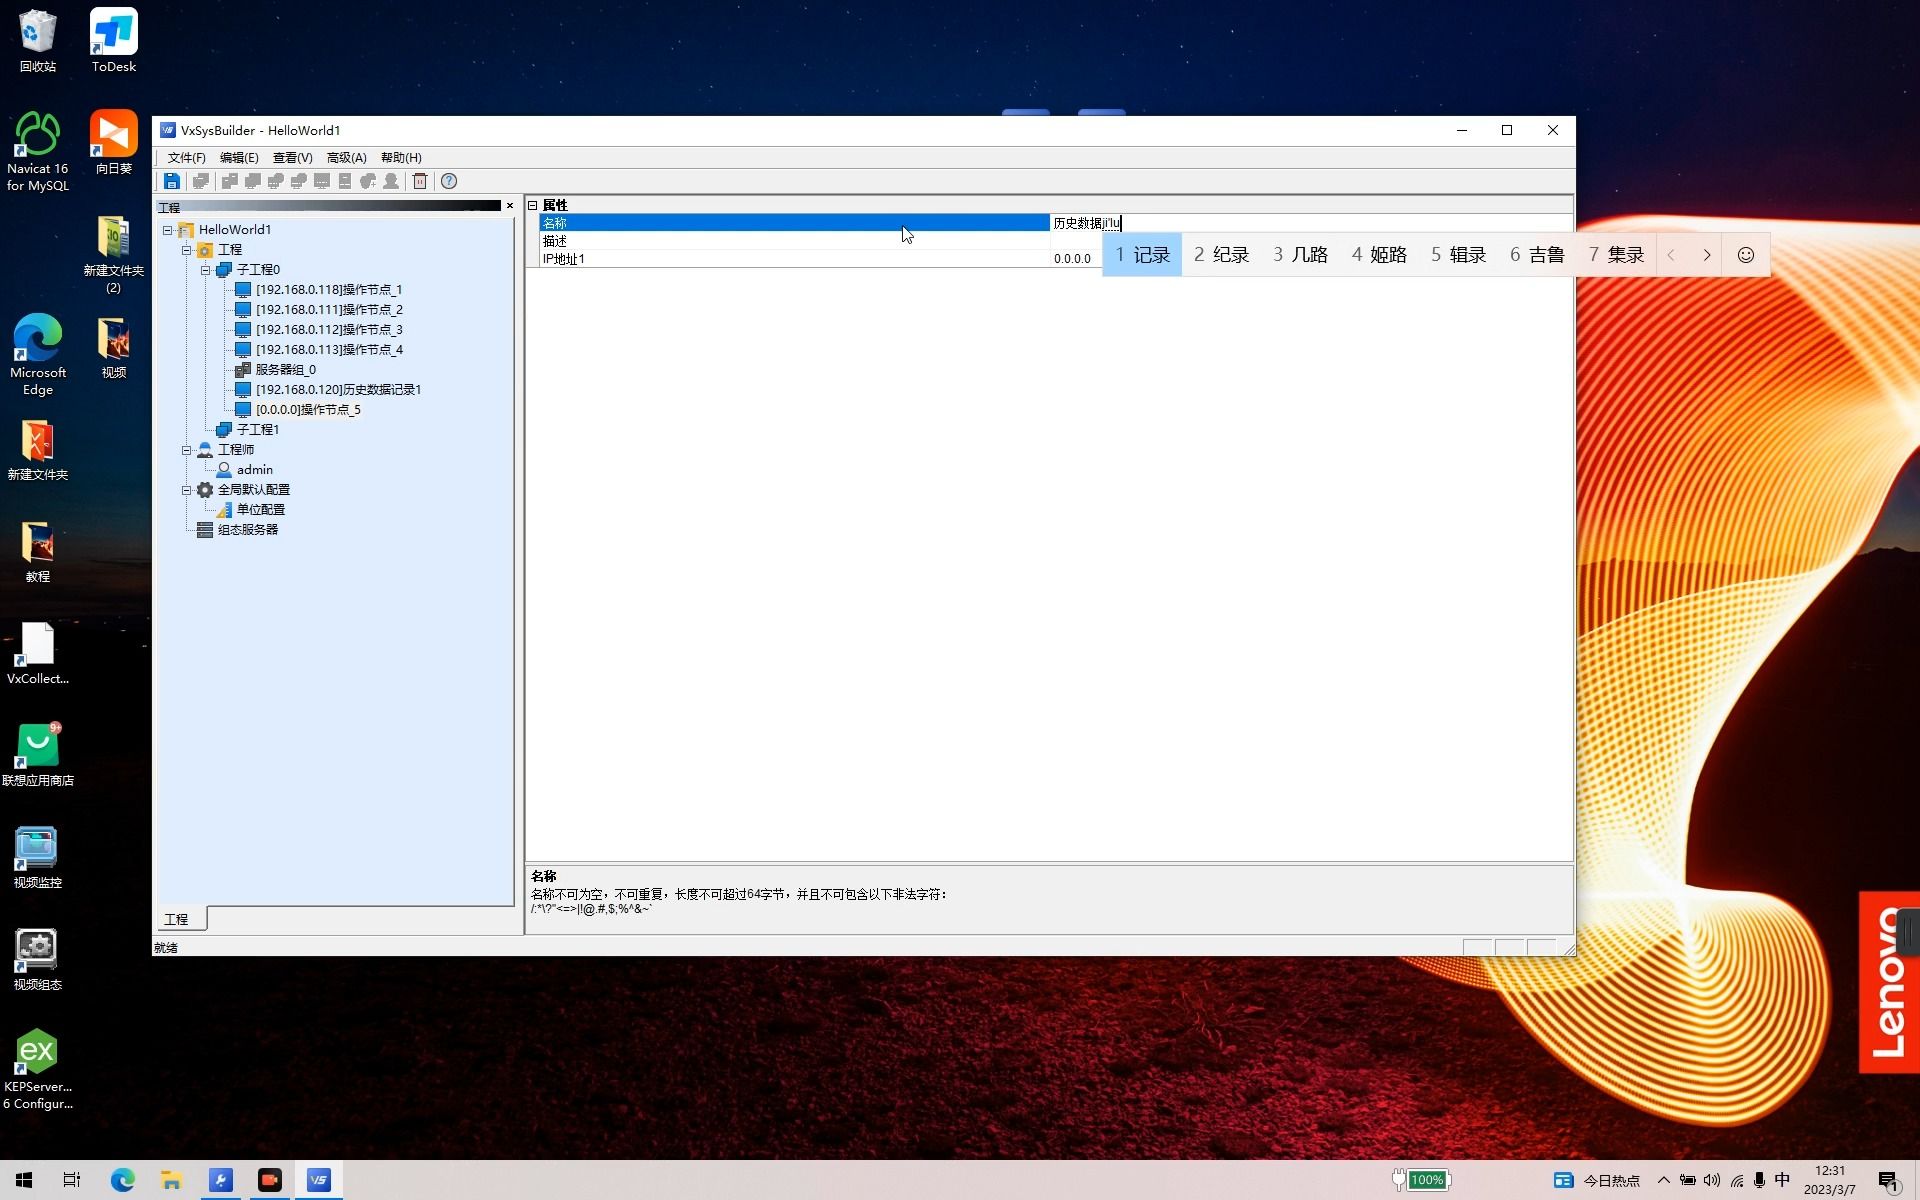
同步前先做数据分层盘点
打开inrouch管理后台,进入系统管理存储引擎数据目录,按库表维度和时间维度导出数据清单,重点看三块:
- 热数据:近30天内有读写操作的表,需要准实时同步
- 温数据:近一年内偶尔查询的表,可接受小时级延迟
- 冷数据:超过一年的历史归档表,用离线批量方式搬运即可
这一步决定了后面选哪种同步策略,多数情况下,inrouch自带的数据字典足够完成盘点,不需要额外写脚本。
全量+增量混合同步的标准操作路径
以最常见的MySQL底层存储为例,inrouch历史数据迁移分四步走:
- 停写窗口:在业务低峰期设置只读模式,命令为
FLUSH TABLES WITH READ LOCK,记录binlog位置 - 全量导出:使用
mysqldump --single-transaction --master-data=2导出历史库,或者直接用inrouch内置的数据导出插件(后台路径:数据管理备份恢复导出任务) - 目标端导入:将导出文件加载到新服务器,注意先关闭外键检查
SET FOREIGN_KEY_CHECKS=0,导入完成后恢复 - 增量追平:利用binlog同步工具或inrouch的Change Data Capture组件,从记录的binlog位置开始回放,直到主从延迟归零
切换前必须做一次一致性校验,用checksum table比较源端和目标端的数据指纹,不一致的表重新单独同步。
inrouch多机房同步方案怎么选?
如果是两地三中心或同城双活架构,inrouch历史数据服务器怎么同步就变成了持续性问题,不是一次性迁移,不同同步方式的取舍直接影响成本和运维压力。
| 同步方式 | 延迟水平 | 占用带宽 | 适用场景 |
|---|---|---|---|
| 实时主从复制 | 秒级 | 较高 | 核心交易库,RTO要求分钟级 |
| 半同步复制 | 毫秒级 | 较高 | 对一致性极其敏感的账户类数据 |
| 消息队列异步同步 | 秒到分钟级 | 低 | 日志类、操作流水类数据 |
| 离线批量ETL | 小时或天级 | 可控 | 数据仓库、报表历史库 |
行业共识认为,inrouch主库同机房或跨机房部署时,优先使用半同步复制,因为它在性能和可靠性之间最平衡,对于跨地域的归档库,别想着实时同步,每晚跑一次定时任务比对增量就够了。
多机房同步的坑:网络抖动和脑裂
即使同步方案选对了,配置不当也会出问题,inrouch多机房同步部署时注意两个配置文件:sync.ini里的queue_size参数,值设太大会导致积压,设太小在高峰期会频繁触发背压;还有retry_interval,建议设为5秒,重试上限10次,避免网络瞬断后数据追不上。
inrouch同步延迟高怎么办?
历史数据服务器同步最常被问到的就是延迟问题,如果你在inrouch监控面板看到sync_delay字段持续增长,按下面顺序排查,效率最高。
第一步:确认是网络还是计算瓶颈
在两端服务器上分别执行ping -c 50 目标IP,看丢包率和平均时延,当RTT超过50ms时,实时同步延迟基本压不下来,考虑改用异步批量。
第二步:检查主库的写入压力
运行show engine innodb status,重点关注History list length,这个值持续超过10000说明purge线程跟不上,历史行版本没及时清理,同步读取会变慢。
第三步:排查从库回放效率
inrouch从库执行show slave status,看Seconds_Behind_Master,数值很大时,用perf top定位是CPU瓶颈还是锁等待,常见的坑是从库上有大查询占用IO资源,把历史数据同步任务和业务查询错峰调度。
第四步:检查大事务
一次更新超过10万行的事务会拖垮所有下游同步链路。业内专家指出,把inrouch里的大事务拆成小批提交,是降低同步延迟最直接的优化手段,比如原本一条批量更新语句,手动改成每5000行一次commit。
inrouch历史数据服务器同步失败的常见坑
同步任务跑着跑着就挂掉,这类问题多半出在以下几个环节:
- 权限不足:同步账号需要
REPLICATION SLAVE, REPLICATION CLIENT权限,别图省事只给SELECT权限 - 字符集冲突:源库是
utf8mb4,目标库是utf8,中文数据会被截断,同步时强制指定--default-character-set=utf8mb4 - 主键冲突:历史表里有datetimes字段做联合主键,批量迁移时目标端已有数据,用
insert ignore会静默丢数据,正确姿势是replace into或先按主键去重 - 自增列断档:导入时要把
AUTO_INCREMENT值预先调到源表的max(id)+1,否则后续业务写入会撞主键
失败后的自动补偿机制
inrouch从2.4版本开始支持断点续传,在同步配置里开启checkpoint开关,任务中断后重新启动,它会自动读取上次记录的位置信息,不需要人工重新跑全量,但如果同步任务已经卡死超过2小时,建议直接停掉任务,检查目标端是否有死锁持有undo日志,清理后重新启动任务。
同步完成后怎么验收?三个动作必须做
历史数据服务器同步不是“导完就算完”,同步完成后第二天早晨的验证才是真正的验收标准。
- 行数比对:
select count()源库和目标库,允许误差为0 - 抽样比对:对时间分区的首尾、中间各抽一张表做
checksum,不一致的表重新追增量 - 业务探活:新环境启动一个只读应用实例,执行能覆盖核心数据表的查询,响应时间异常立即回滚流量
inrouch同步工具选哪个比较好?
经常有人问inrouch历史数据服务器怎么同步用什么工具合适,如果你熟悉命令行的灵活性,直接用mysqldump加binlog组合最稳定,如果想减少手工操作,inrouch企业版自带的数据同步中心模块(菜单路径:数据管理数据同步中心)已经支持全量迁移、增量订阅、自定义过滤条件,不用额外开发。
开源自研方案里,Canal和DataX的搭配也是可行的:Canal负责抓取binlog,DataX跑T+1的离线批任务,整体成本不高,但需要团队能自己维护坑位检查、位点保存这些细节。
总结一句话:inrouch历史数据服务器怎么同步,核心就是分类处理,实时和批量并行,同步前后必须做校验。
inrouch同步配置里checkpoint有什么作用?
checkpoint是inrouch同步任务的断点标记机制,开启后,每同步一批数据,系统会记录当前的binlog文件名和位置信息,任务意外中断时重启,不会再重头扫描全部历史数据,而是从最近的标记点继续追账,可有效减少重复劳动和出错概率。
inrouch同步过程中出现数据不一致怎么办?
同步过程中发现数据不一致,先暂停业务写入,用checksum table定位不一致的表范围,优先用pt-table-sync工具修复差异行,如果工具无法覆盖坏数据场景,直接从源库导出不一致的表,单独导入目标端覆盖,修复后立即开启增量校验任务,观察后续数据是否持续一致。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/783301.html