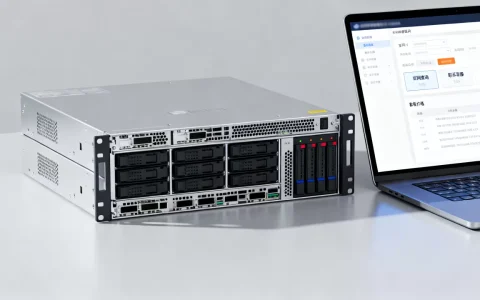
在服务器上跑深度学习,核心是根据任务量级选择GPU算力匹配的云实例或自建方案,并保障CPU与内存不形成瓶颈,才能让训练效率最大化。
深度学习服务器配置推荐:GPU、内存还是存储优先?
配置服务器时,绝大多数人首先纠结的是预算到底该往哪砸,GPU毫无疑问是算力核心,但内存和存储一旦拖后腿,再贵的GPU也得排队等数据。

GPU选型决定训练速度
NVIDIA的A100、H100是当前数据中心的标杆,适合大规模分布式训练,如果你主要跑中小模型或批量推理,RTX 4090或者A6000在性价比上反而更突出,行业共识认为,决定训练吞吐量的关键不是显存大小,而是FP32/TF32算力与显存带宽的配合。H100的Transformer引擎在大模型场景下能把训练时间缩短40%以上,但成本也翻倍,选择时先看任务类型:CV分类用RTX级别就够了,LLM微调至少需要A100 80GB起步。
内存容量与带宽不可忽视
很多人在服务器上跑深度学习,把内存配得很低,结果模型加载时直接OOM。深度学习服务器内存配置建议是GPU显存总量的2-3倍,比如四张A100 80GB,系统内存至少512GB,DDR5与DDR4的带宽差距在CPU读取数据时能拉开一倍,对于频繁预处理的数据集,高带宽内存能明显减少GPU空闲等待。
存储与数据读取速度
数据加载是另一个容易被忽视的瓶颈,多数情况下,机械硬盘根本扛不住大规模训练的数据吞吐。NVMe SSD阵列是必须的,尤其是单盘读写低于3GB/s的型号,训练时你会看到GPU利用率频繁掉到30%以下,建议采用RAID 0配置四块企业级NVMe,或者直接上全闪存文件系统,如果数据量超过几十TB,可以考虑分层存储:热数据放SSD,冷数据挂HDD,但训练时务必把完整数据集预加载到SSD。
网络与多卡互联
多卡训练时,GPU间的通信速度直接决定线性扩展效率,NVLink是NVIDIA的专有方案,但跨节点需要InfiniBand或RoCE,统计显示,在千卡集群中,网络带宽低于100Gbps会导致扩展效率损失10%以上,小规模测试用PCIE 4.0 x16也能凑合,但生产环境建议直接上InfiniBand HDR 200Gbps。

云服务器跑深度学习划算吗?成本与性能拆解
很多人问我,到底是租云服务器跑深度学习好,还是自己买硬件搭,这个问题没有标准答案,关键看使用频率和项目周期。
云实例的灵活性与初始成本
云服务器跑深度学习最大的优势是零起步成本,你不需要花几十万买卡,而是按小时租用,用完即停。短期项目或实验性任务,云实例是绝对划算的选择,比如在简米云或酷番云上租一台A100 80GB实例,每小时成本约30-50元,训练一个模型花2000元,比自建一次投入十几万灵活得多,而且云厂商会持续更新硬件,你总能租到最新的GPU,不用承担折旧风险。
自建服务器的长期投资回报
如果你的团队长期有训练任务,GPU利用率能维持在70%以上,自建服务器反而更省钱。硬件折旧按三年算,平均到每天的成本远低于云实例,而且自建服务器跑深度学习,数据完全在本地,没有带宽和隐私顾虑,不过运维成本不可忽略:散热、电力、机房空间、硬件故障,这些都需要专人负责,业内专家指出,在利用率超过60%的场景下,自建方案三年总成本比云低35%-50%。
性能对比:云GPU vs 裸金属
云实例因为虚拟化层和共享资源,有时会出现性能波动,导致训练时间不稳定,相比之下,裸金属服务器(物理机)能提供更一致的计算性能,但云厂商也在改进,比如AWS的p5实例采用专用机箱,虚拟化损耗几乎为零,如果你对性能敏感,建议选择云厂商的“GPU直通”或“裸金属”类型实例,避免与邻居争抢资源。
地域选择对延迟与合规的影响
国内云服务商在华北、华东、华南都有数据中心。如果你的数据存储在本地,服务器跑深度学习时尽量选择同一地域的机房,减少数据传输延迟,对于金融、医疗等敏感行业,可能还需要考虑数据不出域,此时选择自建或本地云专区更合规,海外项目则优先选美西或新加坡,兼顾延迟与成本。

深度学习服务器搭建教程:从系统到环境配置
假设你已经有了服务器(不管是自建还是云实例),下面就是把它变成可用工作站的步骤。
操作系统与驱动安装
Ubuntu Server 22.04 LTS是目前最主流的选择,社区支持好,兼容性稳定,安装完成后,第一步是安装NVIDIA驱动,使用官方runfile或apt仓库都行,建议用nvidia-driver-535或更高版本,然后安装CUDA Toolkit 12.x,注意和框架的兼容性,最后用nvidia-smi验证,确认显卡信息正常。
深度学习框架部署
推荐使用Docker来管理环境,避免依赖冲突。NVIDIA NGC容器已经预装好CUDA、cuDNN和常用框架,直接拉取运行最省事。
docker pull nvcr.io/nvidia/pytorch:24.01-py3如果你需要自定义环境,用conda或pip按需安装,PyTorch和TensorFlow都支持CUDA,安装时指定版本号即可,注意CUDA版本与PyTorch的对应关系,否则可能无法调用GPU。
多用户管理与作业调度
当多个人共享一台服务器时,需要作业调度系统来分配资源。Slurm是深度学习场景下最常用的调度器,配置完成后,每个人提交任务时指定GPU数量,Slurm自动排队分配,安装步骤:
- 安装munged和slurm
- 配置节点信息
- 用
scontrol设置分区 - 用户通过
sbatch提交脚本
这样能避免资源争抢,提高利用率。
监控与性能优化
日常监控用nvidia-smi和htop就够,但长期跑训练建议安装nvtop,实时查看GPU温度、功耗和利用率。设置GPU持久模式可以减少上下文切换开销,命令是nvidia-smi -pm 1,如果发现GPU利用率不稳定,先用nvidia-smi pmon看是否被其他进程抢占,再检查CPU和内存是否成为瓶颈。
服务器跑深度学习需要什么配置?典型场景配置表
下表汇总了不同任务规模的推荐配置,方便你快速定位。

| 场景 | 推荐GPU | 系统内存 | 存储 | 网络 |
|---|---|---|---|---|
| 入门CV图像分类(ResNet50级别) | 1-2张RTX 4090 24GB | 32-64GB DDR5 | 1TB NVMe | 千兆以太网 |
| 中大型NLP微调(BERT/Llama系列) | 4张A100 80GB / H100 | 256-512GB DDR5 | 2TB NVMe SSD | InfiniBand或RoCE |
| 多模态大模型预训练(GPT/CLIP) | 8张H100 80GB或更多 | 1TB以上 | 全闪存10TB+ | 200Gbps以上 |
| 推理服务(批量部署) | 1-2张T4/L4/RTX 4090 | 16-32GB | 普通SSD | 千兆 |
注意:显存不足时,模型会使用CPU内存,训练速度会暴跌,所以配置时优先保证显存够用,再考虑其他。
常见问题解答
深度学习服务器配置推荐中,CPU应该选什么?
CPU只要不成为瓶颈即可,核心数不用太多,但主频高一点更好。推荐Intel Xeon 4xxx系列或AMD EPYC 7xxx,至少8核,16-32核更稳健,对于仅做训练的服务,CPU负载通常不高,但如果你同时做数据预处理,多核会有帮助。
云服务器跑深度学习划算吗,还是本地搭建?
短期和波动性项目,云服务器跑深度学习更划算,按需付费,不用承担硬件闲置,长期高强度训练,本地搭建成本更低,可以先用云做原型验证,再根据使用频率决定是否迁移到自建,如果预算有限,也可以考虑租用固定期限的云裸金属,比按需便宜但比自建灵活。
服务器上跑深度学习,单卡和多卡有什么区别?
单卡适合小模型或批量较小的场景,代码简单,不需要额外通信。多卡训练能显著加速大模型,但需要处理数据并行或模型并行,通信开销随卡数增加,当集群规模超过一定量级时,扩展效率会逐渐下降,对于大多数团队,4卡是性价比拐点,继续增加卡数,成本增长速度超过性能提升。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a6%82%e4%bd%95%e5%9c%a8%e6%9c%8d%e5%8a%a1%e5%99%a8%e4%b8%8a%e8%b7%91%e6%b7%b1%e5%ba%a6%e5%ad%a6%e4%b9%a0%ef%bc%8c%e9%9c%80%e8%a6%81%e4%bb%80%e4%b9%88%e9%85%8d%e7%bd%ae%ef%bc%9f/