


服务器监控系统文档
服务器监控系统是现代IT基础设施不可或缺的神经中枢,它通过持续收集、分析和可视化服务器关键性能指标与运行状态,为运维团队提供实时洞察力,保障业务连续性、优化资源利用并快速定位故障根源,一套设计精良的监控体系是业务稳定高效运行的基石。

核心监控对象与关键指标
一个全面的监控系统需覆盖多层次的关键目标:
-
硬件资源层监控:
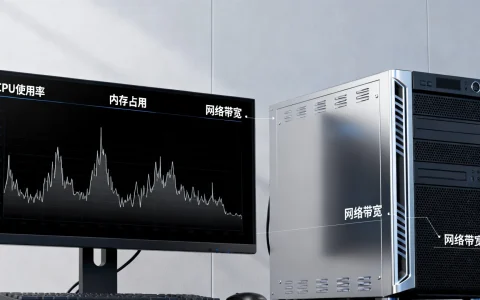
- CPU: 使用率(整体及各核心)、负载(1/5/15分钟)、上下文切换、中断频率。
- 内存: 使用量、空闲量、缓存/缓冲量、Swap使用率及交换频率,内存泄漏是常见隐患。
- 磁盘:
- I/O: 读写吞吐量(MB/s)、IOPS(每秒读写操作数)、I/O等待时间(await)、队列深度。
- 空间: 分区/卷/文件系统使用率、Inode使用率(尤其对海量小文件场景),预测性空间告警至关重要。
- 网络:
- 接口: 进出带宽利用率(bps)、包速率(pps)、错包/丢包率、连接数(TCP/UDP状态)。
- 服务端口: 关键服务(如HTTP/HTTPS, SSH, DB)端口可达性。
-
操作系统层监控:
- 系统负载: 综合反映CPU、磁盘I/O、内存压力的Load Average值。
- 进程状态: 关键进程(如Web服务器、数据库、应用服务)的运行状态、数量、资源消耗(CPU、内存)。
- 登录与安全: 异常登录尝试、sudo提权记录、关键系统日志(syslog)错误/告警信息。
-
应用与服务层监控:
- 应用性能: 响应时间(平均、P95/P99)、吞吐量(RPS/QPS)、错误率(HTTP 5xx, 应用逻辑错误),采用RED(Rate, Errors, Duration)或USE(Utilization, Saturation, Errors)方法论。
- 中间件: 数据库连接池状态、查询性能(慢查询)、缓存命中率(Redis/Memcached)、消息队列积压量(Kafka/RabbitMQ)。
- API健康: 关键API端点可用性、延迟、返回码分布。
-
业务层监控:

- 核心业务指标: 订单创建速率、支付成功率、用户活跃度等与业务目标直接挂钩的指标。
- 合成监控: 模拟用户行为(如登录、下单流程)的端到端可用性与性能。

监控系统核心组件与选型
-
数据采集(Agents/Exporters):
- 轻量级代理: Telegraf(灵活,插件丰富)、Datadog Agent(功能强大,商业集成好)、Prometheus Node Exporter(专为Prometheus设计)。
- 无代理方式: SNMP(网络设备、基础服务器指标)、WMI(Windows)、JMX(Java应用)、专用API(云平台、特定服务)。
- 日志采集: Filebeat(轻量)、Fluentd/Fluent Bit(强大灵活)、Logstash(处理能力强)。
-
时序数据库(TSDB):
- 核心要求: 高写入吞吐、高效压缩、快速查询(尤其时间范围聚合)、可扩展性。
- 主流选择:
- Prometheus: 开源标准,拉模型,强大查询语言PromQL,内置告警,适合云原生,单机限制需配合Thanos/VictoriaMetrics解决长期存储与集群化。
- InfluxDB: 高性能,类SQL查询(Flux/InfluxQL),商业版功能强(集群、高可用),开源版(OSS)功能受限。
- TimescaleDB: 基于PostgreSQL的时序扩展,支持完整SQL,适合需要复杂关系查询的场景。
- VictoriaMetrics: Prometheus兼容,高性能,低资源消耗,集群方案成熟。
- Elasticsearch: 常用于日志(ELK Stack),也可存储指标,查询灵活但时序优化不如专用TSDB。
-
可视化与仪表盘:
- Grafana: 开源事实标准,数据源支持广泛(Prometheus, InfluxDB, ES, MySQL等),图表类型丰富,仪表盘定制灵活,社区强大。
- Kibana: ELK Stack核心组件,擅长日志可视化,指标可视化能力持续增强。
- 商业方案内置: Datadog, New Relic, Dynatrace等APM厂商提供一体化可视化。
-
告警管理:
- 告警规则定义: 基于阈值(静态/动态)、异常检测(机器学习)、事件关联等。
- 告警路由与分级: 根据严重性(P0-P3)、服务、团队等维度路由到不同渠道(邮件、Slack、钉钉、PagerDuty、电话)。
- 告警聚合与抑制: 避免告警风暴,关联告警合并,维护期抑制。
- 主流方案: Prometheus Alertmanager(开源核心)、Grafana Alerting(日益强大)、商业监控平台内置告警引擎。
-
日志管理(可选但强烈推荐集成):
- ELK Stack (Elasticsearch, Logstash/Filebeat, Kibana): 开源主流方案。
- Loki: Grafana Labs出品,轻量级日志聚合系统,索引小,查询快,与Prometheus/Grafana集成无缝。
- Splunk: 功能强大,商业方案领导者,成本较高。

实施路径与最佳实践
- 明确目标与范围: 界定监控对象(哪些服务器、服务、应用)、核心业务指标、SLA/SLO要求。
- 选择合适的工具栈:
- 考虑团队技术栈熟悉度、环境规模(物理机/虚拟机/K8s)、预算(开源/商业)、云环境(利用云原生监控)。
- 推荐组合:
Prometheus + Node Exporter/特定Exporter + Grafana + Alertmanager(基础监控) +Loki + Promtail(日志) 是强大且流行的开源组合。
- 标准化部署与配置:
- 使用配置管理工具(Ansible, SaltStack, Puppet)或IaC(Terraform)自动化Agent/Exporter部署与配置。
- 统一指标命名规范(如Prometheus的
<metric name>{<label name>=<label value>, ...})。
- 构建核心仪表盘:
- 全局概览: 核心集群/服务状态、关键业务指标、告警摘要。
- 主机视图: 单台服务器CPU、内存、磁盘、网络、负载详情。
- 服务视图: 特定服务(如Nginx, MySQL, Redis)的性能与状态。
- 业务视图: 核心转化流程、用户行为关键指标。
- 遵循“一目了然”原则,突出关键信息。
- 设计有效告警:
- 聚焦业务影响: 告警应反映影响用户体验或业务功能的问题。
- 避免噪音: 设置合理阈值,利用持续时长、告警分级、抑制规则减少无效告警,优先解决频繁触发的告警。
- 包含上下文: 告警信息应包含主机名、服务名、指标值、建议初步排查方向。
- 定期评审优化: 持续审视告警有效性、准确性,调整阈值和规则。
- 集成与自动化:
- 与工单系统(Jira, ServiceNow)集成,告警自动创建工单。
- 与ChatOps工具(Slack, 钉钉)集成,便于团队协作处理。
- 自动化响应:针对特定已知问题(如进程挂掉)配置自动重启等基础自愈。
典型场景解决方案
- 微服务/Kubernetes监控:
- 利用Prometheus Operator简化在K8s中部署管理Prometheus。
- Kube-state-metrics监控K8s对象状态。
- cAdvisor监控容器资源使用。
- 服务网格(Istio, Linkerd)集成提供细粒度服务间监控。
- 混合云/多云监控:
- 部署中心化或联邦式Prometheus/VictoriaMetrics聚合各区域/云数据。
- 利用云服务商提供的原生监控(CloudWatch, Azure Monitor, Stackdriver)并通过Exporter或API接入统一平台。
- 确保网络联通性与安全性。
- 高并发业务保障:
- 深度监控应用链路:结合APM工具(SkyWalking, Pinpoint, 或商业方案)追踪请求全链路,定位性能瓶颈。
- 重点监控数据库、缓存、消息队列等后端依赖。
- 设置容量预警(CPU、连接数、队列长度)。
演进方向:AIOps与可观测性
现代监控正超越传统指标/日志/告警,向可观测性(Observability) 演进:
- 指标(Metrics): 反映系统状态的时间序列数值。
- 日志(Logs): 离散事件记录,包含丰富上下文。
- 追踪(Traces): 记录请求在分布式系统中的端到端执行路径。
- 持续剖析(Continuous Profiling): 深入分析应用代码级资源消耗(CPU、内存)。
- AIOps: 应用AI/ML技术进行异常检测(动态基线)、根因分析、告警压缩、预测性维护,提升运维智能化水平。
您的监控体系是否曾因漏掉关键指标导致故障?当前在追踪微服务调用链或利用AI预测瓶颈方面,面临的最大挑战是什么?分享您的实战经验与痛点,共同探讨更智能的运维未来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a6%82%e4%bd%95%e6%90%ad%e5%bb%ba%e6%9c%8d%e5%8a%a1%e5%99%a8%e7%9b%91%e6%8e%a7%e7%b3%bb%e7%bb%9f%ef%bc%9f2026%e5%b9%b4%e6%9c%80%e4%bd%b3%e6%96%b9%e6%a1%88%e6%8e%a8%e8%8d%90/




评论列表(3条)
作为一个错误码收藏家,我觉得监控系统太实用了,它能实时捕捉错误码,帮助快速诊断问题,2026的方案肯定更给力!
@甜粉5406:对啊,监控系统抓错误码确实效率高,2026方案可能更智能,比如AI辅助诊断。作为学习者,我也爱复盘错误码来优化系统,咱收藏家共勉!
看了这篇文章讲搭建服务器监控系统,我挺有共鸣的。2026年的方案推荐听起来挺靠谱的,强调了实时监控的重要性,这点我完全同意。但说实话,我自己在这上面栽过跟头——第一次搭建时太心急,没规划好工具和资源,结果监控系统崩溃,服务器直接瘫痪,搞得整个业务停摆,那会儿真叫一个崩溃啊! 那次失败后,我才明白韧性有多关键。不是光选个方案就行,得一步步调试,从日志中学习错误根源。比如,我开始小范围测试,备份数据,再慢慢扩展,最终系统稳了。现在回想,失败教会我别怕跌倒,只要调整心态、坚持优化,就能爬起来。这篇文章提醒大家:细节决定成败,监控系统不是一蹴而就的,希望更多人能从挫折中成长!