量化回测处理海量tick数据的读取瓶颈,主要卡在逐行解析、二进制转十进制和重复I/O这三个环节,优化方向是列式存储、内存映射和批量并行读取。
tick数据读取慢的根源在哪
很多做量化交易的朋友都有这种体验:策略逻辑跑起来飞快,但一加载tick数据,进度条就像卡住了一样,多数情况下,问题不在CPU计算,而在数据读取和解析这条链路上。

逐行解析是最大的坑
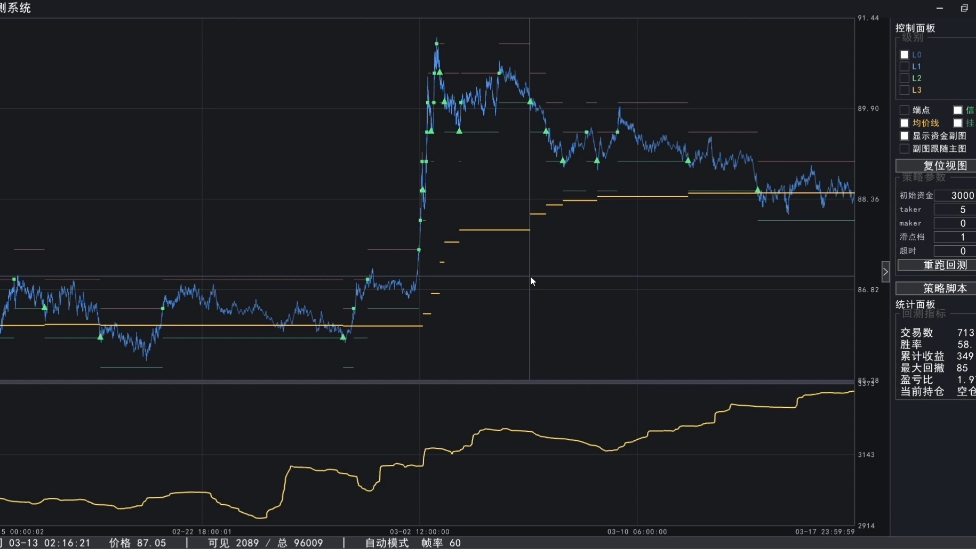
tick数据本质上是逐笔成交,一天的行情可能就包含上百万条记录,如果用传统方式一行行读取、一行行解析,每一条记录都要做一次字符串切割和时间转换,这个开销在分钟级别数据上不明显,但放到tick级别就会被放大成数量级的差距。
行业共识认为,字符串解析的性能开销比二进制读取高出几个数量级,这也是为什么很多现成的回测框架处理日线数据飞快、但一碰tick数据就原形毕露的根本原因。
二进制转十进制的隐藏成本
交易所原始数据大多是二进制或特殊的协议格式,量化开发者拿到手的数据是已经解码过的文本格式,这时候看似方便,实则埋下了隐患。
文本格式中的价格、成交量都是字符串,程序运行时需要转换成浮点数和整数。每一次转换都涉及类型判断和内存分配,量大了以后,这部分开销甚至超过磁盘I/O本身。
重复I/O操作被大多数人忽略
还有一个容易被忽视的问题:策略调试过程中,同一个tick文件往往被读取几十次甚至上百次,即使做了文件缓存,操作系统层面也很难完全消除重复读取的损耗。
业内专家指出,这类问题通常在实盘模拟或参数优化时集中爆发因为这时候需要反复加载相同的数据集,I/O瓶颈被倍数放大。
tick数据怎么存才能让回测跑得快
存储方案直接决定了读取效率,选对格式,回测速度提升数倍是常态;选错了,后面怎么优化都事倍功半。
列式存储是当前的最优解
传统CSV是行式存储,读取时必须把整行数据都拉进内存,即使你只需要其中的价格列。列式存储(如Parquet、Arrow)彻底改变了这个局面只需要读取你真正用到的列,I/O量直接下降一个量级。
用Parquet存储tick数据,配合压缩算法,磁盘占用通常能降到CSV格式的三分之一甚至更低,底层列式布局天然适合向量化计算,回测引擎可以批量处理价格、成交量序列,而不是一条条循环。
Parquet格式本身支持谓词下推和列裁剪,读取时还能跳过无关数据块,对于动辄几十GB的tick数据集来说,这些特性带来的收益非常可观。
内存映射文件是读取速度的终极手段
如果数据规模能控制在物理内存的范围内,mmap(内存映射)就是读取速度的天花板。mmap让操作系统直接管理文件到内存的映射,省去了用户态和内核态之间的数据拷贝。
在Python生态里,numpy.memmap 可以让tick数据表现得像一个普通数组,访问时操作系统按需加载页面,对于回测场景通常是顺序扫描这种方式的缓存命中率极高,速度接近纯内存访问。
不过要注意,mmap方案对内存大小有硬性要求,如果数据超过物理内存,反而可能因为频繁缺页中断导致性能更差。一般建议数据量在内存容量的二分之一以内时才考虑mmap。
时序数据库是团队协作的备选方案
如果多人共用一套tick数据,单机文件方案就有点捉襟见肘了,近些年,ClickHouse这类时序数据库在量化团队中越来越普及。
ClickHouse擅长处理海量时序数据的聚合查询,支持SQL直接筛选时间范围和合约代码,免去了手工处理文件路径的烦恼,缺点是部署运维成本较高,而且回测时需要把数据从数据库拉取到本地策略进程中,网络I/O会成为新的瓶颈。
多数情况下,个人量化开发者优先考虑本地列式文件存储即可,只有当数据版本管理、多人协作、增量更新成为主要诉求时,再转向数据库方案。
python读取tick数据太慢的针对性优化
Python生态在量化领域占有极大比例,但Python本身的性能短板在处理tick数据时暴露无遗,好在有成熟的第三方库可以大幅缓解这个问题。
pyarrow批量读取代替逐行循环
接触过tick数据的人应该都写过类似这样的代码:用csv.DictReader逐行读取、逐行处理,这种做法在处理百万级数据时,耗时会以分钟甚至小时计算。
换成pyarrow.parquet.read_table之后,读入速度通常提升几十倍,同时可以直接得到Arrow格式的内存表,配合Pandas的__arrow_array__协议,数据转换的开销也极低。
更具体一点,建议的做法是:
- 用pyarrow读取原始数据成Arrow Table
- 用
to_pandas转换成DataFrame,开启self_destruct参数释放原始Arrow内存 - 回测引擎基于列级操作构建信号,避免逐行遍历
这套路径在多数机器上处理一天的tick数据,耗时可以从分钟级降到秒级。
并行读取多天数据突破单线程瓶颈
单日tick数据量有限,但回测动辄需要数月甚至数年的数据,逐个文件串行读取的效率完全取决于磁盘性能,并行化是突破这个限制的有效手段
。
Python可以用concurrent.futures.ProcessPoolExecutor做多进程并行读取:
- 每个进程独立读取一个文件或一天的数据,解析成统一格式
- 主进程用
as_completed收集结果,按时间顺序合并 - 进程数量设定为CPU物理核心数的两倍以内,避免过度争抢I/O带宽
需要注意,并行读取的效果在机械硬盘上提升有限,但在SSD/NVMe环境下收益非常明显因为现代固态硬盘本身具备并发吞吐能力。
预处理成中间格式减少重复负担
回测调试一般要经历参数调整、数据范围修改、因子验证等迭代流程,每次迭代都从原始数据开始解析,浪费了大量时间。
建议在首次解析完毕后持久化为中间格式,比如写入Parquet或Feather,后续的回测直接加载中间格式,不再触碰原始数据,这一步操作简单,效果却是数倍的提速。
一个可复用的处理流程是:
- 检查本地缓存目录是否存在目标合约、目标日期的parquet文件
- 存在则直接读取,不存在则解析原始数据并写入缓存
- 回测引擎只面向统一的parquet接口,屏蔽底层差异
用这套方案,即便原始数据是各种不同的tick格式,上层回测逻辑也能保持稳定。
回测框架层面的数据读取优化
除开存储格式和读取方法,回测框架本身的架构设计也对数据读取效率有举足轻重的影响。
按需加载代替全量预载
很多回测框架为了简化逻辑,在回测开始时把所有标的数据一次性载入内存,这种做法在标的数量少、周期长的场景下可行,但tick级别的全量预载会让内存占用飙升到不合理的程度。
更好的方式是按需加载策略运行到哪个时间窗口,就只加载那个窗口的tick数据,通过做一个滑动窗口的惰性加载模块,框架可以自动在策略前进时读取后续数据,在回退时丢弃过期数据块,内存占用控制在固定范围内,回测速度反而更快。
因子计算和回测主循环解耦
tick级数据上的因子计算是最耗时的操作之一,因为涉及滚动窗口统计、逐笔状态更新等复杂计算,如果跟回测主循环混在一起,每调整一次参数都要重新跑一遍全部因子,效率非常低。
合理的架构是:
- 离线预计算因子序列并存储,回测时直接读取因子值
- 因子计算定期重算(比如每日收盘后),而不是每次回测都触发
- 回测主循环只聚焦于信号产生和组合管理,数据读取复杂度大幅降低
这套解耦思路在实盘和回测共用一套代码时尤其划算,因为离线的因子计算在实盘中本来就是必须的。
避免数据复制,用引用传递
Pandas的DataFrame切片操作默认是视图,但很多情况下误触发复制,比如对DataFrame做chain indexing(如df[df['volume']>100]['price']),就会产生不必要的内存拷贝。
建议在数据预处理后,使用pd.array或NumPy数组承载核心序列数据,并用索引数组传递数据而不是每次赋值,tick数据量大,任何一次多余的数据拷贝都会显著拉长回测总时长。
读取性能对照速查表
为了便于实操选型,下面给出常见存储及读取方式的适用场景对比:
| 方案 | 适用数据量 | 读取速度 | 实现成本 |
|---|---|---|---|
| CSV逐行读取 | 单日小样本 | 极慢 | 最低 |
CSV + pd.read_csv |
数日tick | 中等 | 低 |
| Parquet列式读取 | 数月tick | 快 | 中 |
| mmap内存映射 | 内存容量内 | 极快 | 中 |
| ClickHouse数据库 | 多年全市场 | 快,有网络开销 | 高 |
文中核心要点小结
存储格式选列式、读取方式走批量、加载策略用按需、因子计算做离线,这四点环环相扣,构成了tick级回测数据优化的完整拼图,量化开发人员耗费在读数据上的时间,完全可以通过这套组合拳缩短到原来的零头。
Q&A:量化回测tick数据报错处理
问:tick数据中的时间戳格式不统一,pandas解析非常慢怎么办?
答:避免使用pd.to_datetime自动推断格式,改用format参数显式指定,速度能提升数倍,如果数据量巨大,直接在pyarrow读取时用convert_options指定时间列的类型,省去pandas层面二次转换。
问:并行读取tick数据后,数据顺序乱了怎么办?
答:让每个进程在返回结果时附带文件起止时间或序列号,主进程合并前按此排序,也可以按日期分批并行,保持单日内顺序天然有序,跨天合并时按日期递增拼接即可。
问:回测经常只需要某只合约在某个时间段的数据,每次都全量读入太浪费了,如何精准读取?
答:利用Parquet的分区特性,按合约代码和交易日期做目录分区,读取时用pyarrow的filters参数指定目标分区,这样引擎只扫描符合条件的文件,从根本上规避全量扫描的I/O开销。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/632311.html