Kubernetes滚动更新不停机的核心,是让新旧两个ReplicaSet短暂共存,新Pod逐个通过就绪检查后接管流量,旧Pod再逐个退出。 用户看到的服务始终在线,请求在NewPod和OldPod之间平滑交接,这中间靠的不仅是Pod数量的增减,还有Service的标签选择器和探针的精细配合。
下面从工作机制、参数设置、发布策略对比、实操命令、故障排查五个维度,把滚动更新这件事讲透。

滚动更新的交接班机制:新队列先进,老队列后退
滚动更新不是把旧Pod全部杀掉再启动新Pod,而是“边进边退”,理解这一点,先要弄清楚ReplicaSet、Service和探针各自扮演的角色。
ReplicaSet是真正的执行者
Deployment本身不直接管理Pod,它管理的是ReplicaSet,每次滚动更新,Deployment都会创建一个新ReplicaSet,期望副本数从0开始增长,同时旧ReplicaSet的期望副本数按比例下降。
举个例子:一个Deployment运行3个旧Pod,发起滚动更新后,控制器先把新ReplicaSet的副本数从0提升到1,新Pod创建成功并Ready后,再把旧ReplicaSet的副本数从3降到2,整个过程重复执行,直到新ReplicaSet为3、旧ReplicaSet为0,这种“先增后减”的顺序,保证了任意时刻集群内可用的Pod总数不低于期望值。
Service只认标签,不认识新旧版本
Service通过selector选择Pod,只要是符合标签条件的Pod,就会被纳入Endpoints列表,滚动更新时,新旧Pod共享同一个app标签,只是pod-template-hash这个哈希值不同,所以Service的标签选择器不会把新Pod排除在外。
关键点在就绪状态,新Pod只有通过readinessProbe探针检查后,才会被加入Service的Endpoints,流量才会转发过去,旧Pod从开始终止到真正销毁,也存在一个窗口期:它先从Endpoints中移除,然后收到SIGTERM信号,执行preStop钩子,最后退出,Kubernetes利用这个时间差,让新旧Pod的流量交接平滑完成。
readinessProbe是唯一的上岗凭证
进程启动成功不等于可以接收流量,很多应用容器起来后还需要加载配置、建立连接池、预热缓存,这几秒到几十秒内如果强行接入流量,必然产生5xx错误,readinessProbe的作用就是持续探测新Pod是否“准备好”:探测失败就继续等,探测成功才把Pod加入Endpoints。
业内专家指出,生产环境发布事故中相当一部分不是因为新版本代码有问题,而是readinessProbe配置太宽松,新Pod一启动就被打流量,真实业务还没就绪。 建议配合minReadySeconds使用,让Pod进入Ready状态后再稳定观察一段时间,再继续滚动后续批次。
Kubernetes滚动更新与蓝绿发布区别在哪
很多团队纠结发布策略选滚动更新还是蓝绿发布,两者目标都是不停机,但设计思路完全不一样。
| 对比维度 | 滚动更新 | 蓝绿发布 |
|---|---|---|
| 资源占用 | 只需额外运行一小批新Pod | 需要同时运行两套完整环境 |
| 发布耗时 | 分批进行,几十秒到几分钟 | 新环境就绪后切换流量,耗时较短 |
| 回滚速度 | 需再次滚动更新,回到旧版本 | 流量切回绿环境,秒级完成 |
| 对外的IP/域名 | 不变,Service统一代理 | 不变,通过负载均衡切换 |
| 成本 | 较低,尤其适合大集群 | 较高,资源翻倍 |
| 适用场景 | 大多数Web服务、微服务 | 对回滚速度要求极高的核心交易链路 |
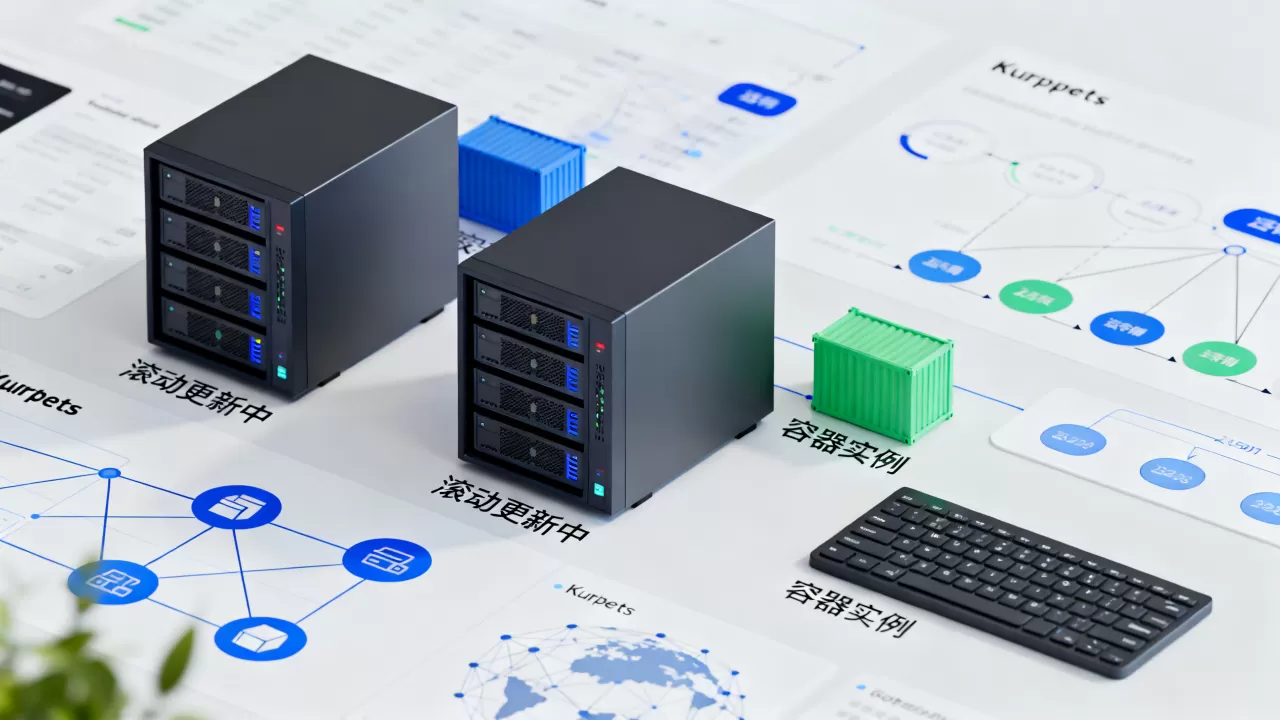
蓝绿发布最舒服的地方是回滚快:新环境只要有一丁点异常,流量直接切回旧环境,不具备做半个小时的滚动回滚,代价是成本,需要准备两套独立的资源池,这在大规模场景下费用相当可观。
滚动更新则是“细水长流”,用更少的额外资源换取平滑升级,国内云厂商的Kubernetes托管版,比如简米云ACK、酷番云TKE,控制台默认创建的Deployment走的就是滚动更新策略,大多数生产业务用默认配置就能跑得很好。
Kubernetes滚动更新参数maxSurge和maxUnavailable怎么设置
这两个参数是控制滚动更新节奏的阀门,很多人在yaml里见过却不敢动,其实理解了含义就很简单。
maxSurge:允许超出期望副本数的最大数量
maxSurge可以设整数或百分比,设为25%,意味着3副本的应用最多可以同时跑4个Pod,多出来的那个名额专门给新Pod用,设为0则不允许超出,新Pod只能等旧Pod删掉一个才能创建,发布速度会明显变慢,但资源占用最严格。
maxUnavailable:允许不可用Pod的最大数量
这里说的“不可用”是指处于NotReady或Terminating状态的Pod,默认25%,3副本应用最多允许1个Pod短暂不可用,剩余2个Pod仍继续提供服务,设为0则表示任何时刻都不能有Pod掉线,每个Pod都要先有新Pod接替,安全性最高但发布最保守。
典型场景的参数参考值
| 场景 | maxUnavailable | maxSurge | 效果 |
|---|---|---|---|
| 大多数生产环境 | 0 | 25%或1 | 先建新Pod再接流量,确保在线率 |
| 快速发布 | 25% | 25% | 短暂允许少量Pod不可用,速度快 |
| 资源紧张的集群 | 25% | 0 | 不额外占资源,逐步替换 |
| 关键交易链路 | 0 | 0 | 严格先加后减,发布最慢但最稳 |
行业共识认为,多数生产环境建议maxUnavailable设为0,让新Pod先就绪再接流量,宁可发布慢一点,也不让用户请求发生断档。 如果业务流量有明显波峰波谷,可以在低峰期将maxSurge临时调大,用批间“冲刺”的方式缩短发布窗口。
滚动更新实操:从触发一次发布到回滚
理论讲完,直接看命令,下面以nginx镜像从1.24升到1.25为例。
触发滚动更新
kubectl set image deployment/nginx nginx=nginx:1.25
也可以直接编辑Deployment:
kubectl edit deployment/nginx
修改spec.template.spec.containers.image字段,这里的核心原则:必须变更Pod模板中的任意字段,Deployment才会感知到更新,进而触发滚动更新,只改副本数不会滚动。
查看发布进度
kubectl rollout status deployment/nginx
该命令会实时输出滚动过程,Waiting for deployment spec update to be observed…”“Waiting for rollout to finish: 1 out of 3 new replicas have been updated…”,全部完成会输出“deployment successfully rolled out”。
查看历史版本
kubectl rollout history deployment/nginx
每一行对应一个版本号,可用kubectl rollout history deployment/nginx --revision=2查看指定版本的详细信息。
回滚到上一版本
kubectl rollout undo deployment/nginx
带版本号回滚:
kubectl rollout undo deployment/nginx --to-revision=2
回滚本身也是一次滚动更新,同样受maxSurge和maxUnavailable参数约束,也具备不停机特征,如果代码变更导致新Pod一直无法Ready,回滚前滚动更新会卡住,kubectl rollout undo会终止当前的推进过程并开启反向滚动。
暂停与恢复
kubectl rollout pause deployment/nginx
kubectl rollout resume deployment/nginx
暂停后,对Deployment的Pod模板修改不会触发滚动更新,适合在灰度阶段验证一小批新Pod的日志和指标,确认没问题再恢复。
Kubernetes滚动更新不生效或卡住是什么原因
实际操作中,滚动更新不会每次顺风顺水,下面几个问题在生产环境最常见,按排查顺序列出。
镜像没换,版本号没变
这是最容易被忽略的,Deployment的镜像地址从nginx:1.25改成nginx:1.25,Pod模板内容没有任何变化,控制器会认为无需滚动更新,即便你改了镜像仓库里的Tag内容,如果imagePullPolicy设为IfNotPresent且节点本地已有同名镜像,新Pod也会直接复用本地镜像,跑的还是旧代码。
排查方式:查看Deployment的yaml确认imagePullPolicy,必要时改成Always,或者给镜像打一个新Tag。
新Pod一直Pending,滚动卡住
如果新Pod创建后一直处于Pending状态,多半是节点资源不足,maxSurge额外创建的Pod找不到足够的CPU或内存,调度器无法分配节点,经典参数kubectl describe pod <new-pod>
里会显示“0/3 nodes are available: 1 Insufficient cpu, 2 Insufficient memory”之类的调度事件。
排查方向:
- 查看集群节点资源水位:
kubectl top nodes - 查看Deployment的requests和limits是否合理
- 确认是否有其他工作负载抢占资源
readinessProbe探测失败,新Pod永不Ready
新Pod能启动但始终不Ready,流量也一直打在旧Pod上,看起来像“发布没反应”,这大概率是新版本应用的健康检查路径变了,或者监听端口不对,探针返回非200状态码。
排查方式:
- 执行
kubectl get pods查看状态列,会显示“0/1 Running”或容器处于Running但NotReady - 查看
kubectl describe pod <new-pod>的Events部分,通常会给出Liveness/Readiness探针失败的详细原因 - 手动进入Pod执行
curl验证健康检查端点:kubectl exec -it <new-pod> -- curl localhost:8080/healthz
发布超时,显示ProgressDeadlineExceeded
Deployment有一个progressDeadlineSeconds字段,默认600秒,如果一次滚动更新在10分钟内没有取得任何实质进展,Deployment会进入ProgressDeadlineExceeded状态,触发这个状态并不代表服务挂了,而只是控制器认为这次发布“卡住了”,需要人工介入查看原因。
处理办法:先定位上述三类原因,修复后控制器会继续推进发布过程,无需重新触发。
滚动更新从来不是Kubernetes的“黑魔法”,它依赖ReplicaSet的精确数量控制、Service的动态标签匹配和readinessProbe的严格准入,三元配合才实现了新旧版本的丝滑交替,掌握maxSurge和maxUnavailable的调参逻辑,再配上一套合理的探针配置,大部分生产环境发布业务都能做到真正的零停机。
关于Kubernetes滚动更新,这些疑问你也会遇到
滚动更新期间,请求会不会发生中断?
正常情况下不会,新Pod必须在readinessProbe探测成功后才会被加入Service的Endpoints列表,流量才会转发过去;旧Pod在终止前先从Endpoints移除,再进入SIGTERM终止流程,加上maxUnavailable限制不可用Pod数量,整个过程中始终有Pod处于Ready状态并承接流量。
为什么滚动更新后Pod的IP全变了,服务却没有断过?
因为Service对外提供的ClusterIP、DNS域名在滚动更新前后一直没有变化,Pod的IP变化属于集群内部事件,Service通过selector和后端Endpoints动态感知Pod的加入和移除,客户端始终访问Service的稳定入口,不感知后端Pod的具体IP。
滚动更新失败后,服务是否还能继续正常访问?
如果旧Pod运行正常,新Pod因镜像错误或探针失败无法Ready,旧Pod不会立刻被删除,滚动更新会暂停在某个状态,旧Pod继续承担全部流量,可执行kubectl rollout undo deployment/nginx回滚到上一个可用版本,回滚过程本身同样具备不停机特性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e5%a6%82%e4%bd%95%e8%ae%a9kubernetes%e6%bb%9a%e5%8a%a8%e6%9b%b4%e6%96%b0%e4%b8%8d%e5%81%9c%e6%9c%ba%e5%8f%91%e5%b8%83%e6%96%b0%e7%89%88%e6%9c%ac%ef%bc%8ck8s%e6%bb%9a%e5%8a%a8%e6%9b%b4%e6%96%b0/