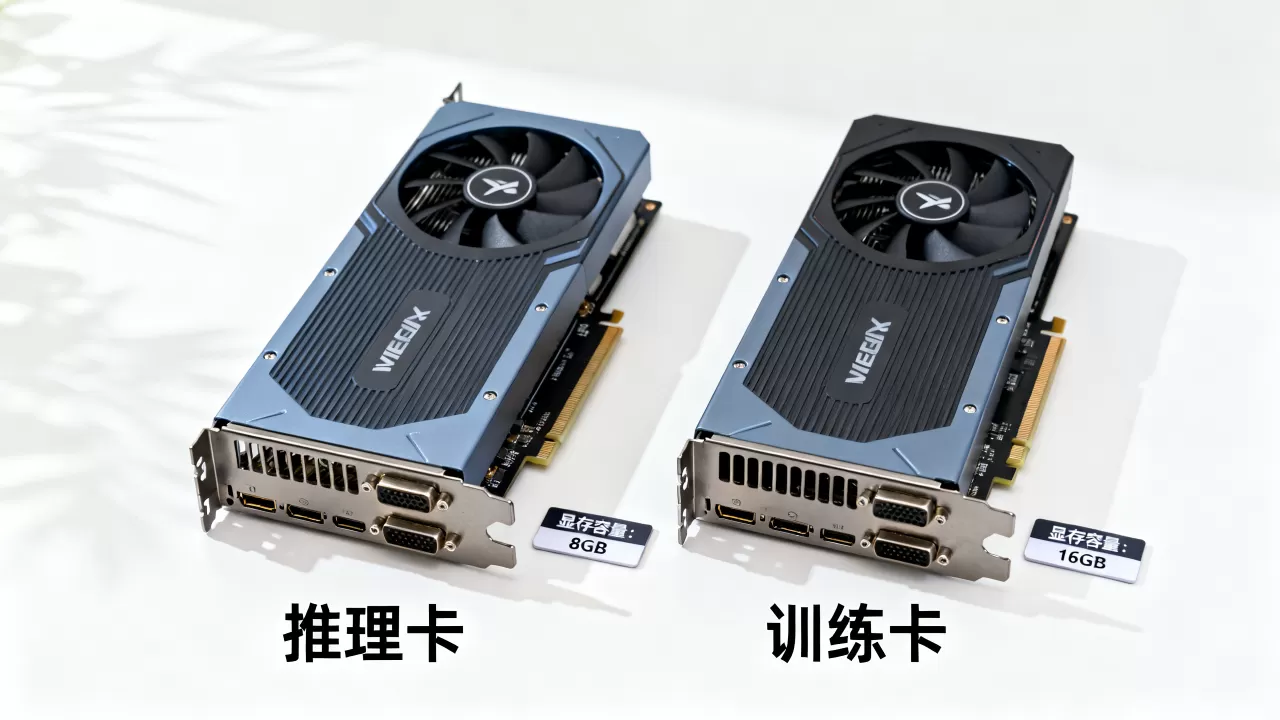
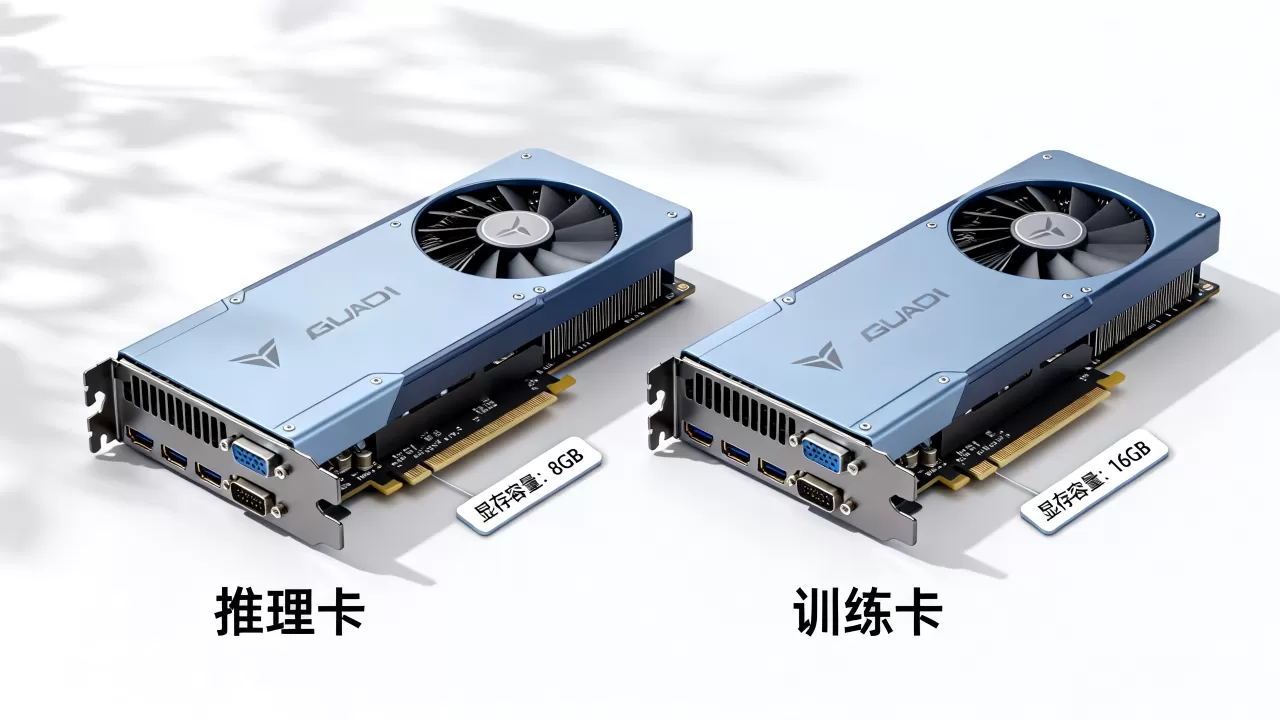
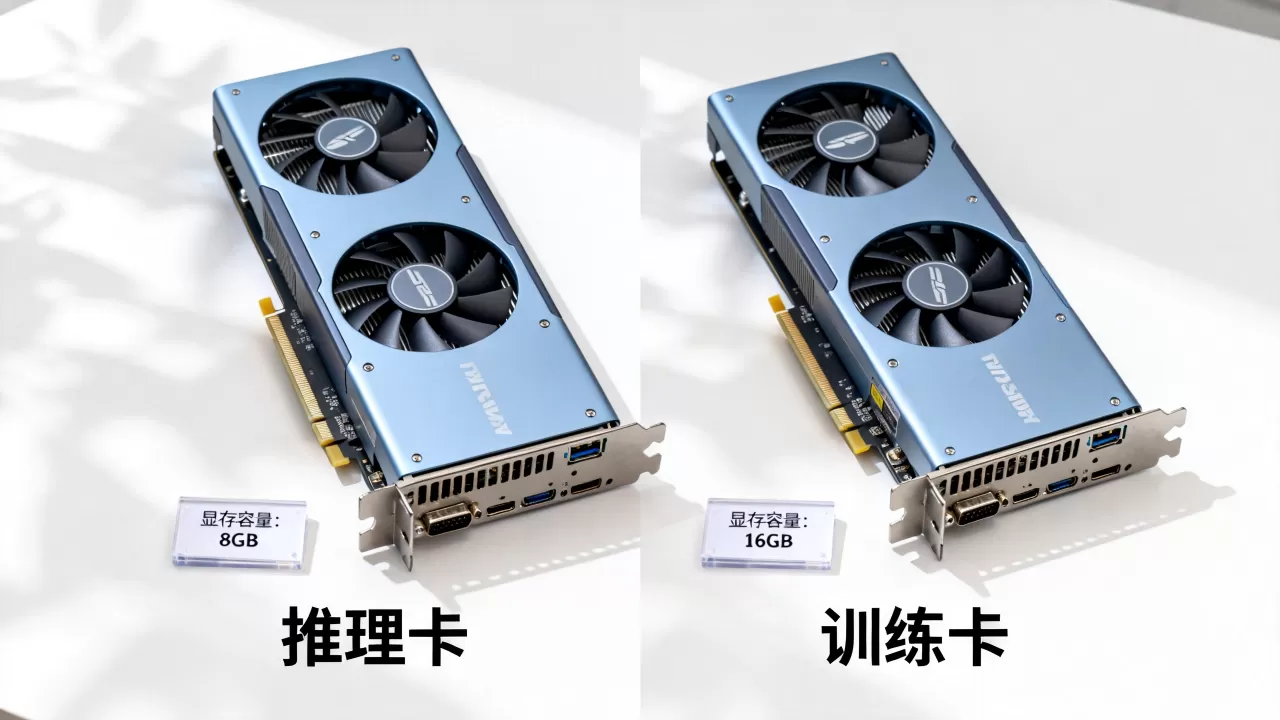
推理卡与训练卡的显存容量选择逻辑截然不同,推理场景更注重容量与带宽的匹配、并发批处理能力以及单位成本承载的吞吐量,而不是单纯追求大容量。训练卡需要在显存中同时存放权重、梯度、优化器状态和中间激活值,容量不够直接导致训练中断;推理卡只需存放权重和KV Cache,但在线服务的延迟和吞吐要求决定了显存必须刚好卡在性价比拐点上,以下内容从需求差异、场景拆解、选型实操三个层面展开。
为什么推理卡与训练卡在显存容量上的选择逻辑相反
训练和推理的计算模式决定了显存资源的消耗方式完全不同,这个底层差异直接影响了选型方向。
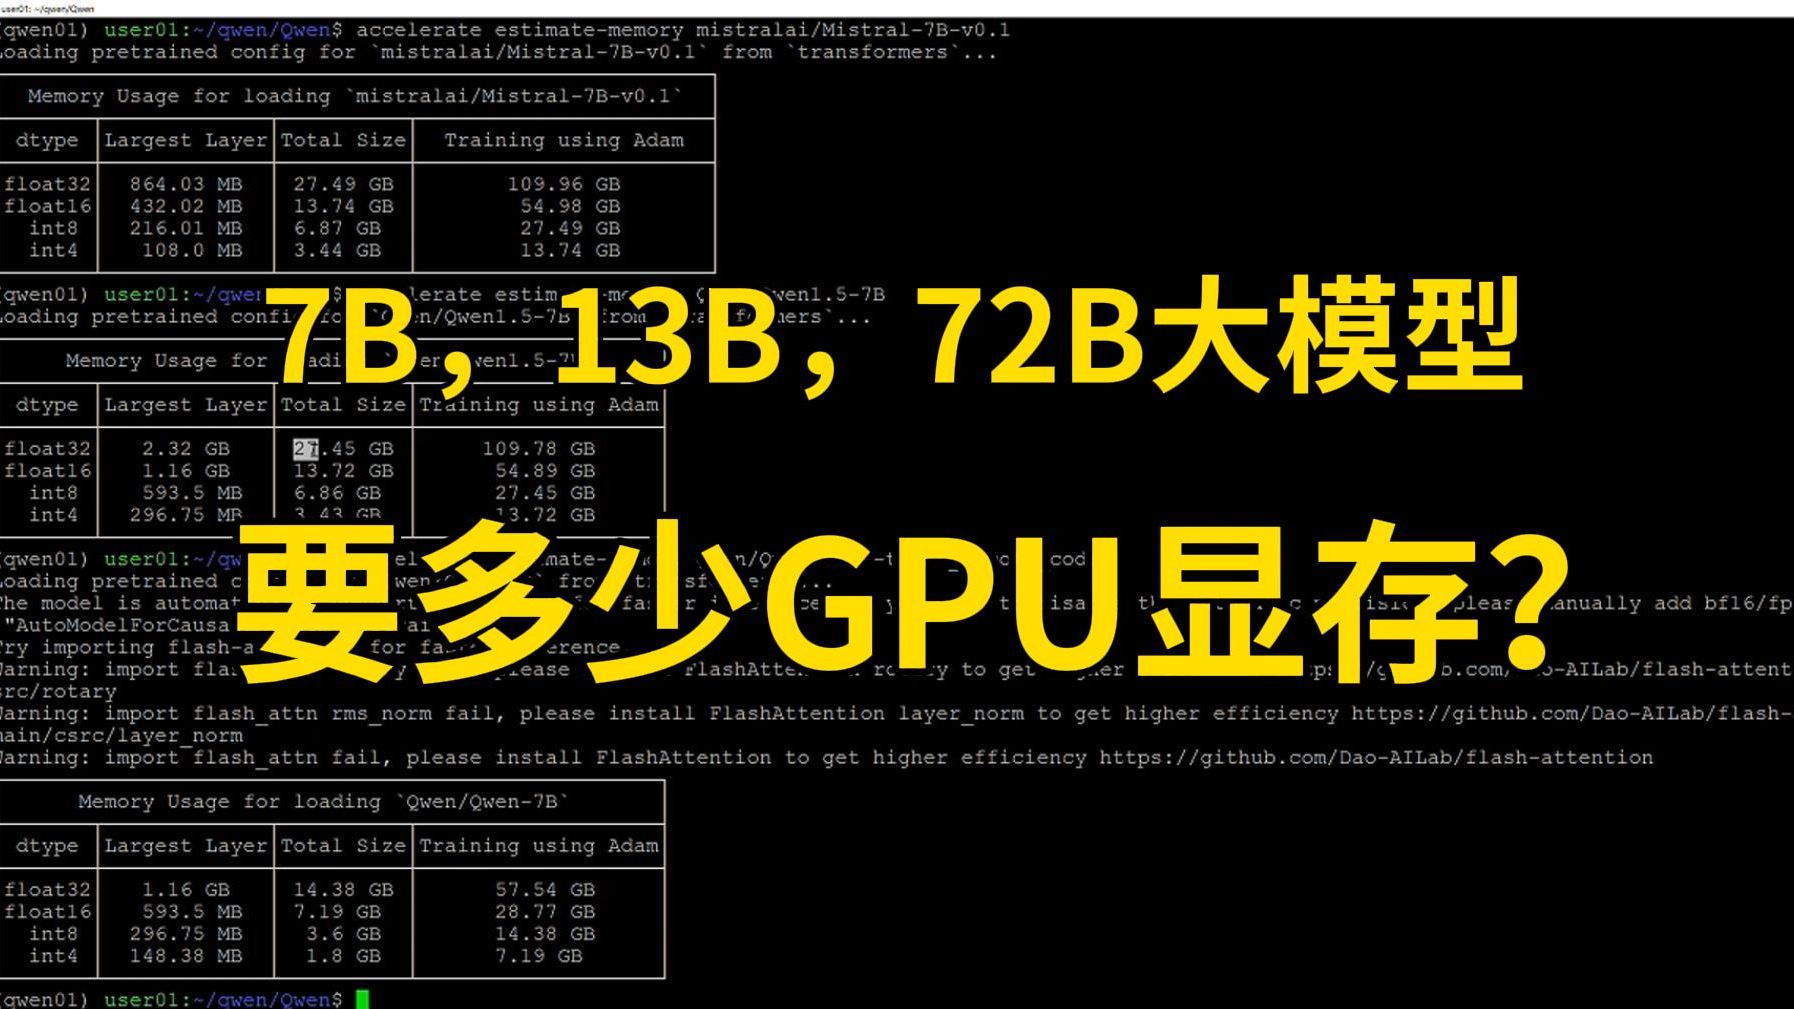

训练卡显存消耗的几个大头
训练过程中显存消耗项包括:
- 权重参数,模型本身的参数占用的空间,以FP16为例,7B模型约14GB,70B模型约140GB
- 优化器状态,Adam优化器需要额外存储动量,Variance等数据,这部分显存占用通常是权重的2-3倍
- 梯度数据,反向传播过程中需要存储每个参数的梯度值
- 中间激活值,前向传播时各层的激活输出,这部分数量取决于批次大小batchsize和序列长度
这就是为什么训练卡总是倾向于把显存堆得越大越好,训练场景中显存不足可以用梯度累积、混合精度、激活重计算等手段,但代价是训练速度大幅下降,行业共识认为训练场景下显存属于紧缺资源,多出来的容量几乎总能转化为更快的迭代速度。
推理卡显存需求的主次顺序
推理阶段没有反向传播和优化器状态,显存消耗结构变了:
- 权重参数仍是主要开销,但可以量化压缩到INT8甚至INT4,所需空间大幅缩减
- KV Cache随着并发请求和序列长度动态增长,这是推理独有的存储项,多请求并发时特别占空间
- 中间激活值相比训练时小得多,而且推理时逐token输出,不需要缓存完整的前向结果
推理卡显存需求的规律是:容量够用即可,多出来的部分不直接等于更高性能,比如一张24GB显存的消费级卡跑7B量化模型延迟可能跑进30毫秒内,但换成80GB的专业卡,如果只跑单路低并发请求,延迟提升有限,价格却翻了好几倍。
推理卡显存容量怎么选才不浪费预算
这是推理场景中最核心的选型问题,关键因素有三个:
- 目标并发数,单卡同时处理多少个请求,推理服务部署时confcurrency参数直接和KV Cache总量挂钩
- 模型规格和量化精度,FP16的14GB和INT4的约4GB所需容量完全不同
- 服务水平协议SLA要求,延迟上限决定了batchsize能开多大,因为批量推理虽然吞吐高但单请求延迟也会变长
实际选型时先算一笔账:显存总容量减去固定权重占用量,剩余部分除以每条请求的KV Cache消耗值,就得出了理论并发上限,如果这个数字远高于业务实际需求,说明显存买过剩了,不如把钱花在更高带宽的卡上。
推理场景下显存容量与带宽的协同关系
推理卡显存容量和显存带宽之间存在一个平衡点,只看容量忽视带宽会让大显存卡跑不出应有的性能。
为什么推理卡比训练卡更依赖带宽
推理是访存密集型任务,每个token的生成都要从显存中完整读取一次权重数据,70B模型FP16权重有140GB,每生成一个token就要把这140GB从头到尾读一遍,显存带宽决定了这个过程有多快。
具体数据感受一下:一张卡带宽2TB/s,读取140GB需要70毫秒,这还没算计算时间;如果换高带宽卡,比如带宽超过3TB/s,光读取环节就能省下三分之一时间,训练卡虽然也需要带宽,但计算时间占比更高,带宽对整体耗时的影响没有推理那么明显。
行业共识认为推理卡选型时,带宽应排在容量前面,多花预算把带宽从2TB/s提到3TB/s,带来的延迟改善比把容量从48GB提到80GB更直观。
显存容量和带宽搭配的几个实际案例
不同的部署规模对应不同的搭配策略:
- 单卡跑中小模型(7B-13B量化后):24GB容量的卡配400GB/s以上带宽即可,瓶颈通常在算力而非显存
- 单卡跑大模型低并发(70B量化INT4):48GB容量配800GB/s带宽,权重占了约35GB,剩下的空间刚好支撑个位数并发
- 多卡并行跑超大模型:每张卡容量大于等于量化后权重分片大小,带宽要保证卡间通信不拖后腿
这里有个容易踩的坑:有人在48GB显存卡上部署70B INT4模型,权重占约35GB,KV Cache只有13GB可用,并发稍微上去点显存就爆了,这种情况下要么换更大容量卡,要么限制最大并发数,反过来用吞吐换稳定性。
按业务类型圈定容量区间
不同业务类型对推理卡显存容量的敏感度差异巨大:
- 在线实时对话(ChatBot类):延迟要求较高,单请求延迟控制在2秒内,需要小batchsize,显存容量满足权重+少量KV Cache即可,核心在带宽
- 离线批量处理(数据清洗、批量内容生成):不要求低延迟,可以把batchsize拉大提高吞吐,这时KV Cache总量会线性增加,可选容量更大一点的卡
- 边缘端推理(车载、工控):受功耗和体积限制,容量只能紧着模型权重来,量化精度优先
推理卡为什么显存容量不宜盲目对齐训练卡
很多初次采购的人会用训练卡的习惯来选推理卡,结果买回来才发现利用率很低,容量和真实需求不匹配。
数据并行与张量并行的容量分配差异
训练大模型跑数据并行时,每张卡存一份完整的模型副本,多卡加起来相当于存了好几份权重,推理场景通常跑张量并行,模型权重被切分到多张卡上,每张卡只存一个分片,这意味着推理多卡部署时,单卡容量要求反而比单卡部署低一些。
70B模型FP16权重约140GB,单卡跑不下,四卡张量并行每张卡只需存35GB权重,加上KV Cache,48GB容量的卡就足够用了,但同型号卡跑训练数据并行,每张卡都得塞下完整的140GB,48GB根本不够,两种并行模式的容量需求差异造成推理卡上48GB可能够用,训练卡上连入门门槛都没到。
推理卡单卡多模型部署的容量规划
小流量场景有个省钱的玩法:在单张推理卡上部署多个不同模型,比如一张48GB显存卡并行跑三个INT8量化的7B模型,每个模型权重约占8GB,三个模型24GB,剩下24GB分给各自KV Cache,相当于一张卡干三份活。
这种部署方式对显存容量上限有要求,但不追求大,而是追求刚好塞下多个模型且互不干扰,显存不够时可以动态卸载空闲模型,显存利用率比训练场景高不少。
推理卡显存容量怎么看才更科学
评估推理卡显存容量是否合适,可以按以下步骤操作:
- 拿到模型的参数量N(单位B,即十亿参数)
- 计算模型权重占用,比如FP16约N乘以2GB,INT8约N乘以1GB,INT4约N乘以0.5GB
- 估算KV Cache总量,公式大致是并发数乘以序列长度乘以层数乘以注意力头数乘以每个头的维度乘以2字节再乘以量化系数,实际操作中可以用推理框架的显存分析工具一键导出
- 权重占用加上KV Cache的峰值需求,乘以1.2到1.3的安全冗余系数,就是单张推理卡的需求下限
比如7B模型跑INT8量化,峰值并发32路,序列长度2048,KV Cache算出来大约占6-8GB,权重7GB左右,合计15GB,加上冗余24GB容量的卡就够了,完全不需要40GB以上的大显存卡硬上。
不同显存容量的推理卡适用什么部署场景
显存容量大小决定了推理卡能承载的模型规模和并发水平,以下梳理常见的容量档位对应场景。
| 显存容量档位 | 可承载模型建议 | 典型部署场景 | 容量优势 |
|---|---|---|---|
| 24GB-32GB | 7B-13B量化后 | 中小规模API服务,边缘节点 | 性价比最佳,单卡成本可控 |
| 40GB-48GB | 70B INT4或30B FP16 | 生产环境主力推理节点 | 容量和价格较均衡 |
| 80GB及以上 | 70B FP16或更大模型 | 高并发在线服务,超大模型需多卡 | 容量冗余充分,适合多路复用 |
企业部署推理卡显存容量配置的真实需求
企业实际采购时,推理卡的显存容量决策因素包括:
- 现有模型的参数量是定死的,按模型权重推算容量下限不会出大错
- 业务峰值流量决定并发上限,这部分用冗余容量兜底,但没必要留太多,推理服务一般都有排队机制
- 数据增长速度会影响KV Cache占用量,短期可预见范围内多预留两成空间足够
运营级推理服务通常把显存利用率目标定在60%-80%之间,低于这个水平说明卡买大了,高于这个水平说明容量偏紧随时可能OOM。
推理卡显存容量和价格之间的平衡方法
预算有限时有一个推荐的处理顺序:
- 先满足模型权重的容量最低需求,这个没法妥协,否则服务根本跑不起来
- 再满足目标并发数的KV Cache需求,这决定体验上限
- 剩余预算优先投资显存带宽而不是容量
- 假如还有预算富余,再考虑容量上探,为未来模型迭代留余地
推理卡的显存容量规划本质上是一个资源换算问题,容量够用之外每多一GB都要重新算一遍投资回报率。
国产推理卡显存容量选择上的特殊考量
近年来国产推理卡在市场上占比逐步提升,选型逻辑有些地方和主流卡不太一样,值得单独说明。
国产推理卡显存容量受限带来的替代策略
部分国产推理卡单卡显存容量相比头部产品还有差距,但可以通过集群方式弥补,部署这类卡时容量规划遵循以下原则:
- 一个较大模型在单张国产卡放不下时,优先用张量并行把模型切片分配到多张卡上,每张卡只需容纳权重分片和对应KV Cache
- 量化精度要合理设置,容量不够时优先考虑INT8量化,其次是INT4,但要注意精度损失,金融、医疗场景慎重
- 国产卡之间的互联带宽也是选型参考因素,卡间通信和显存带宽共同决定实际部署效果
业内专家指出国产推理卡的显存容量虽然普遍低于国外旗舰产品,但推理场景对容量需求相对温和,用模型并行和量化来适配,多数业务场景实测性能差距可控。
国产推理卡推理并行方案对显存容量的改善
看到有团队用国产推理卡跑70B量化模型的成功案例,核心思路就是打通流水线并行和张量并行的组合部署,按层切分叫流水线并行,每张卡只承担部分层的计算和存储;按维度切分叫张量并行,每层分散在多张卡上,两种方式结合后,单卡48GB跑70B INT4基本够用。
多卡并行时注意每张卡实际可用的显存没那么大一部分要给通信缓冲区留位置,卡数多了以后通信开销也不容忽视,通常8卡并行时每张卡的缓存在预留超出理论值10%到15%最稳妥。
推理卡与训练卡显存容量相关常见问题
推理卡显存容量不足会导致什么现象?
显存不足时推理服务通常不会直接报错,而是表现为并发能力骤降,比如45%并发时报OOM错误,服务自动拒绝新请求,用户侧感知就是延迟飙升和稳定性下降,另一种常见表现是吞吐量先升后降,显存逼近上限后KV Cache被迫频繁换入换出,整体效率反而大幅低于低并发状态。
推理时用大batchsize真的能显著提高吞吐吗?
在推理卡显存容量有富余时,增大batchsize确实能提高整体吞吐,因为权重读取开销被多个样本分摊了,但batchsize增加会线性推高KV Cache占用量,容量不足时得把batchsize降回来,所以推理场景优化吞吐优先考虑容量够不够装下目标batchsize的KV Cache,而不是无脑调大batchsize。
推理卡显存容量一半都用不满算浪费吗?
这要分情况看,如果位置预留是给未来业务增长兜底的,多留空间不算浪费,如果是长期低利用率且流量模型稳定,那确实可以考虑换更小容量的卡,省下成本放在CPU节点或存储上,行业共识认为推理服务的容量规划不应该追求每个时刻都用满,能够从容应对两倍流量峰值的缓冲属于合理冗余。
显存容量在选择推理卡时只是一道及格线而非加分项,通过及格线之后真正影响服务质量和采购决策的变量变成了显存带宽和单位容量的并发承载能力,训练卡向大容量看齐的逻辑若不加以修正直接套用,很容易买来一台参数亮眼、实测吞吐却不尽人意的推理节点,回到选型起点,先在业务场景清单里写清楚并发数、延迟红线、序列长度和模型精度,按这个公式把容量算到刚刚好的区间,那个值就是推理卡显存容量的最优解。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e6%8e%a8%e7%90%86%e5%8d%a1%e4%b8%8e%e8%ae%ad%e7%bb%83%e5%8d%a1%e5%9c%a8%e6%98%be%e5%ad%98%e5%ae%b9%e9%87%8f%e4%b8%8a%e7%9a%84%e9%80%89%e6%8b%a9%e5%b7%ae%e5%bc%82/