推理批量大小直接决定GPU计算单元能否被充分喂饱,调大batch size通常是提升GPU利用率最直接、成本最低的手段,但它并非越大越好,显存上限和延迟要求共同画出了天花板。
为什么GPU利用率会卡在batch size上
很多人盯着nvidia-smi里跳动的百分比,以为是显卡不行或者代码写得差,相当一部分“利用率上不去”的问题,根源就在推理批量大小这一个参数上,你可以把GPU想象成一个流水线非常长的超级工厂,如果一次只送一件原料进去(batch size=1),工厂里再多的工人(CUDA核心)也得等着这件原料走完全部工序才能开工下一件,中间大量算力空转,利用率自然惨淡,当批量大小从1加到8、加到16,意味着同一时间有8件或16件原料并排在流水线上流动,每一个环节都能满载运转,吞吐量成倍增长。
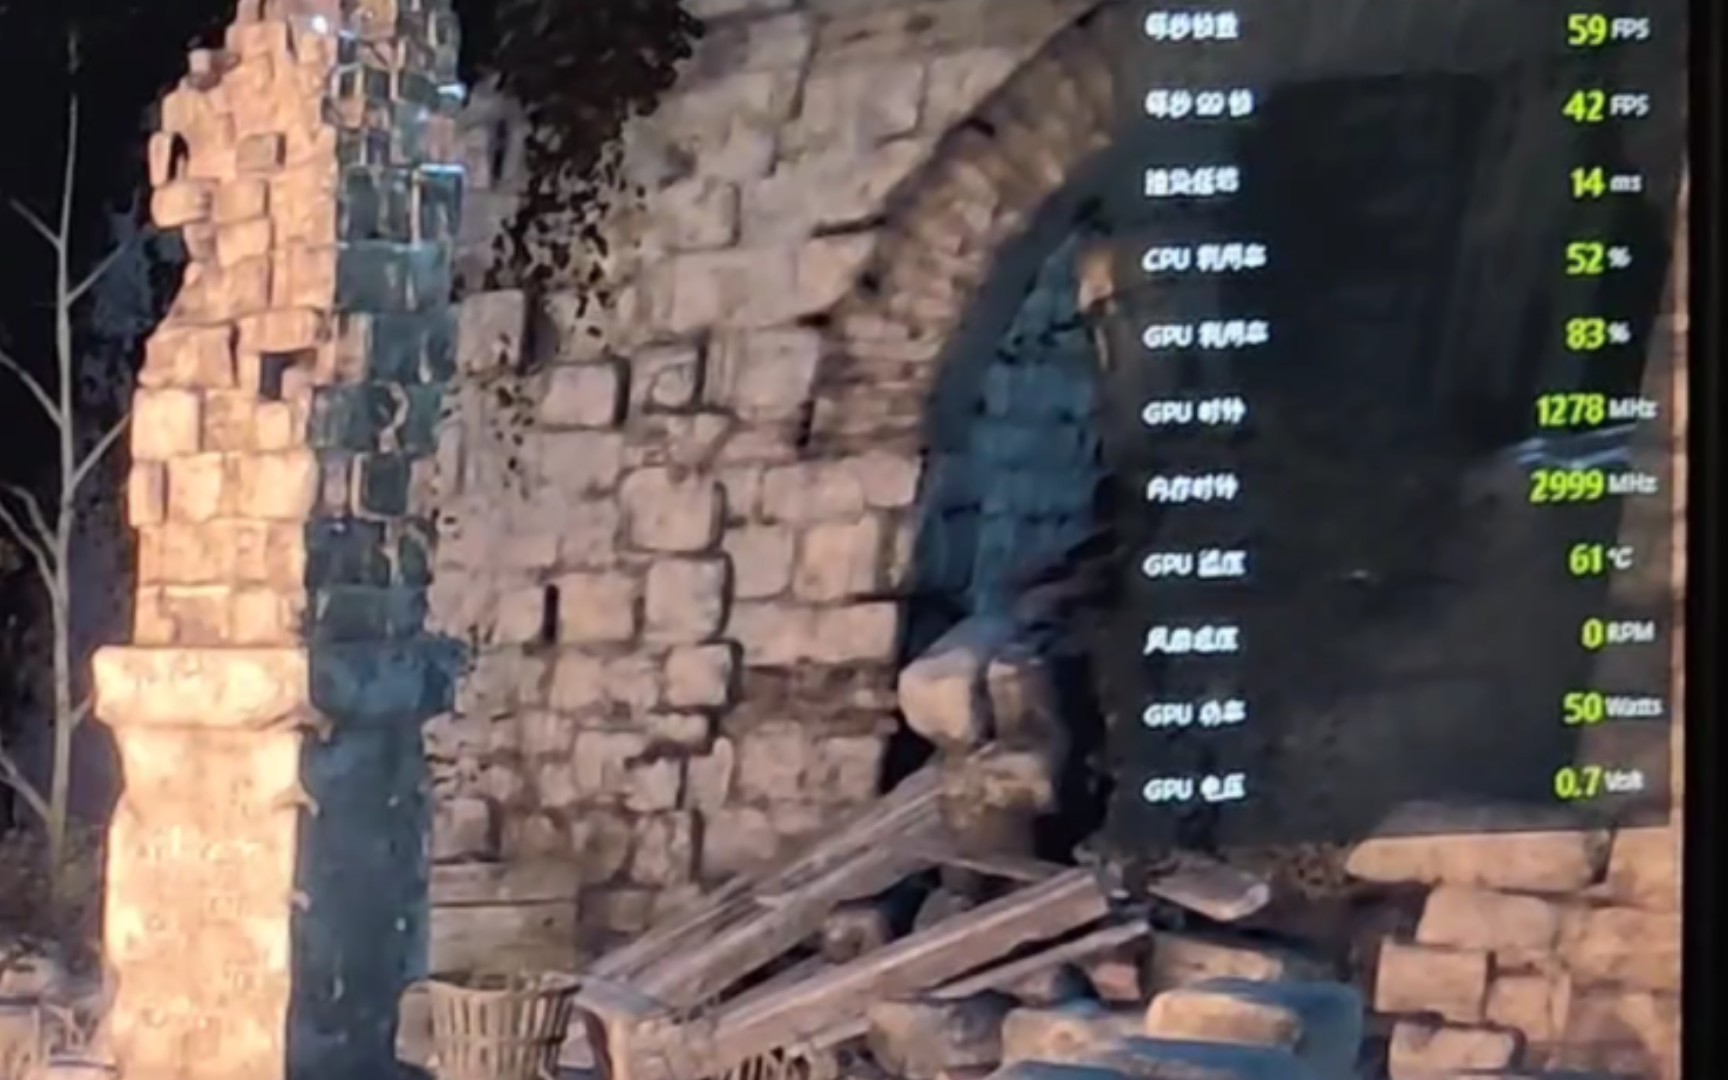

行业共识认为,在绝大多数深度学习推理场景中,batch size与GPU利用率呈明显的正相关曲线关系,只不过这条曲线在某个点之后会趋于平缓,然后掉头向下,掉头向下的原因不是算力不够,而是显存带宽和容量先撑不住了,批量太大时,数据在显存里塞不下,系统开始频繁做内存交换,或者直接报OOM(Out of Memory)错误。
推理batch size设置多少合适:先看硬件再定策略
盲目抄别人的batch size配置是新手最容易踩的坑,A100和4090的显存带宽、计算单元数量完全不同,适合的批量大小也天差地别。
显存容量是第一道门槛
我们可以按这个步骤来估算你能承受的最大batch size:
- 启动一个测试脚本,加载模型后,用随机生成的数据跑一次前向推理
- 用
torch.cuda.max_memory_allocated()查看这次推理占用了多少显存 - 用GPU总显存除以单次占用,得到一个粗略的batch size上限
- 在实际测试中,从上限的一半开始往上加,找到稳定运行的边界
这个方法在PyTorch框架下基本通用,如果你用的是TensorRT,可以用trtexec工具直接跑不同batch size的测速,它会自动报告各档位的吞吐量和延迟,省去手动改代码的麻烦。
计算强度决定收益上限
即便显存足够大,调大batch size带来的收益也不是线性的,做文本生成(LLM推理)时,batch size增大主要受益于权重矩阵的重复利用同一个权重被更多样本共享,计算密度自然上去,但对一些轻量的CNN模型,比如ResNet-18做图像分类,单张图的计算量已经很小,加大batch size虽然能提高吞吐,但延迟会同步上升,用户侧的感知就会变差。
批量大小对推理性能的影响:不只是利用率这一个指标
GPU利用率是个综合性指标,但业务真正关心的是吞吐量和延迟的平衡,这两个指标和batch size的关系看似矛盾,实则有规律可循。
在线服务和离线批处理的思路完全不同
在线推荐、智能客服这类需要实时响应的场景,单个请求的延迟必须控制在百毫秒级别,此时batch size通常只能设置为1或2,靠的是动态批处理(Dynamic Batching)技术,将极小时间窗口内的多个请求合并成一个batch,既保证延迟不超时,又把GPU利用率往回拉了一些。
离线批量推理则没有这个顾虑,比如视频审核、文档解析、数据清洗这类任务,用户关心的是多少个小时能处理完一百万条数据,单条数据处理快慢根本不重要,这种情况下,应该尽可能把batch size加大到显存允许的边界,把GPU利用率推到90%以上。
吞吐量和延迟如何取舍
业内专家指出,观察性能不能只看GPU跑满没有,还要同时看两个数据:P50延迟(一半请求的响应时间)和端到端吞吐(每秒处理多少请求),如果因为batch size太大导致P50延迟翻了10倍,即便GPU利用率从40%提升到95%,在线业务也得放弃这个方案,因为用户体验已经崩了。
GPU利用率低怎么排查:先别调batch size,按这套顺序查
有一种常见误解是,看到GPU利用率只有20%,立刻去调batch size,但实际上,数据加载瓶颈往往才是罪魁祸首,CPU来不及把数据搬到GPU显存里,GPU再大的batch size也填不满计算单元。
数据管线排查清单
- 检查数据加载线程数,Dataloader的
num_workers是否远小于CPU核心数 - 确认数据存储介质是SSD还是机械硬盘,机械盘随机读取性能极差
- 看CPU占满率,如果CPU已经到100%而GPU空闲,说明预处理逻辑太重
- 用
nvidia-smi dmon查看实际的计算单元利用率(SM利用率),而非只看显存占用率
值得注意的是,显存占用率高不代表GPU就真的在干活,有些模型把显存全占满了,但流水线有气泡(bubble),计算单元依然大量空转,真正的SM利用率需要看
nvidia-smi里的Volatile GPU-Util或者用Nsight Compute分析。
调大batch size后仍然上不去
如果确认数据管线没问题,把batch size调大后GPU利用率还是没到理想区间,下一步检查方向是算子效率,小算子(比如逐元素操作、激活函数)调用过于频繁,每次kernel launch都有开销,GPU在频繁启动和等待中浪费时间,可以用torch.profiler导出性能报告,看看具体哪些核函数占用了大量时间,很多场景下,将图中的多个小算子融合成一个(PyTorch 2.0的torch.compile就能自动做一部分),效果比单纯调batch size更明显。
动态批处理和静态批处理的实际操作路径
生产环境里很少有人把batch size写死,特别是在流量波动大的场景下。动态批处理在NVIDIA Triton、vLLM这些推理框架里已经是标配能力,它的核心逻辑是:等待一个预设的时间窗口(比如10毫秒),把窗口内到达的所有请求打包成一个batch一起推理,流量高时batch自动变大,流量低时batch自动变小,让GPU利用率始终维持在一个健康水平。
在框架中具体怎么配
拿vLLM做LLM推理举例,核心参数是--max-num-seqs,它控制了单个序列组最多能塞进多少请求,默认配置往往偏保守,你可以逐步增大这个值,同时观察GPU SM利用率和首Token延迟,实测下来,在A100-80G上跑Llama系列模型,max-num-seqs从64调到256,吞吐量能提升相当可观的幅度,但注意记忆体占用也会同步上涨。
Triton里则看max_batch_size和dynamic_batching的max_queue_delay_us两个参数,前者是硬上限,后者是等待时间,建议先设一个较大的max_batch_size(比如模型单层能承受的上限),再把等待时间从50微秒开始往上调,找到吞吐和延迟的平衡点。
静态batch size的适用场景
如果是定制化程度极高的场景,比如固定输入尺寸的目标检测、固定上下文长度的文本分类,可以走静态batch size路线,用TensorRT将模型在指定batch size下编译优化,运行时不再改变shape,可以获得极致性能,代价是灵活性差,batch变了就得重新构建engine,所以只适合输入形态非常稳定的业务。
GPU利用率低的典型业务场景反思
制造业质检线上跑一个缺陷检测模型,输入是固定分辨率的工业相机图像,流量相对均匀,这种场景最适合静态batch size + 固定shape,一旦调通,GPU利用率可以稳定在高位,反观面向公众互联网的AI应用,流量波峰波谷差异极大,fanout风控规则又导致每张图的计算路径都不同,这种场景硬上大batch size反而让延迟毛刺变多,用户体验受损。
在这些具体场景里做决策,才会真正理解推理批量大小是业务形态、硬件资源、SLA约束三方博弈的结果这个词组的分量,不存在一个通用的最优值,只有针对你的流量曲线、模型结构、部署预算反复实测后得到的最优区间,建议每次调整都绑定A/B测试,用两三天真实流量验证,毕竟离线压测和线上表现的差距,往往比想象中大很多。
如何判断当前batch size已经达到最优
跑一轮脚本就能得到清晰信号的实操方法:
- 观察SM利用率趋势,如果从batch size加大后提升幅度已经小于5%,说明接近拐点
- 检查是否存在大量
memcpy操作,这通常意味着数据搬运快于计算,可以继续加大batch - 做不同batch size下的延迟吞吐对比曲线,找到吞吐增加速率放缓的那个“膝盖”
- 监控GPU电源功耗,满载状态下的功耗在额定功率的80%-90%区间波动时,资源利用接近理想
这套判断流程适用于大多数主流深度学习框架和推理引擎,可以复用到你手头的任何一个部署项目上。
推理批量大小设置相关的常见问题
为什么batch size调大后GPU利用率反而下降?
通常是显存交换或者显存分配碎片化导致的,可用torch.cuda.memory_summary()查看显存碎片率,如果碎片率高,尝试开启PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True,这个选项能让显存分配更紧凑,部分框架在batch size过大时自动回退到更保守的kernel实现,也会造成利用率下降。
动态批处理有推荐的框架吗?
NVIDIA Triton和vLLM在各自领域都有不错的表现,EasyOCR的CPU版本也内置了简单的批处理策略,具体选型取决于模型类型和部署环境,Triton对多模型混排更友好,vLLM则在单模型大并发场景下效率更高,两个框架都支持从HTTP接口直接调用,切换成本不高。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625647.html