推理服务依赖库的版本治理,核心思路是把“环境”当作可复现的代码资产,通过锁定、隔离、验证三个动作来管理,而不是靠运维的手工记忆。
为什么依赖库版本会在推理服务里变成一团乱麻
大模型推理服务跑起来之后,最怕的不是模型推理变慢,而是某天重新部署时,环境突然装不上了,今天框架升级要求新版CUDA,明天旧服务的PyTorch版本又不肯动,pip在后台解析半天,最后默默把NumPy降了一个大版本,服务重启后,加载Tokenizers的报错信息直接刷满日志,这种场景在AI工程圈并不少见。

依赖库版本冲突的常见形态有这么几类:
- Python包内部的依赖约束互斥,典型如transformers要求tokenizers版本范围向上兼容,而旧版本tensorflow库锁住了protobuf 3.x,两边谁都不让步。
- Python包与系统库的版本错位,PyTorch二进制编译时链接的cuDNN版本,和你镜像里预装的cuDNN对不上,跑起来就是显存越界或算子崩溃。
- 上层代码依赖的隐式行为变更,依赖库在次版本升级时修改了默认参数,比如transformers 4.x某个版本改了
return_dict默认值,导致下游代码拿到的对象类型不一样。
行业共识认为,相当一部分线上推理事故,根因不在模型本身,而是底层依赖库的版本悄悄变了。
只靠pip的依赖解析器解决问题非常有限,pip做的事情是“在当前约束条件下挑一组满足要求的版本组合”,它不考虑CUDA运行时版本、gcc编译产物和系统glibc的兼容性,也就是说,pip能解决的只是“Python包之间相互看得顺眼”的问题,管不了“编译出来的so文件和系统库是否兼容”。
推理服务依赖库版本治理怎么做,从锁定到验证的四步走
治理这件事并不玄乎,把步骤拆开看就是四个动作:盘点环境、固化锁文件、隔离环境、回归验证,每步都能用具体命令落盘。
第一步:把当前环境完整盘点干净
在服务还能正常运行的机器上执行:
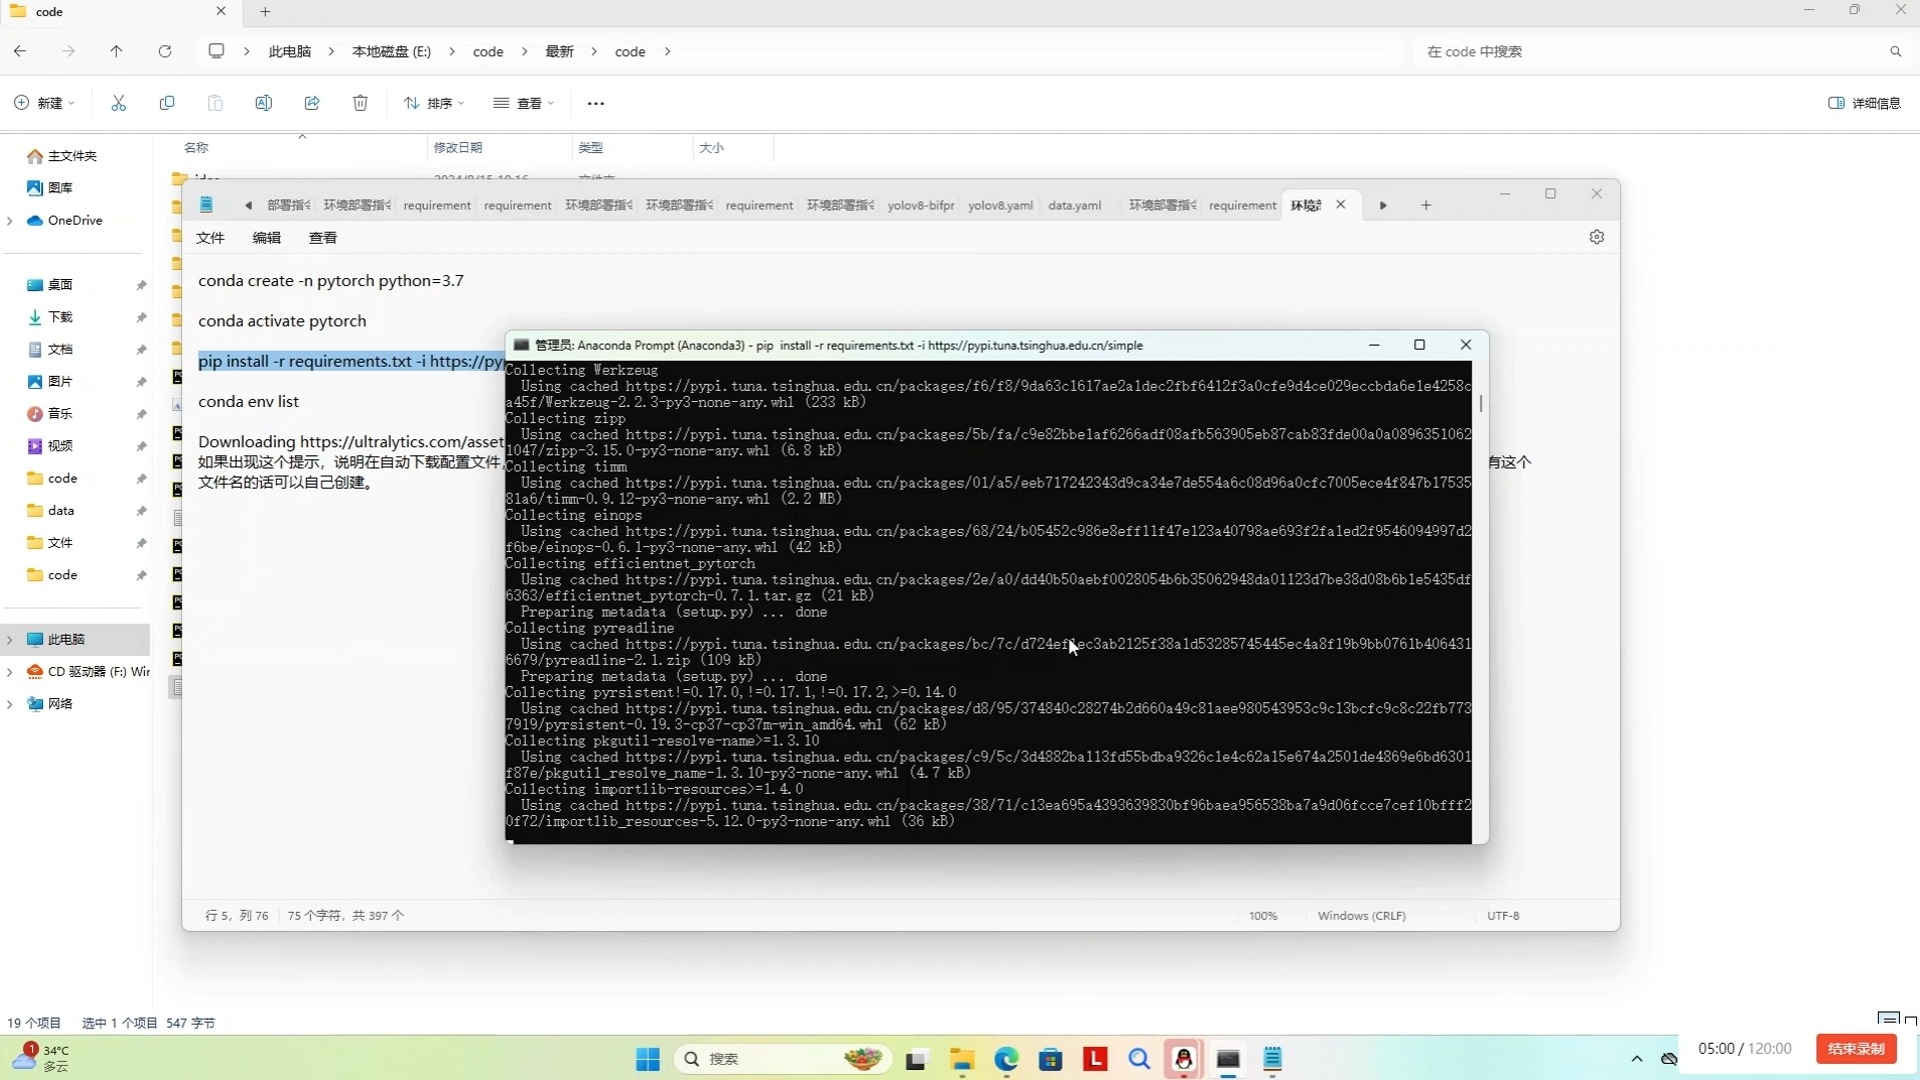
pip freeze > requirements.txt
conda env export > environment.yml
两条命令导出的内容各有用途。pip freeze列出当前Python解释器里所有第三方包及精确版本号;conda env export额外包含conda虚拟环境名、Python版本、pip安装的包以及部分系统依赖,建议两个文件都生成,同时记录nvidia-smi的输出和nvcc --version的结果,CUDA驱动版本和CUDA Toolkit版本属于两个层级的依赖,前者由显卡驱动决定,后者跟随PyTorch的wheel包走,缺一记录后面排查会很被动。
第二步:锁文件不使用范围符号
很多人写requirements.txt喜欢用numpy>=1.21这种写法,这在训练环境里问题不大,但在推理服务里是隐患,今天装出来是1.24,下周再部署可能就变成1.26,而你的推理代码用的是1.24的API行为。
正确做法是锁到精确版本,并配合哈希校验:
numpy==1.24.4 --hash=sha256:...
transformers==4.36.2 --hash=sha256:...
生成哈希值可以借助pip-tools的pip-compile工具:
pip-compile requirements.in --generate-hashes -o requirements.txt
requirements.in里写宽松约束,锁文件里输出精确版本和哈希,之后部署一律以锁文件为准,conda环境可以用conda-lock工具把environment.yml转换成多平台兼容的锁文件。
第三步:虚拟环境和容器双层隔离
虚拟环境解决的是“同一台机器上的环境打架”的问题,容器解决的是“换机器之后环境漂移”的问题。
- 开发阶段使用conda虚拟环境,
conda create -n my-infer python=3.10,每次激活环境先pip install -r requirements.txt -c constraints.txt,保证开发环境和线上基线一致。 - 生产发布阶段使用Docker镜像,Dockerfile里固定基础镜像的digest,不写
FROM pytorch/pytorch:latest这种会漂移的写法。 - 镜像构建完成后,用
docker history检查每一层是否引入了未声明的包变更。
第四步:升级后必须做输出对拍
升级依赖库版本后,模型输出质量不能只看loss曲线,对于推理服务,要做两件事:
- 固定随机种子,取同一批测试样本跑新旧两版服务,比较logits输出差异比例。
- 对比请求延迟P95和GPU显存峰值,依赖库升级偶尔会改变算子实现路径,导致同一模型在不同版本上显存占用出现较大变化。
多数情况下,只要这两项指标没有明显劣化,升级就是安全的。
推理服务依赖库版本冲突排查,先看三层信息
真正出问题时,排查顺序比排查命令更重要,建议按照Python层、系统库层、CUDA层三层逐步定位,每层都有对应的操作路径。
Python层:用解析工具找环
pip check
pipdeptree
pip check会报告当前环境里依赖关系不满足的包,直接列出冲突双方及所需版本范围。pipdeptree以树状结构展示包之间的依赖链,能快速定位是哪个上层包把旧版本拉进来的。
pipdeptree -p torch
这条命令只看PyTorch相关依赖树,输出里能清楚看到torch依赖的numpy版本范围、是否与项目里锁定的numpy冲突。
系统库层:检查二进制链接目标
Python包本身只是个壳,真正干活的是编译好的so文件,用ldd检查so库链接了哪个libcudnn:
ldd /usr/local/lib/python3.10/site-packages/torch/lib/libtorch_cuda.so | grep cudnn
如果链接到的libcudnn.so.8版本与镜像里安装的不一致,就会出现“GPU显存越界”这类晦涩报错,此时优先处理系统库路径,比如在Dockerfile里设置LD_LIBRARY_PATH指向与PyTorch wheel包配套的cuDNN目录。
CUDA层:区分驱动和运行时
nvidia-smi
nvcc --version
nvidia-smi显示的是显卡驱动支持的CUDA版本上限,nvcc显示的是当前安装的CUDA Toolkit版本,PyTorch的wheel包自带CUDA运行时,并不需要系统安装完整Toolkit,但cuDNN和TensorRT通常需要单独匹配,要记住一个原则:驱动版本可以高于运行时版本,但不能低于运行时所需的最低版本。
实际工作中遇到最多的是protobuf冲突,训练脚本里用的protobuf==3.20.3,但推理服务依赖的grpcio要求protobuf>=4.21,升级protobuf后,老代码里直接用message.ByteSize()的调用方式在新版本被移除了,导致显存里序列化的逻辑直接抛异常,这类问题从pip依赖树里看不出任何异常,只能靠编译期检查或单元测试兜底。
用虚拟环境把推理服务依赖库版本隔离起来
隔离是版本治理里性价比最高的手段,一个推理机上的多个服务如果共享同一个site-packages目录,互相污染是早晚的事,隔离分成两个层次:环境级隔离和容器级隔离。
环境级隔离
conda虚拟环境在开发阶段够用,同一台GPU机器上可以同时存在多个虚拟环境,每个环境的Python解释器和第三方包互不干扰,切换环境通过conda activate完成,两个环境可以分别装不同版本的PyTorch和CUDA运行时。
conda create -n infer-torch2.1 python=3.10
conda activate infer-torch2.1
pip install -r requirements-torch2.1.txt
容器级隔离
进入生产环境后,Docker是更彻底的隔离方案,镜像构建时把锁文件复制进容器,构建完成后整个镜像就是一份可复现的交付物,升级版本时不需要在物理机上动依赖,直接构建新镜像并替换容器即可。
隔离方案的选择有几个因素要权衡:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| venv虚拟环境 | 轻量、无需额外权限 | 仅隔离Python包,不隔离系统库 | 单台开发机上多项目并存 |
| conda虚拟环境 | 可管理非Python依赖,支持Python版本切换 | 维护成本稍高,环境体积较大 | 有CUDA/nccl等复杂依赖时 |
| Docker容器 | 完整隔离,交付物可复现 | 镜像构建和存储开销大 | 生产推理服务、多服务混布 |
推理服务依赖库版本升级的回滚通道
升级依赖库版本最怕的是升完起不来,越高级的依赖库,升级带来的连锁反应越难预期,比如把PyTorch从2.0升到2.1,torch.compile引入了新的IR和编译后端,部分自定义算子的注册方式发生了变化,如果不预留回滚通道,线上服务可能直接处于不可用状态。
一套安全升级路径建议如下:
- 升级前保存旧环境快照,如果是conda环境,执行
conda env export > environment.backup.yml。 - 在干净的测试环境里执行新锁文件安装,跑一遍全量单元测试和模型推理对拍。
- 用新镜像在灰度机器上启动服务,观察24小时内的报错日志和推理延迟指标。
- 灰度通过后逐步切流,保留至少一台旧版本服务直到新版本稳定运行满一周。
- 新版本跑了一周没出问题,才清理旧镜像和旧环境备份。
回滚操作本身要能快速执行,容器化部署时,回滚就是重新部署上一个tag的镜像,耗时只需要分钟级,非容器化部署时,回滚靠重启conda环境和切换PYTHONPATH指向备份环境实现。
推理服务依赖库版本治理不是一次性工作,而应该成为每次版本发布前的固定流程,把锁定、隔离、验证三个动作固化到CI流水线里,用自动化脚本代替人工记忆,这样才能让线上推理环境不“玄学”,版本治理做得好,部署就变成一件可以预期的事情:锁文件不变,环境就不变;环境不变,服务表现就不变。
Q&A
推理服务依赖库版本冲突能靠pip自动解决吗
不能,pip的依赖解析器只处理Python包之间的版本约束,不考虑CUDA运行时、系统库版本和二进制编译兼容性,更有效的方式是使用锁文件控制版本组合,配合容器镜像固化运行环境,遇到冲突时,先看pip check的输出,再用pipdeptree定位依赖链,最后检查so文件链接的系统库版本。
管理推理服务依赖库版本选conda还是pip
两者不是替代关系,conda的优势在于能管理Python包之外的二进制依赖,如CUDA运行时、cuDNN、OpenMP,适合在开发阶段快速搭建复杂环境,pip的优势在于紧贴PyPI生态,锁文件生成和哈希校验机制更完善,适合在容器镜像构建阶段做精确控制,混合使用时,用conda建虚拟环境,用pip管Python包,系统库层面用conda安装,Python包层面用pip安装。
升级依赖库版本后怎么验证推理结果没有变化
固定随机种子,取同一组输入数据,分别用新旧两个环境跑一遍,对比模型输出logits的数值差异,同时比较推理延迟P95和GPU显存峰值,这两项指标能反映算子实现路径是否发生了变化,如果输出差异在约定的阈值内且性能指标没有劣化,说明升级对业务无影响,差异明显时,需要逐个回退版本,用二分法锁定行为发生变化的那个依赖库版本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623073.html