数据倾斜的根因在于分片键选型与查询执行计划的双重失衡,单靠调整并行度或资源参数无法根治,必须从数据分布源头和SQL访问模式两端同步下手。
分布式数据库处理海量数据时,最怕的不是数据大,而是数据“偏”,几十个节点忙得冒烟,剩下的节点闲着看戏,整个任务的耗时被最慢的那个节点死死卡住,这条“短板”就是倾斜节点,业内专家指出,多数大规模集群的性能事故,最终都能追溯到分片键设计与查询写法这两个环节。

先分清倾斜类型,再看分片键与查询哪个是主因
拿到一个执行慢的任务,别急着改代码,先把日志拉出来,判断倾斜属于哪一类,不同成因的倾斜,解法完全相反。
数据分布型倾斜:分片键选错了对象
这种倾斜的典型特征是小文件、热点Key、单分区数据量爆炸,比如电商订单表按用户ID分片,某个大客户的订单量占了全表的15%以上,那这个节点就成了天然瓶颈,具体表现是某个ReduceTask的输入数据量明显高于均值,且持续数小时无法结束。
计算密集型倾斜:查询把压力集中到了单点
这类倾斜的特征是某节点CPU使用率打满,但数据量不大,常见于大表关联小表时,关联字段的基数极低(比如性别、状态字段),或者过滤条件把绝大多数数据推到了同一个节点上,此刻分片键没问题,是查询重了。
快速区分两种情况的排查方法
- 看任务诊断页面的数据倾斜报告,对比各Task的输入记录数与处理耗时
- 看节点监控:数据量倾斜表现为磁盘IO不均,计算倾斜表现为CPU不均
- 用
EXPLAIN查看执行计划,确认Join和Aggregate的分布方式
分片键怎么选,核心原则是打散热点与保持关联
分片键是数据倾斜的第一道闸门,选不好,后面怎么优化都是事倍功半。
优先选高基数且业务无关的字段
时间戳、自增ID、雪花ID这类字段,天然分布均匀,但需要注意,单纯按时间分片虽然均匀,却容易让查询变成“扫描全部”,所以分片键的价值在于均衡,而非业务语义。
组合分片键:用业务维度二次打散
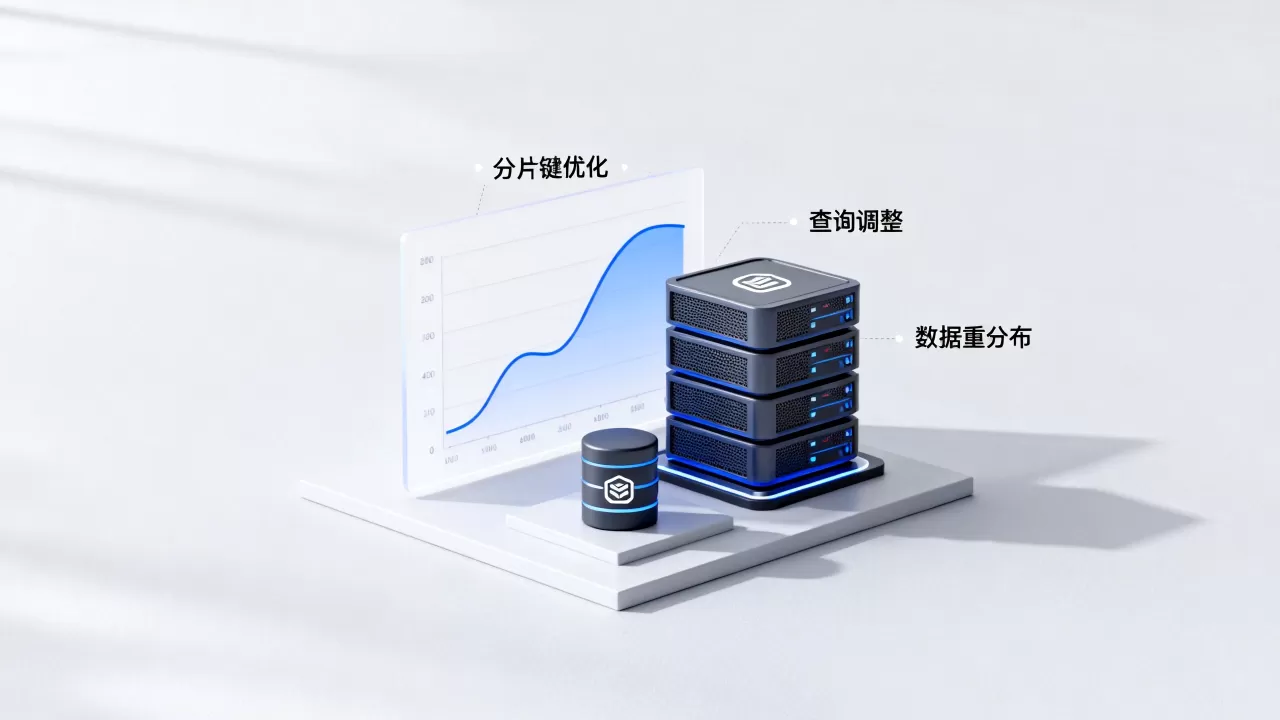
比如订单表,用order_id做分片键虽然均匀,但按seller_id查询时仍然需要全节点扫描,此时可以用(seller_id, order_id)做复合分片键,既保证卖家维度的数据本地性,又通过order_id的随机性避免了单个卖家的数据倾斜。
换键的最佳实践:哈希取模与范围分片混用
数据倾斜怎么解决,实践中常用以下操作路径:
- 用
abs(hash(user_id)) % 节点数强制打散数据 - 对超大热点Key单独摘出来,单独路由到专用节点
- 使用一致性哈希环而非简单取模,扩展节点时减少数据迁移
在某些业务场景下,分片键不可更换,例如历史库中所有数据已按交易日期分区,此时只能通过增加二级分片字段来缓解。
业界默认的口径:多分片键设计需要权衡查询模式
不同行业倾向不同分片策略,金融行业重视交易的时序聚簇,多采用时间范围分片;互联网行业重视用户维度的数据本地性,多采用用户ID哈希,行业共识认为,不存在万能分片键,只有贴合业务查询模式的分片键。
查询侧优化,把压力从倾斜节点分摊出去
分片键已经固定,但查询方式可以调整,这类优化通常能快速见效,且不用动数据。
Join倾斜:大表Join大表时,广播小表或改造为分桶表
在Hive、Spark等引擎中,小表Join大表时强制开启Broadcast Join,将小表复制到每个节点内存中,避免Shuffle,具体操作:
-- Spark SQL 中强制广播
SELECT /+ BROADCAST(small_table) /

FROM big_table b
JOIN small_table s ON b.key = s.key
如果Join的两张表都很大,则需要将两张表按Join字段重新分桶,桶内数据做局部Join。
聚合倾斜:两阶段聚合,先局部再全局
针对某个Key数据量过大导致的聚合倾斜,先给Key加随机前缀,做一次局部聚合,再去掉前缀做全局聚合,以SQL为例:
-- 第一阶段:加随机前缀打散
SELECT
  prefix,
  key,
  SUM(value) AS partial_sum
FROM (
  SELECT
    concat(cast(round(rand()  10) AS string), '_', key) AS prefix,
    key,
    value
  FROM source_table
) t
GROUP BY prefix, key
-- 第二阶段:去掉前缀做最终聚合
SELECT
  key,
  SUM(partial_sum)
FROM temp_table
GROUP BY key
这种优化在数据仓库的ETL环节中应用最广,解决高基数Key聚合倾斜效果明显。
过滤条件下推:让数据在读取阶段就变瘦
很多查询慢是因为读取了不该读的数据,把过滤条件尽可能下沉到存储层:
- 在分区表中,指定分区字段过滤,减少扫描数据量
- 在列式存储中,只SELECT需要的列
- 使用谓词下推特性,让存储层计算过滤后的结果
数据倾斜的实时计算场景:窗口聚合的预聚合处理
Flink或Kafka Streams中,窗口聚合的倾斜同样存在,处理方式是为数据加上分桶字段,把单流拆成多流,例如用户行为分析中,热门事件会集中在一个子任务中,此时可采用:
- 将Key按哈希值拆分为多个子任务
- 在窗口内做部分聚合,窗口结束时合并
- 为某个热点Key设置动态分桶数,非热点保持默认
常规手段倾斜严重?更换分片键是最后的底牌
如果优化查询仍然无法解决,只能做数据的重分布,这属于高成本操作,需要评估后再执行。
重分布前需要厘清的三个问题
- 数据是否允许短暂的双写期间(迁移时新旧表并行)
- 重分布后查询模式是否发生了巨大变化(可能把长尾问题转移)
- 是否可以使用逻辑分片代替物理迁移(虚拟分片映射到物理节点)
重分布的具体操作框架
数据倾斜场景下的重分布,通常分三步走:
- 评估旧Key的分布曲线,找出导致倾斜的TopN Key
- 重新定分片规则,将热点Key单独映射到更细粒度分片
- 灰度迁移,先迁移冷数据,再切换热数据的流量入口
什么时候用中间表方案
中间表方案适用于无法修改分片键,但查询SQL可控的场景,将倾斜的原始表,拆分为“热点表”和“普通表”,分别存储不同数据,查询时通过UNION ALL合并结果,实际操作时,写一个定时任务扫描Key的计数,超过阈值的Key入热点表。
日常运维中,数据倾斜的预防比补救更重要
多数数据倾斜问题,在表结构设计阶段就已经埋下了隐患,将分片键的检查机制前置到建模环节,远比事后优化划算。
分片键的监控指标体系
建议日常重点观察以下指标:
- 各分片节点的数据体积差异倍数,超过3倍时关注
- 分片键值域的基数统计,判断是否存在单Key记录数过多
- 读写请求的热点分布,识别高频访问的Key集合
分片键选型时的检查清单
- 该字段是否具有明确的业务含义(如用户ID,店铺ID)
- 该字段的取值基数是否足够大(重复率低)
- 该字段是否在多数查询中被用作等值过滤条件
- 该字段的历史增量是否均匀(是否会出现某天数据暴增的情况)
数据模型演进中的分片键维护
业务在变,分片键的合理性也会变,建议每季度做一次分片键健康度评估,具体做法是跑一次全量数据分布SQL,输出各分片的数据量排名,观察是否存在某个分片数据量持续增长的趋势。
Q&A:数据倾斜与分片键常见疑问
问:数据量不大但是任务跑得极慢,算数据倾斜吗?
答:算,任务耗时的天花板是待处理数据的“最长链”,当某个计算节点的任务耗时远大于其他节点,即使数据总量不大,也属于计算倾斜,需要优先检查Join是否产生了笛卡尔积膨胀、GroupBy的Key基数是否过低、窗口函数中是否使用了全局排序,再好的分片键也救不了重度计算倾斜的SQL。
问:热点Key的影响真的有那么大吗?
答:热点Key是数据倾斜中影响最恶劣的一种,一个节点承受了全表80%以上的流量时,横向扩容也无法解决,因为热点Key所在节点的处理能力就是上限,处理的核心思路是为热点Key增加随机后缀,强制拆分为多个子Key分散到不同节点,流量打散后,再通过二次聚合或二次Join把结果合并,多写几个SQL,远比重启任务划算。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/637859.html