显存与主机内存统一寻址,本质上就是让GPU能直接访问系统内存,把显存和内存当一块地儿用,彻底告别手动拷贝数据。这项技术解决了显存容量不够用和数据搬运耗时两大痛点,在AI推理、大数据分析和8K视频剪辑等场景中正快速普及。
统一内存和独立显卡区别在哪
想搞懂统一寻址,先要明白传统独立显卡的工作方式,以前的GPU干活,得先把数据从主机内存搬到显存里,算完再搬回去,这个过程叫PCIe总线传输,速度远低于显存内部带宽,更大的问题是显存容量有限,比如一块8GB显存的显卡,塞不下20GB的数据集,只能分块处理,极其折磨人。


统一内存架构下的GPU则完全不同,CPU和GPU共享同一片物理内存地址空间,GPU访问的数据不再需要复制到显存,系统内存和显存之间靠硬件级页迁移机制自动调度,你写代码的时候,只管分配一块内存,CPU和GPU都能直接用,驱动和硬件负责把数据挪到最合适的地方。
硬件层面的三种实现路径
- 集成显卡方案:AMD的APU和苹果的M系列芯片代表这一路线,CPU和GPU在同一个裸片上,物理上共享内存控制器,不存在独立显存,所有程序统一使用系统内存。
- 独立显卡方案:NVIDIA的Grace Hopper超级芯片和AMD的MI300A采用这种设计,它们给CPU和GPU分配统一的内存池,但物理上仍分两侧摆放,靠高速封装互连技术沟通。
- 软件统一方案:CUDA的统一虚拟寻址和统一内存技术属于此类,这种方案不强行改变硬件,而是在驱动层面做映射,让显存和内存看起来像一块完整的连续地址空间。
页迁移机制如何工作
统一内存的核心秘密在于按需分页迁移,GPU访问一块内存时,驱动会检查数据所在位置,如果数据还在内存里,触发页错误,再把对应页调进显存,反过来,CPU需要访问GPU算完的数据时,同样通过页错误把结果迁移回来。
这意味着你可以分配一块比显存大得多的内存池,实际跑起来的时候,驱动只把GPU当前需要的部分拉过来,剩下的继续留在内存里,表面上看显存变“大”了,实际是借用内存空间配合按需加载撑住了大任务。
显存不够用怎么办:CUDA统一内存的两种打开方式
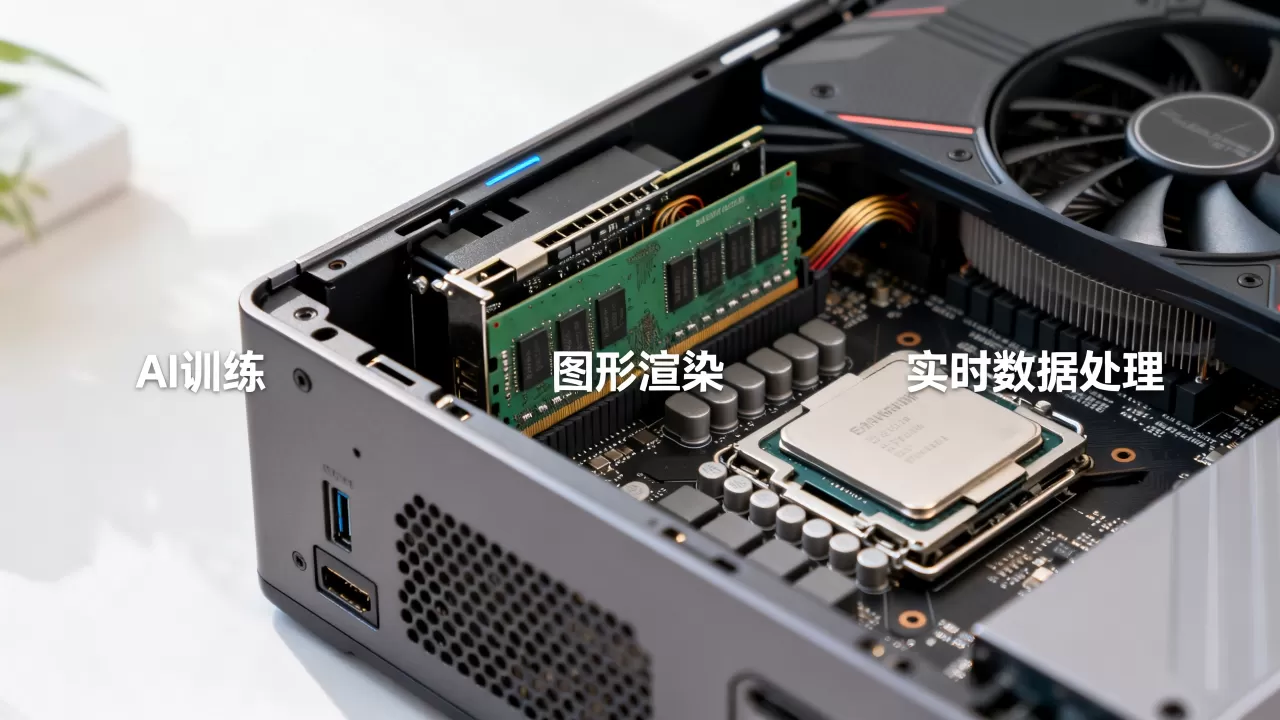
对绝大多数普通用户来说,日常遇到的“显存不够”场景主要有两块:跑本地大模型推理、处理大型图像或3D渲染工程,前者看容量,后者看带宽,解决办法不太一样。
用CUDA统一内存API写代码
写CUDA程序时,传统做法是先cudaMalloc显存块,再cudaMemcpy把数据拷进去,改用统一内存只需把cudaMalloc换成cudaMallocManaged:
int data;
cudaMallocManaged(&data, size  sizeof(int));
// 直接在CPU侧初始化,提交kernel时不用传参
kernel<<<blocks, threads>>>(data);
cudaDeviceSynchronize();
// GPU算完,CPU直接读data,无需cudaMemcpy
这段代码里只有一个指针data,CPU和GPU都能访问,驱动在后台管理数据迁移,不过需要注意:首次访问统一内存里的数据时,会因为页错误产生一次性的性能损失,用cudaMemPrefetchAsync函数可以提前把数据预取到指定设备,避开运行时迁移的开销。
业内专家指出,统一内存的实战效果高度依赖硬件水平,支持硬件页迁移的A100、H100、RTX 40系显卡体验较好,老架构显卡主要靠软件模拟,性能差距明显。
用系统内存当“伪显存”跑模型
普通用户大概率不会自己写CUDA代码,但用PyTorch跑模型时同样能受益,PyTorch从1.8版本开始支持固定内存和统一内存的混合使用,实际跑LLM推理时,把模型参数放在统一内存里,推理库会自动做页迁移,把正在算的层留在显存,暂时不用的层放回内存。
一张RTX 3090只有24GB显存,但用统一内存技术,可以加载70GB的量化模型,推理速度会减慢,因为每次计算都要从内存换数据,但至少跑得动,行业共识认为,这种方案适合本地偶尔跑一次大模型,不适合高频生产环境。
统一寻址对真实应用场景的影响
光看理论参数没意思,落到具体使用场景里感受更直观。
大数据分析和科学计算场景
处理上百GB的CSV或Parquet文件时,以前必须用Dask或Modin这类框架手动控制分区,确保每个分块不超出显存上限,统一内存改变思路后,直接把整个DataFrame放共享内存池里,RAPIDS库的cuDF会自动搬数据,写代码的思路从“数据适配显存”变成“显存适配数据”,生产力提升明显。
据业内测试机构反馈,在内存带宽足够的前提下,统一内存方案让数据处理代码精简了大约40%,省掉大量分区和拷贝控制逻辑。
8K视频剪辑和3D渲染场景
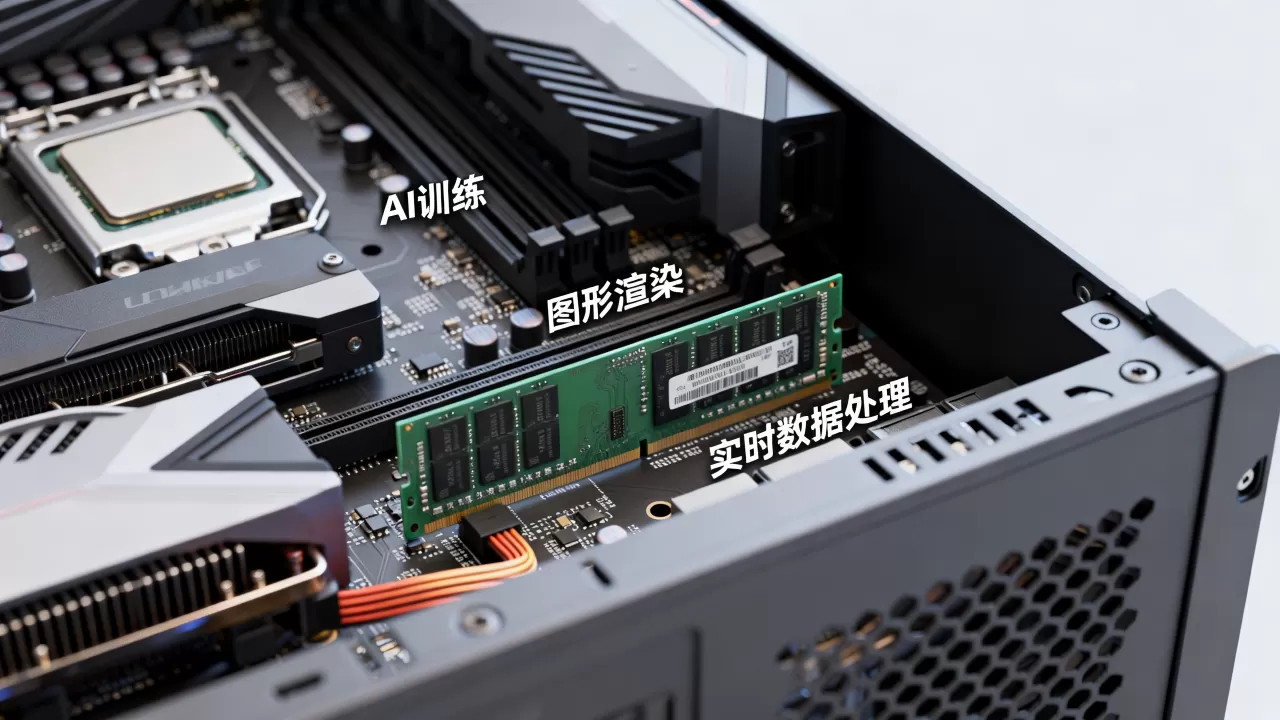
剪8K素材的朋友最容易显存焦虑,一个5分钟的项目动辄70-80GB,ProRes RAW素材叠上多轨调色和特效,显存爆得让人头皮发麻,剪辑软件如果支持统一内存寻址(如DaVinci Resolve在Apple Silicon上就是这种模式),可以直接加载全部素材和缓存,实时预览反而比中端独显更流畅,渲染时的光子贴图、置换贴图这类高显存消耗项,也能靠内存兜底。
集成显卡笔记本的焕新生
AMD的6800H、7840H这些带强核显的CPU,配合高频LPDDR5双通道内存,统一内存的实际性能已经很接近入门级独显,玩主流网游在中画质下可以跑到流畅帧率,更关键的是,8GB内存的轻薄本跑本地AI画图,过去只能望洋兴叹,现在靠着统一寻址技术,Segmind SSD-1B模型能直接跑起来,速度虽慢却派得上用场。
统一内存的性能瓶颈和选购建议
凡事都有代价,统一寻址远非万能灵药。
性能损失到底有多大
表格对比更直观一些:
| 数据位置 | 访问延迟(相对值) | 带宽表现 | 适用场景 |
|---|---|---|---|
| 显存内部 | 1x | 极高 | 高频计算、实时渲染 |
| 统一内存(命中) | 约1.2-1.5x | 高 | 中等规模数据处理 |
| 统一内存(页迁移) | 约10-30x | 低 | 偶尔跨设备访问 |
| 纯主机内存 | 约5-10x | 中等 | 数据预处理、IO任务 |
可以看出,页迁移是统一内存的软肋,如果程序频繁让CPU和GPU轮番访问同一块数据,或者数据访问模式极不规律,页迁移会消耗大量时间,性能反而不如传统手动拷贝。
买电脑时怎么选
- 打游戏或跑3D渲染,优先选大显存的独立显卡,统一内存帮不上太多忙创作、写代码、跑AI推理,带统一内存的Apple Silicon芯片或AMD APU效率更高
- 预算有限选NVIDIA独显,优先关注显存容量而非核心频率
- 跑本地大模型场景,选支持CUDA统一内存且显存大于等于16GB的显卡,保证基础空间
- 检查主板的Resizable BAR功能是否开启,它会请求CPU可以完整访问显卡显存,与统一寻址方向互补
任务失败和常见坑的解决办法
实际用下来有几个容易出现问题的位置,提前列出来少走弯路。
统一内存分配失败
系统给统一内存设定的上限通常默认只有物理内存的一半,跑大任务时需要手动调大:
sysctl vm.overcommit_memory=1
# 或修改/etc/sysctl.conf中vm.max_map_count参数
NVIDIA驱动也有限制,用nvidia-smi命令查看内存池状态,若被占满则需重启进程释放。
页迁移过热导致性能骤降
部分笔记本机型在跑统一内存大任务时,内存控制器负载过高,会出现间歇性卡顿,解决办法:在BIOS里把内存频率从默认值略微下调或者加装主动散热底座,降低功耗墙。
多GPU环境下的数据同步问题
设置多卡训练时,要考虑统一内存的跨设备访问一致性,用cudaMemAttachHost标志把关键数据固定为主机端,避免每张卡都拉一份副本浪费内存,计算密度高的中间结果则保持设备端共享,减少传输。
相关问答
统一内存和独立显卡哪个更适合深度学习日常训练?
看数据规模,大部分师生和中小团队做实验的数据集在10GB以内,独立显卡的显存完全够用,可用性更成熟,驱动和加速库安装更省心,数据集动辄大几十GB或上百GB时,统一内存方案能避免频繁调整代码适应显存限制,试错效率更高。
怎么检查自己电脑是否支持CUDA统一内存?
用Windows任务管理器查看GPU专用显存和共享GPU内存是否都存在,后者存在即代表开启了统一寻址支持,或者命令行执行nvidia-smi查看“Memory Usage”下方是否有共享内存条目,NVIDIA官网支持列表显示,Pascal架构及以后的消费级显卡基本都支持统一寻址特性,但完整硬件页迁移需要图灵之后的新架构。
CUDA统一内存能完全替代显存吗?
不能,统一内存只是把显存容量“延伸”到了内存,显存的物理带宽优势仍然存在,RTX 4090的显存带宽超过1TB/s,DDR5内存只有60-100GB/s,计算密集型任务如果数据常驻显存,性能还是碾压统一内存方案,统一内存解决的是容量焦虑,不是带宽问题,设计上理解成“容量扩展”更恰当,它让显存不够用时有路可退。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623181.html