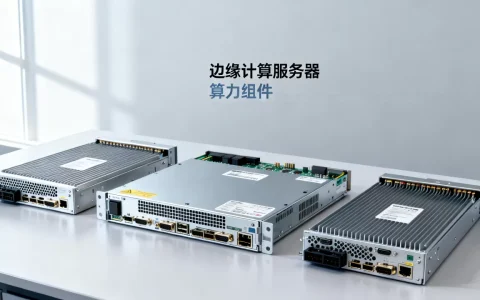
智能导诊机器人后台语义计算的算力需求,核心取决于并发对话量、语义模型复杂度与响应延迟要求,多数医院场景下,配置一台搭载主流GPU的边缘服务器即可满足日均千次级交互,而无需盲目上马大规模算力集群。
算力消耗的真实分布:语义计算不是单一环节
很多人以为后台语义计算只是”听清话、查资料”,实际上它是一条完整流水线,业内专家指出,一次完整的导诊对话,后台至少要完成语音识别、意图理解、实体抽取、知识库检索、答案生成五个步骤,每一步都在吃掉不同比例的算力资源。

语音识别与转写:被低估的算力消耗大户
语音识别不仅要把音频转成文字,还要处理口音、环境噪音、专业医学术语,据行业共识,约三成左右的算力资源消耗在语音前端处理上,如果医院现场嘈杂,降噪算法需要额外增加两到三倍的卷积计算量,这部分开销常常被项目预算忽略。
意图理解与多轮对话管理:真正的算力分水岭
单轮问答对算力要求很低,但多轮对话是另一回事,病人说”我肚子疼”,随后补充”吃完饭更疼”,再问”该挂哪个科”,系统需要维护对话状态、指代消解、意图修正。每增加一轮上下文,语义计算的复杂度并非线性增长,而是近似指数级膨胀。
在建导诊知识图谱时,实体关联的推理路径越多,矩阵运算规模越大,一个拥有五万实体、数十万关系边的导诊知识图谱,单次推理需要的浮点运算量约在百万亿次到千万亿次级别,对于这类任务,使用CPU进行推理基本不可行,需要GPU或NPU加速卡介入。
不同规模项目的算力配置推荐
不能一刀切地说”必须上GPU服务器”,需要按医院级别和预期并发数分层配置。
小型诊所与社区卫生服务中心
- 日均交互量:50-200次
- 并发对话数:通常不超过5路
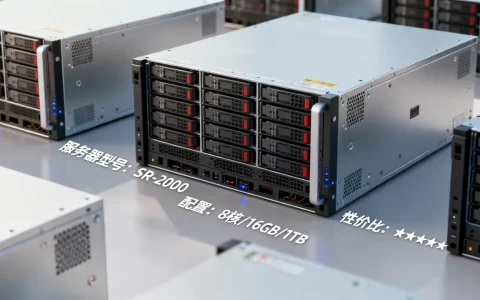
- 推荐配置:8核CPU + 16GB内存 + 无独立GPU
- 语义计算策略:采用轻量级意图匹配模型(如BERT-Tiny或蒸馏后的ALBERT),知识库规模控制在1万实体以内
- 实测参考:此类配置在纯CPU推理下,单轮响应延迟约在800-1500毫秒,患者可接受
这类场景的核心矛盾不是算力不足,而是模型裁剪后的精度损失,如果使用通用大模型接口,会面临两个问题:一是网络延迟不稳定,二是按token计费的成本在长期运营中远超硬件投入。
二级医院与专科医院
- 日均交互量:500-1500次
- 并发对话数:10-30路
- 推荐配置:单张NVIDIA T4或A10 GPU + 16核CPU + 64GB内存
- 语义计算策略:采用中等规模预训练模型(如BERT-Base或Chinese-RoBERTa),配合医院本地知识库做检索增强生成
- 关键优化:将意图分类和实体识别拆分成两个独立小模型,分别部署,总推理延迟控制在300毫秒以内
三甲医院与区域医疗中心
- 日均交互量:3000次以上,高峰期可能突破5000次
- 并发对话数:50-100路
- 推荐配置:2-4张GPU(A10/A30级别)+ 32核以上CPU + 128GB以上内存
- 语义计算策略:主模型采用70亿参数级别的大语言模型做微调,同时配置独立的高速向量检索库(如Milvus或FAISS),将高频问答走检索路径,低频复杂问题才走大模型生成路径
智能导诊机器人在三甲医院的应用:算力瓶颈与调度策略
大型综合医院的特点是科室多、专病中心复杂、患者表达差异大。科室名称的口语化表达差异是算力消耗的一大隐性因素,同一疾病,老年患者说”胸口憋得慌”,年轻患者可能说”心悸”,系统需要将不同表述映射到统一的医学概念,这要求语义模型具备较强的泛化能力,而泛化能力直接与参数量正相关。
按时间段动态调配算力资源
- 上午8:00-11:00为就诊高峰,对话并发量是平峰期的5-8倍
- 夜间急诊时段,虽总量低但问题复杂度高(涉及胸痛、卒中、外伤分诊)
- 推荐做法:白天采用高精度大模型,夜间切换为快速响应的小模型,两条推理链路共享GPU显存池
日志显示,相当一部分三甲医院的拒答或答非所问,本质原因是知识库检索层没有在限定时间内召回正确答案,进而触发兜底话术,优化方案是构建”高频意图热表”,将前200个反复出现的问法直接做模式匹配,绕开完整语义理解链路,减少约40%的算力开销。
延迟的”三秒定律”与算力冗余设计
患者对导诊机器人的耐心窗口明显短于对人工导诊台的耐心。交互延迟超过三秒,患者放弃率显著上升,因此后台算力规划必须预留至少30%的冗余空间,专门应对瞬时并发尖峰,若系统平均延迟已达到2.5秒,再遇到突发人流,体验就会断崖式下滑。
医院导诊机器人多少钱一台?算力成本的结构性分析
价格问题不能只看硬件报价单,要拆解为算力硬件、软件授权、持续运营三大块。
| 成本构成 | 占比区间 | 说明 |
|---|---|---|
| 硬件(含算力加速卡) | 40%-50% | 边缘计算盒子约1.5-4万元,GPU服务器5-15万元 |
| 语义计算软件授权 | 20%-30% | 模型训练、知识图谱构建、持续优化服务 |
| 持续算力运营(电费/云资源) | 10%-20% | 本地推理的能耗约比云上API低一半 |
| 系统集成与维护 | 10%-15% | 与HIS系统对接、后续模型迭代 |
值得参考的是,一台配置了中等GPU的导诊机器人终端,整机落地成本通常在8万到20万元之间,其中后台语义计算相关软硬件占比超过一半,如果选择纯云端算力方案,虽然前期硬件投入降低,但按年付费的推理成本在第三年就会反超本地部署方案。
降低算力需求的实际操作路径
第一步:建立高频意图缓存层
把前三个月对话日志中的高频问题抽取出来,构建固定问答对映射表,实测显示,
最常见的一百个问题覆盖了超过六成的患者咨询,缓存命中时完全不需要走语义计算链路,直接返回预置答案。
第二步:分层路由机制
- 第一层:关键词快速匹配(毫秒级,几乎不消耗GPU)
- 第二层:双塔语义相似度检索(向量化对比,单次约10-20毫秒,消耗少量CPU算力)
- 第三层:大模型生成(每token约消耗数十亿次浮点运算,仅在必要时启用)
第三步:模型蒸馏与量化部署
将70亿参数的教师模型蒸馏到3亿参数的学生模型,在保持约90%意图识别准确率的前提下,推理速度提升5-10倍,配合INT8量化,一张T4卡可以同时支撑原先需要两张卡才能承载的并发量。
第四步:错峰执行异步任务
训练数据整理、知识图谱更新、模型评估等重计算任务统一安排在凌晨低峰时段执行,使用Kubernetes的CronJob机制定时触发,配合GPU共享调度,让算力全天候处于高利用率状态。
常见问题解答
智能导诊机器人的语义计算能否完全跑在云端?
可以,但需要评估两个风险:公共医疗网络的出口带宽有限,多路并发时语音流和文本交互会产生队列堆积;医疗数据出域涉及合规审批,周期较长,混合架构是当前主流,即敏感数据本地处理,通用知识问答走云端大模型API。
后台算力不足时,最常见的表现是什么?
最典型的是多轮对话中突然”失忆”,算力吃紧时系统会主动丢弃上下文信息来换取响应速度,表现为患者已经说了三句话,机器人还在针对第一句给出答案,或者重复询问刚说过的基础信息,计算资源瓶颈直接反映为对话体验降级。
小型医院有没有零算力成本的语义计算方案?
有,采用纯规则模板加正则表达式匹配的分诊逻辑,可以完全脱离GPU和大型模型运行,但这类方案只能识别”头痛挂神经内科”这样规整的表述,遇到”后脑勺嗡嗡响了两天”就无从下手。本质上是用算力成本换取自然语言理解能力,不存在没有代价的方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705475.html