服务器停服原因主要有硬件故障、软件配置错误、网络攻击、流量冲击以及运维操作失误五大类,其中资源耗尽和人为失误在中小型站点中占比最高。
服务器停服原因有哪些?先看硬件与资源层面
服务器本质上是一台常年不关机的电脑,硬件问题是最直接也最无预警的停服理由。

硬件老化与损坏,宕机来得毫无征兆
机房环境不是恒温恒湿的吹空调那么简单,硬盘是机械结构,磁头在盘片上高速读写,使用三五年后扇区会逐渐老化,坏道积累到一定程度,操作系统直接卡死,服务器就彻底罢工了。
内存条金手指氧化、电容鼓包、电源模块老化,这些在表面看不出问题,但服务器日志里会留下越来越多的报错记录,业内专家指出,硬件故障占服务器非计划停机原因的四成以上,其中硬盘故障又是重灾区。
排查方法不复杂,看两个地方:
- 系统日志里有没有大量
I/O Error、SCSI Error、Disk read/write failure /var/log/messages或Windows事件查看器里有没有突然出现的中断记录
预防思路就是把服务器当作一台会疲劳的机器,三五年以上的老机器,重要数据一定要做raid备份,别把鸡蛋放在一个篮子里。
磁盘写满和内存溢出,多数停服其实死在这里
硬件没坏,服务器也停了,这类情况往往是软资源耗尽。
磁盘写满是最常见的,日志文件天天涨,数据库binlog没清理,备份任务写满了一个分区,服务就写不进去数据了,网站表现为页面打不开,数据库表现为连接全部阻塞,整台服务器就像喉咙被塞住的人,没法呼吸。
内存溢出排第二,PHP-FPM进程或Java应用出现内存泄漏,跑几天后内存占用一点点涨上去,最后OOM,系统直接kill掉进程,本机看dmesg | grep -i oom就能找到记录。
这类停服原因的特点是有先兆可查,磁盘使用率连续一周上涨、内存占用曲线越来越陡,都是典型信号,建议配置一个简单的监控脚本,磁盘使用率超过85%就报警,内存持续五分钟超过90%就自动重启对应服务进程,能挡住相当一部分停服事故。
网站服务器不稳定是什么原因?软件与配置是重灾区
相比硬件故障,软件层面的问题更隐蔽,也更频繁,网站服务器不稳定是什么原因,答案多数时候藏在配置文件里。
配置错误和版本兼容,改动即事故
上了生产环境的服务器,最怕的不是不修改,而是乱修改。
Nginx配置文件写错一个分号,nginx -t直接报错,重启后站点全挂,PHP版本从7.4升级到8.0,老代码里的废弃函数一调用就报警,整个服务直接500,数据库从MySQL 5.7迁移到8.0,字符集排序规则变了,查询语句走了错误的索引,数据库CPU被打满。
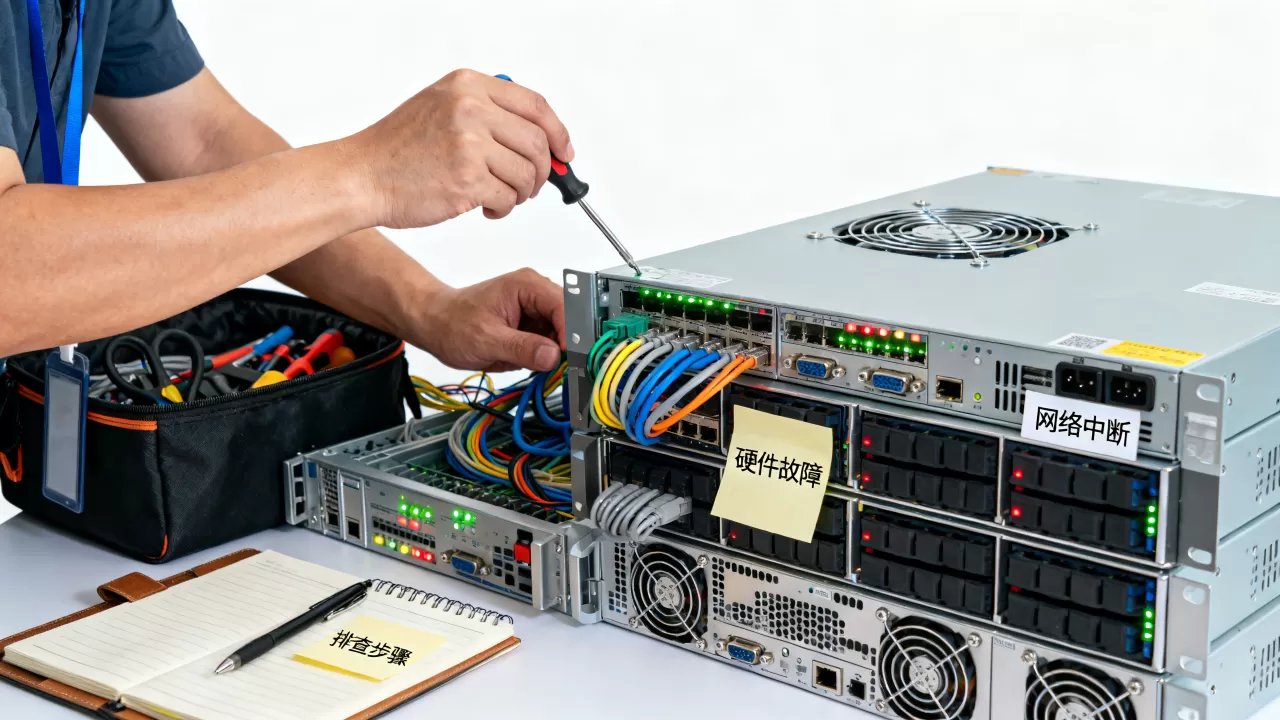
有心跳服务器的业务,配置了主从复制,从库和主库版本不一致,binlog格式对不上,同步中断,主库压力翻倍,然后就崩了。
解决这些问题的思路很朴素:
- 配置变更前做备份,变更新至少保留一个回滚预案
- 小版本修改先放预发布环境跑半天,没问题再上生产
- 每次部署前执行一次配置语法检查,这一步耽误不了三十秒
程序死锁和数据库连接池耗尽
程序代码在开发环境跑得好好的,上了生产就出问题,这种场景每天都在发生。
死锁的典型表现是数据库操作日志里出现大量Deadlock found when trying to get lock,事务互相等待资源,谁都拿不到锁,只能让数据库超时回滚,并发量不高的时候死锁很难出现,一旦运营活动把流量顶上去了,问题就集中爆发。
连接池耗尽是另一个经典故障,应用配置的连接池上限是100个,某个接口处理慢,连接迟迟不归还,新请求拿不到连接,服务就处于半死不活的状态,表现为页面白屏或超时,进程活着,但什么活都干不了。
建议业务高峰期加大连接池上限,排查慢查询,再把接口超时时间从默认的30秒砍到5秒快速失败比无休止等待好得多。
服务器宕机原因盘点:攻击、流量与运维失误
服务器宕机原因盘点这一块,有个共同点:都不是服务器自己坏了,而是被外部力量或人为因素搞停了。
DDoS攻击和恶意扫描,打讲师承
攻击者用大量肉鸡向你的IP发送垃圾数据包,把带宽打满,正常用户就进不来了,这类攻击持续时间短则半小时,长则几天,电商、游戏、金融类站点是重灾区。
处置路径是清晰的:
- 接入高防IP或CDN隐匿源站IP
- 开启防火墙的SYN Flood防护和ICMP限速
- 业务端口做白名单放行,管理端口只允许公司IP访问
恶意扫描的行为更隐蔽,攻击者扫到你开了某个不常使用的端口,比如Redis的6379端口没设密码,扫出来之后直接用flushall命令清空缓存,或写入计划任务反弹shell,服务器就算没完全停,业务也基本瘫了。
护好服务器,先从关掉不必要的端口开始,再给所有对外服务加上强密码和fail2ban。
突发流量超过架构承载上限,热门事件能冲垮服务器
服务器配置是根据日常流量买的,但突发流量不讲道理,某条新闻上了热搜,某个商品突然降价,用户一窝蜂地涌进来,单台服务器的连接数直接打满,Nginx报too many open files,数据库连接数超限,整个站点就卡死了。
行业共识认为,应对这类问题最有效的手段是扩展与缓冲:
- 静态资源全部上CDN,让边缘节点扛住大头流量
- 动态请求加一层消息队列或缓存,削峰填谷
- 应用层做限流降级,高峰期牺牲部分非核心功能,保住核心接口
2026年某电商平台大促期间,网关层限流策略保全了订单系统,但优惠券页面直接降级,这个操作至今被运维圈当教材讲。
运维操作失误,人比机器更不靠谱
机器不会故意犯错的,人的失误却是停服原因里最憋屈的一种。
误删生产库发生在凌晨一两点,犯困的运维在跳板机上敲错命令,rm -rf删了数据目录,或DROP TABLE手滑少打了个WHERE条件。重启顺序出错发生在部署时,先停旧服务后拉新代码,新代码起不来,旧服务也停了,业务就断在那里。
想减少这类事故,可以试试几个笨办法:
- 命令执行前加一个确认步骤,让脚本停下来等人工输入
yes - 生产环境禁用root直接登录,必须通过审批跳板机执行操作
- 高危命令统一走自动化平台,禁止在终端手动执行
服务器维护一般多久?停服前有哪些征兆
服务器维护一般多久这个问题,要看维护的类型,计划内和计划外的差距很大。
计划内维护和计划外故障的时间差异
计划内维护通常是升级系统补丁、更换硬件、迁移机房,这类停服时间可以按小时计算,普通补丁更新需要十几分钟,数据库版本大升级需要四五个小时,迁移机房可能要一天,提前公告用户即可。
计划外故障就不好说了,硬盘坏了,有热备盘的情况下几分钟到半小时能自动切换,备盘也坏了的话得等厂商送盘,加上数据恢复的时间,几个小时到几天都有可能。
停机维护公告模板里应当包含三个要素:起止时间、影响范围、补偿措施,时间给宽裕些,宁可提前恢复,不要拖堂。
日志里的前兆信号
服务器停服之前,日志系统通常已经不安静了:
- 内存使用率从70%缓慢爬升到95%以上,且一直不降
- 磁盘IO等待时间越来越长,
iostat命令看到的%util接近100% - 应用日志里报错频率明显上升,从每天十几条变成每小时几十条
- 数据库慢查询日志半小时内陡增到上百条
这些现象出现时,服务器还没挂,但已经在呼救了,给服务器装个监听脚本,或用开源的Monitoring系统盯住这几个指标,能救下不少业务。
游戏服务器停服补偿与停服原因的联系
游戏服务器停服补偿这个话题,让玩家又爱又恨,游戏厂商对停服的处理方式,能直接反映出停服原因的判断水平。
如果是计划内维护,通常提前48小时出公告,补偿内容基本固定,但如果是紧急停服,比如硬件故障或程序崩溃,补偿就得看停服时长和停服时间点了。
游戏服务器停服补偿常见的标准可以参考这个表:
| 停服时长 | 常见补偿 |
|---|---|
| 30分钟以下 | 小礼包、体力药剂 |
| 30分钟到4小时 | 钻石/金币+限时道具 |
| 4小时以上 | 大量代币+限定称号或皮肤 |
时间点很关键,晚上七八点玩家在线高峰期停服,补偿力度通常要翻倍,否则玩家直接跑到社交平台开团,舆情压力全给到运营那边。
想减少游戏停服,测试环节要前置到位,新版本上线前在测试服完整验证一周,重点看高并发场景下的服务器压力表现,磨刀不误砍柴工。
服务器停服原因排查常用命令速查
- 磁盘:
df -h查看分区使用率 - 内存:
free -m看实际可用内存 - 负载:
top看CPU和内存占用TOP10进程 - 网络连接:
netstat -anp | grep -i est看当前连接数 - 系统日志:
tail -f /var/log/messages - 登录历史:
last -20排查异常登录 - 误删找回:
extundelete只适用于ext文件系统,越早操作成功率越高
关于服务器停服原因的常见疑问
服务器停服原因有哪些是可以通过监控提前发现的?
大部分都可以提前发现。磁盘使用率持续上升、内存泄漏曲线、连接数逼近上限、接口响应时间变长,这些都有日志和数据积累,配置好阈值告警就能提前介入,真正无法预判的主要是硬件突然损坏和突发的恶意攻击,所以前提是别偷懒,免费的zabbix或cAdvisor配起来,十分钟的事儿,能解决大多数烦恼。
网站服务器不稳定是什么原因造成的,为什么重启就好了?
最常见的原因有三个:进程内存泄漏、连接未释放、缓存堆积导致查询效率变慢,重启把内存里的垃圾都清了,连接全部重置,服务自然就恢复了,但重启只是治标,根本解决办法是找到泄漏的代码,把连接池和多余的缓存问题真正解决掉。
服务器宕机原因排查顺序应该怎么安排?
先看网络能不能通,ping和telnet走一遍;再看CPU和内存有没有被打满;然后看磁盘和IO;最后才看应用日志,顺序逻辑是从底层到上层,先排除硬件和系统层面的问题,再怀疑应用本身,多数情况下,走完前三步就能定位到问题方向。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/726925.html