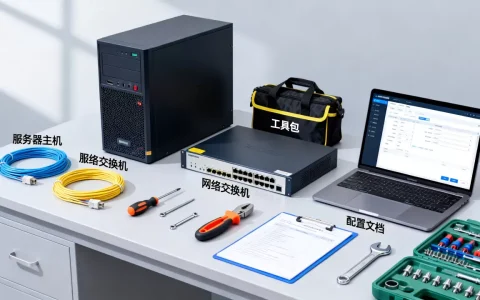
响应时间一点点变长、错误率开始冒头、CPU和内存长时间高位运行,以及磁盘IO卡到原地转圈,抓住这些信号,你完全有机会在业务停摆之前完成救火。
服务器崩溃预兆有哪些:从响应变慢到连接被拒
服务器不会一夜之间突然暴毙,它更像一个硬撑的打工人,累了先打哈欠,再变迟钝,最后才趴下,崩溃前最典型的表现可以归纳为四个阶段。
网站服务器不稳定表现:请求延迟和错误率同步上升
当网站开始出现“打开转圈圈”、图片加载半天出不来、接口偶尔报超时,说明服务器已经在超负荷工作,这时候你去翻监控面板,大概率会看到平均响应时间从几十毫秒涨到几百毫秒,同时5xx错误率开始出现小尖峰。延迟和错误率同步上升,是服务器崩溃前最常见的二重奏。
判断标准很简单:如果错误率在连续5分钟内持续超过1%,并且每次刷新都有新的5xx出现,你就得把待办事项全部放下,优先处理这台机器。
从CPU空闲到内存耗尽:系统日志里的求救信号
另一个容易被忽略的预兆是系统日志,服务器在崩溃前会疯狂写日志,像是dmesg输出“Out of memory”、内核提示“Killed process”、或者Nginx报“connect() failed (112: No buffer space available)”,这些记录不是废话,而是系统在崩溃前的最后几封求救信。
内存耗尽会导致内核直接杀掉进程,尤其是数据库和PHP-FPM这类常驻进程,一旦被杀,业务立刻雪崩,所以当你看到日志里出现OOM关键词时,距离崩溃往往只剩几分钟到几小时。
服务器崩溃前兆怎么排查:先看CPU和内存的高频告警
知道预兆之后,下一步是动手排查,很多运维新手一上来就重启服务,结果没过多久又崩了,正确的做法是抓住高频告警,按顺序查。
服务器CPU飙高原因:排队等待的计算任务
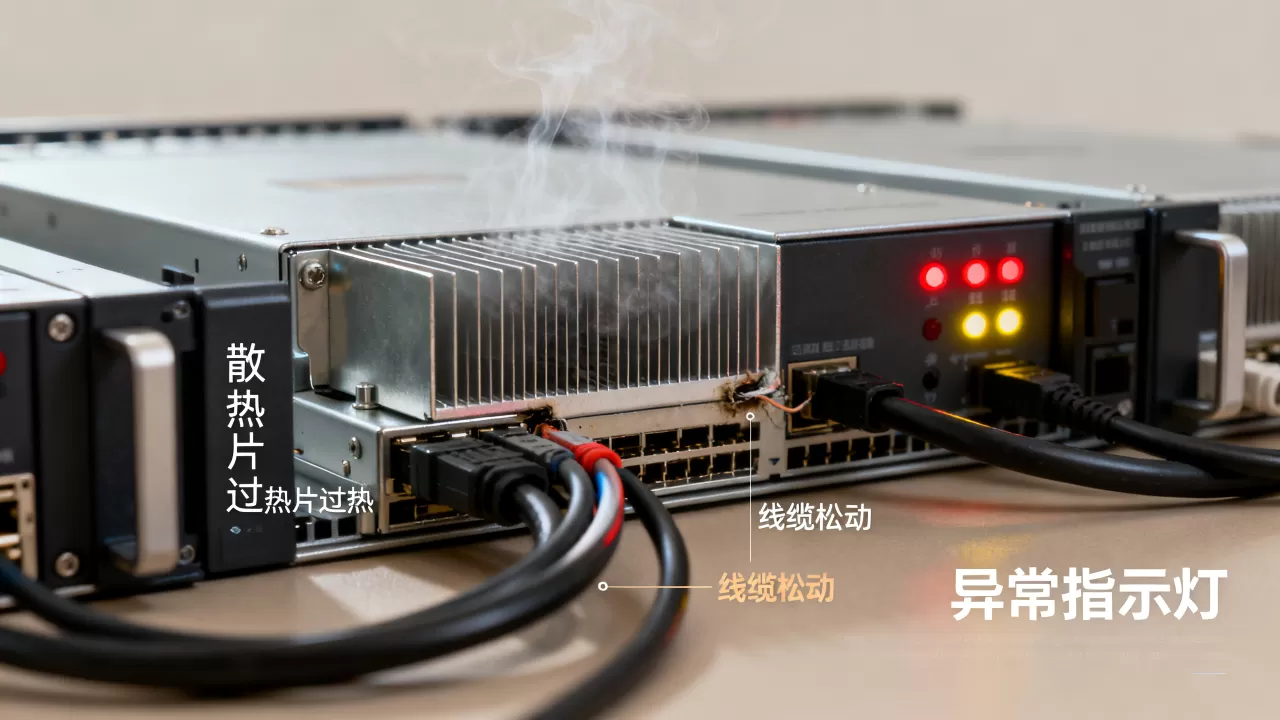
CPU飙高不等于马上要崩,但持续飙高就值得警惕,当你用top命令看到CPU idle接近0%,而wa数值不断上涨,说明计算任务已经排成长队,系统正在拿时间换进度。
排查步骤通常这样走:
- 用
top按CPU排序,找到占用最高的进程ID - 用
perf top或strace -p PID看进程到底在干什么 - 检查是不是出现了死循环、慢SQL、或者某个抓取脚本在无节制跑任务
如果是数据库导致CPU飙高,大数据量查询和缺少索引是最常见的凶手,你可以打开慢查询日志,看看有没有执行时间超过1秒的SQL语句。
内存与磁盘IO的恶性循环
服务器崩溃前兆不只是CPU,内存和磁盘IO更像是两兄弟。当内存不够时,系统会拼命使用swap交换分区,磁盘读写压力随之暴涨,进而拖慢所有IO操作。你会发现top命令里si和so两项数值很大,free命令显示available内存小于100MB,iostat里%util已经接近100%。
这时候你可以试试:
- 用
free -h确认内存余量,并检查swap占用 - 用
iostat -x 1观察磁盘等待时间和队列长度 - 用
ss -s查看socket连接数,看会不会是连接太多导致内存碎片
如果以上命令执行之后都显示异常,基本上可以判断服务器正处在崩溃边缘,提前增加内存、优化程序内存占用、或者调整swap配置,都是有效的抢救手段。
用监控指标提前锁定崩溃风险
光靠人工盯top命令是不够的,更靠谱的方式是建立一套监控指标,让服务器自己发出预警,行业共识认为,监控阈值应该设在实际业务低谷时的三倍左右,而不是参考某个固定数值。
关键指标与危险信号对照
下面的表格整理了服务器崩溃前最值得关注的几项指标,你可以对照设置告警:
| 指标 | 正常波动范围 | 危险信号 |
|---|---|---|
| CPU使用率 | 30%-50% | 持续15分钟高于85% |
| 内存剩余 | 总内存的20%以上 | 低于5%且swap持续增长 |
| 磁盘IO等待时间 | 平均小于5ms | 超过50ms且队列长度大于4 |
| 平均负载(load average) | 小于CPU核数 | 连续三次数值超过CPU核数两倍 |
| 5xx错误率 | 0% | 超过1%且持续上升 |
以一台4核服务器为例,load average如果超过8,并且持续10分钟不回落,意味着进程排队严重,接下来的用户体验就是无限转圈。
自动预警与日常巡检怎么配合
监控工具可以选择Zabbix、Prometheus、Grafana组合,也可以简单使用脚本加crontab,关键在于设置合理的告警通知,不要所有指标都推微信,那样反而容易疲劳。建议把CPU和内存告警设为最高优先级,磁盘IO和错误率设为次要级别。
日常巡检时,可以每天固定时间段执行一条命令组合:
uptime && free -h && iostat -x 1 3 && tail -200 /var/log/messages
这条命令能同时看到负载、内存、磁盘IO和系统报错,比单一指标更全面。
从预兆到崩溃:一个典型的故障时间线
为了让预兆更直观,我们来看一个虚构但很典型的场景。
某天下午三点,你的电商网站开始变慢,监控显示CPU使用率从40%慢慢爬到65%,这时候你还觉得是流量小高峰,没在意,到了四点半,CPU已经冲到90%,平均响应时间从200ms涨到800ms,数据库连接池开始报错,五点钟,内存被慢查询耗尽,OOM进程杀掉了一部分PHP-FPM,紧接着Nginx开始返回502,五点十分,全部用户看到“服务器开小差”,你的手机告警才开始疯狂轰炸。
整个过程大约有两个小时的可干预窗口。 如果在下午三点就把CPU持续上涨当作崩溃前兆来处理,完全可以在业务高峰前加实例、限流、重启慢查询进程,避免后面所有的连锁反应。
为什么预兆经常被忽略
忽略了这些服务器崩溃预兆,多数时候是因为告警阈值设得太高,或者监控曲线看的是平均值,平均值会隐藏峰值:CPU平均50%时,可能其中一台核已经跑满,其他核闲置,解决的办法是看分位数,尤其是P95和P99延迟,它们比平均值更能反映真实体验。
常见问题与解答
服务器崩溃预兆有哪些最值得优先关注?
最值得优先关注的是CPU持续高负载、内存不断下降、磁盘IO等待时间显著增加、请求错误率上升,这四个指标如果同时出现两个以上,基本上意味着服务器已经进入高危状态。
服务器卡顿怎么排查,是否需要立刻重启?
不要立刻重启,先通过top、free、dmesg收集现场信息,确认是内存泄漏、慢SQL还是连接数耗尽,重启只能暂时恢复服务,但如果不找到根因,问题会在几小时或几天后再次出现,正确做法是保留崩溃现场,再针对性处理。
网站突然打不开一定能说明服务器崩溃了吗?
不一定,网站打不开也可能是域名解析失败、防火墙拦截、CDN回源异常或上游数据库挂掉,你需要先检查本地能否ping通、浏览器访问是超时还是拒绝,再登录服务器查看Nginx日志和内核日志,多数情况下,连接被重置比超时更接近崩溃状态,因为说明进程仍在,但请求已经无法完成。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/712483.html