硬件健康、操作系统资源、业务应用、网络链路,每一项都不能省。
很多团队把监控想得太简单,以为装个面板看一眼CPU负载就算完事,实际上服务器出问题从来不是单点爆发,而是层层传导,硬件坏之前一定有预兆,系统卡顿之前一定有资源争抢,应用报错之前一定有调用异常,网络抽风之前一定有丢包波动,监控就是要把这些“之前”抓出来。

如何监控服务器运行状态:先看硬件再看系统
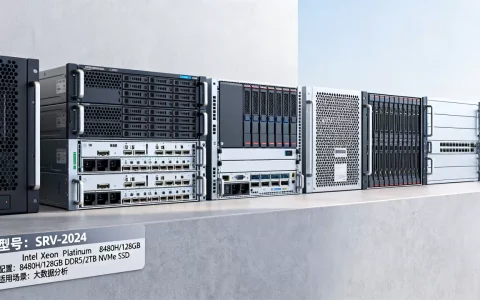
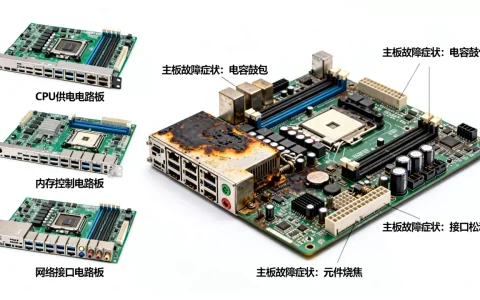
监控的第一站不是软件,而是机房里的那台机器本体,物理服务器最怕的是闷声坏零件,硬盘坏道、内存ECC报错、电源模块老化,这些不会直接让服务下线,但会让数据一点点不安全,硬件层监控的重点有三个:温度、硬盘健康、内存条错误。
温度是最容易忽略的杀手,机房空调故障或者机柜通风不畅,温度超过警戒线后CPU会强制降频,性能瞬间掉一半,去服务器带外管理系统(比如IPMI或者iDRAC)看一眼传感器读数,能发现当前进风温度和CPU核心温度的差值,如果回风温度和进风温度差别太大,说明机柜散热路径被堵了。
硬盘健康要查SMART信息,Linux下跑一条smartctl -a /dev/sda,重点看Reallocated_Sector_Ct和Pending_Sector这两个值,前者表示已经替换掉的坏道数,后者表示等待处理的扇区数,只要这两个值不为0,就说明硬盘已经有物理损伤,接下来要准备换盘。
内存错误容易被当成偶发,dmesg日志里如果反复出现EDAC MC0: UE或者CE报错,说明单条内存出现了不可纠正或可纠正错误,行业共识认为,内存报错不要猜测,宁可停机换条子,也不要等它变成数据损坏。
Linux服务器CPU与内存监控命令详解
系统资源层监控,操作路径最标准,也最容易上手,登录服务器后第一眼要看的就是uptime,关注15分钟平均负载,负载高于CPU核数,说明任务在排队;连续半小时负载飙高,基本可以判定有问题。
CPU要看细一点,top进入交互界面后按1看每个核心的使用率,重点关注us(用户态)和sy(系统态)的占比。sy长时间超过30%,说明系统内核在做大量调度和I/O操作,可能是磁盘瓶颈,接着按x高亮排序,找出最吃CPU的进程,记下PID,用top -Hp PID看它内部的线程分布,能快速定位到具体代码段。
内存监控用free -m只够看个大概,更关键的是vmstat 1 10里的si和so字段,这两个字段表示Swap换入换出量,只要持续大于0,说明物理内存不够用了,应用在跟磁盘做交换,严重的会有毛刺性卡顿,用
ps aux --sort=-%mem | head -20能查到底是谁在吃内存,如果单个JVM进程常驻内存超过物理内存的一半,大概率是堆配置不太合理。
磁盘监控不止看剩余空间,更要看I/O等待时间。iostat -xm 1里面的%util接近100%时,磁盘已成为瓶颈,对数据库服务器来说,await超过20毫秒就说明I/O路径有问题,再结合df -h看分区使用率,根分区超过85%就该清日志了,别等到写满文件系统导致服务崩溃。
云服务器监控和物理服务器监控的区别在哪里
这个问题的答案不止“有没有硬件监控”这么简单,云服务器的底层是共享物理资源,你只能监控到分配给自己的那部分,物理服务器的整机监控可以直接看到所有硬件状态,而云机只能看到实例内部的操作系统视图,宿主机发生了什么,你是完全看不见的。
CPU抢占。 云厂商给的CPU规格是逻辑核,实际物理核和邻居共享,如果宿主机上有高负载的“吵闹邻居”,你的实例即使CPU使用率看起来很低,也会出现缓慢的响应时间,这是云监控无法覆盖的部分。
网络虚拟化丢包。 云平台转发层的丢包和延迟波动,在你的监控里只会看到TCP重传增加,但看不到具体发生在哪个物理交换机上,绝大多数情况下只能提交工单让云厂商排查。
所以云服务器监控的重心要从“硬件”挪到“实例指标”上。 重点盯云监控面板里的突发积分、流量限速、磁盘IOPS上限,部分云厂商提供基础带宽达标率,低于这个达标率时实例会被降速,这是比CPU负载更优先检查的项目。
自建监控到底该用哪些服务
很多团队都会纠结一个问题:到底该用开源自建,还是买商业SaaS,操作路径上有明确分歧。
开源路线最典型的是Prometheus加Grafana的组合,Prometheus负责抓取指标,node_exporter采集主机数据,blackbox_exporter做端口拨测,这套方案免费,但配置成本不低,你需要自己写告警规则,自己维护告警路由,还要做高可用部署,否则监控系统本身一崩,你连查故障的入口都没了。
商业监控产品(比如简米云监控、酷番云观测、UptimeRobot)的优势是接入快,云主机装个Agent五分钟就能看到基础指标,自带告警短信和电话能力。相当一部分中小团队选择云厂商自带监控加开源自建的混合方案:日常看云监控面板,自己搭一套Prometheus处理定制化告警。
服务器监控软件哪个好:看场景,不看出身
没有任何一款监控软件适合所有服务器环境,数据库服务器、Web集群、游戏网关、对象存储各自的需求差异很大,选型要先回答三个问题:监控对象有多少台、告警需要多快触达、历史数据存多久。
纯Linux小规模集群(少于20台),使用Prometheus加Alertmanager足够了,抓取间隔设为15秒,告警通过邮件和企业微信机器人推送,一台2核4G的云主机轻松扛住,但Prometheus默认本地存储不适合长期保留数据,超过15天就要考虑加Thanos来做数据归档。
Windows环境的服务器群组,建议考虑Zabbix,它对Windows性能计数器的支持比Prometheus更完善,可以监控到IIS连接数、Active Directory复制状态这些Windows生态指标,甚至可以通过代理方式监控不开放端口的设备,这条路在Prometheus里要麻烦不少。
混合机房环境(物理和云共存),商业监控平台的运维负担更小,很多商业方案自带硬件监测插件,能直接读取物理机的IPMI数据,把温度、电压、风扇转速汇入统一告警面板,省去了一条一条手工对带外地址的麻烦。报警能力是核心分水岭,开源自建大多只能做到邮件和企业微信推送,电话语音告警还得额外接服务,商业产品一般自带。
网络层监控:端口、延迟和丢包一个都不能少
应用监控和系统监控解决的是“机器还能不能用”,网络监控解决的是“用户能不能访问到”,网络层监控最简单的路径是外部拨测,在机房以外的地方部署探针,定时发起请求。
有相当一部分案例里,服务器CPU和内存完全正常,但用户反馈打不开网页,最后排查下来是机房入口路由的某个上游节点出了故障,这类问题靠服务器内部监控根本发现不了,必须用外部视角去看链路质量。
具体做法用mtr命令看整条链路每一跳延迟和丢包率。mtr -r 目标IP连续跑十分钟,如果某一跳的Loss从0%变成10%,而后续节点也同步升高,问题大概率出在这一跳,再用tcpdump -i eth0 tcp port 80抓包确认有没有大量TCP SYN重传标记,如果有,说明数据包在网络中途被丢弃了。
对公网业务来说,DNS解析质量也值得加进监控范围,用dig @8.8.8.8 你的域名对比自建DNS返回的IP是不是最新的,以及各地DNS响应时间差异大不大,很多割接事故就是改了DNS记录但缓存没真正生效。
报警策略:别让每一个指标都喊救命
把该监控的指标都接进来之后,最大的坑是报警疲劳,每五分钟一条“CPU超过80%”只会让值班的人麻木掉,报警规则要设计得像人做判断那样有层次
。
常规做法是三级告警体系:
- P3警告级:持续10分钟CPU超过90%但未影响响应时间,通过群消息提醒,白天人工看一眼。
- P2严重级:负载持续上升且服务延迟超过500毫秒,自动触发电话通知值班人员,同时拉起备用节点。
- P1紧急级:服务连续3分钟不可用,电话逐级上报,自动执行预先写好的健康检查脚本确认故障边界。
很多运维事故复盘都会提到“监控没有翻译成业务语言”,技术指标要挂在对应业务上:用户注册量下降时,数据库慢查询数是不是同步上升;下单失败率增加时,后端接口P99延迟有没有突破2秒。指标之间的关联分析,比单看某一个指标更有意义。
存储监控数据的时间也要规划好,付费商业平台通常只能保存六个月的监控数据,开源自建可以无限保存,但存储成本要自己承担,近年来的通行做法是保留两条线:原始指标数据存3个月,用于日常排障;聚合统计指标存一年以上,用于容量趋势预测。
Q&A 模块
服务器监控多少钱一年才算合理?
基础需求下成本可以压得很低:开源方案零采购费,自己花点时间部署,告警走企业微信免费通知,唯一支出是保存历史数据的磁盘空间,业务规模扩大后选择商业监控产品,常见收费方式是按主机数量按月计费,数台服务器一年的费用大概是千元级别,几十台的规模大概率需要数万元预算,物理机和云主机的收费大体一致,如果还需要分钟级拨测和电话告警,价格再上浮一些,整体来看,监控成本占IT基础设施总预算的比例一般不超过5%。
如何设置服务器监控告警阈值?
大原则是区分稳定指标和波动指标,CPU、内存这类稳定指标设置相对固定的阈值:CPU整体超过90%持续5分钟告警,内存可用量低于10%告警,延迟和流量这类波动指标不适合固定阈值,建议用动态基线,即系统自动统计过去14天的均值,偏离均值3倍标准差时触发告警,避免误报。
监控服务器网络延迟用什么命令排查?
最直接的诊断命令是ping和mtr。ping看的是主机到目标IP的往返时间和丢包率,适合判断整体连通性。mtr综合了traceroute和ping的功能,能输出每一跳路由的延迟和丢包,帮助确定问题在哪个节点,分析持续连接应用(比如数据库或WebSocket)的内部网络质量时,用ss -ti查看TCP重传次数和RTT均值,这两个值异常升高说明链路存在不稳定因素。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705303.html