服务器集群的本质,是把多台普通服务器通过软件组合成一个对外只呈现单一入口的整体,用冗余换稳定、用分工换性能,它的核心特点集中在高可用、可横向扩展、负载均衡、状态共享、成本与复杂度并存这五个方面,理解这几条,选型和运维基本就不会跑偏。
很多团队第一次接触集群,是在单机扛不住流量、或者一台机器宕机导致业务停摆之后,这时候把三五台服务器拼在一起,业务确实稳了,但新的问题也随之而来:配置怎么同步、故障怎么定位、扩容怎么不中断,下面按特点、区别、选型、验证的顺序讲清楚。

服务器集群到底是什么,先从它的角色分工说起
集群不是简单地把几台机器用网线连起来,它更像一家餐厅的后厨:有人负责接单分配(调度层),有人负责炒菜出餐(工作节点),还有一套公共的备菜区和账本(共享存储与配置中心),三层各司其职,才会出现“某台机器挂了,客人完全没感觉”的效果。
集群里的三类角色
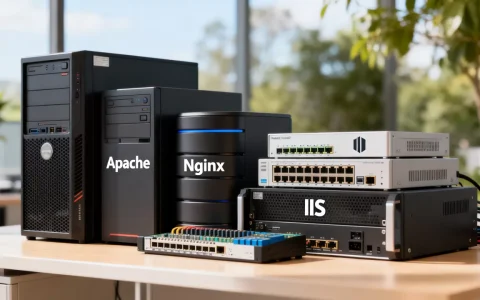
- 调度与入口层:Nginx、HAProxy、LVS、Keepalived 这类组件,负责把请求分发给后端节点,同时用虚拟 IP(VIP)保证入口本身不成为单点。
- 计算与工作层:真正跑业务进程的节点,可以是 Web 服务器,也可以是容器里的 Pod,数量可以从三台扩到上百台。
- 共享状态层:数据库主从、Redis 哨兵、分布式存储(如 Ceph)、配置中心(如 etcd、Consul),解决“多台机器怎么看到同一份数据”的问题。
缺了第三层,集群往往只是“多开几台机器”,一旦数据不一致,问题比单机更难查。
服务器集群的六个核心特点
高可用:坏一台不影响开门
这是集群最原始也最刚需的价值,单机宕机就是业务中断,集群里一个节点掉线,流量会被健康检查自动摘除,用户端可能只是某次请求慢了几百毫秒。
实现上通常靠“心跳 + 选举 + 漂移”三步:节点之间定时发心跳,主节点失联后由备用节点接管虚拟 IP 或服务角色,业内常见的做法是 Keepalived 配 VRRP 协议,配合脚本监控业务端口,而不是只 ping 通就算健康。
可横向扩展:加机器就能加能力
集群的扩容是“横向”的性能不够,多加一台节点,容量近似线性增长,这和给单机加内存、换 CPU 的“纵向扩展”是两条路,纵向扩展有物理上限,而且升级往往要停机;横向扩展只要调度层配置跟上,可以做到业务无感知。
实践中要注意:无状态服务扩容最轻松,有状态服务(数据库、缓存)扩容就要考虑分片和再平衡,动作会重很多。
负载均衡:把活儿分匀,而不是全压给最能干的那个
分发策略直接决定集群的实际表现,常见的有轮询、加权轮询、最少连接数、一致性哈希,短连接为主的 Web 服务用加权轮询就够,长连接或缓存类服务用一致性哈希能减少节点变动带来的缓存穿透。
调度层本身也要做冗余,否则入口挂了,后面几十台节点都是摆设。
状态共享:集群最难的那道坎
无状态服务做集群很容易,有状态服务才是真正的分水岭,数据库集群要解决主从复制延迟、脑裂、写冲突;分布式存储要解决数据副本和一致性,配置上如果各节点各写一份,迟早会出现“三台机器三种配置”的经典事故。
解决办法通常指向同一方向:配置集中管理,数据副本化,任何单点可重建。
成本与复杂度并存
硬件成本只是账面的一部分,多节点带来的网络设备、机柜空间、电力消耗,以及运维人力的投入,往往被低估,业内专家指出,集群规模上去之后,监控、日志、发布、故障演练这几块的投入,会逐渐超过硬件本身的成本。
故障域收敛与可观测性要求提高
集群把风险分散了,也把问题藏深了,单机时代看一条日志就能定位,集群里一个请求可能穿过四五个节点和服务,没有统一的日志收集、链路追踪和指标监控,排障时间反而更长。
服务器集群和负载均衡有什么区别
这是搜索量最高的一类疑问,简单说:负载均衡是集群的一个零件,而不是集群的全部。 一台 Nginx 做反向代理到三台后端机器,可以说是“有负载均衡的小集群”;但如果三台后端之间没有健康检查、没有配置同步、没有数据副本,那就只是“转发”,谈不上完整的高可用集群。
| 形态 | 冗余能力 | 扩容方式 | 典型短板 |
|---|---|---|---|
| 单机部署 | 无,宕机即中断 | 升级硬件,常需停机 | 物理上限、单点故障 |
| 主备模式 | 备机平时闲置 | 换更强的主机 | 资源利用率低、切换靠人工 |
| 负载均衡 + 多后端 | 后端可摘除 | 加后端节点 | 调度层仍是单点 |
| 完整集群 | 入口与节点均可冗余 | 横向加节点 | 运维复杂度和成本上升 |
行业共识认为,判断一套系统算不算集群,看两个指标就够了:入口有没有冗余,数据有没有副本,两者缺一,都只能算“半套”。
中小型企业服务器集群怎么搭建,先算清成本再动手
服务器集群搭建需要多少钱
这个问题没有标准答案,但可以给一个量级参考,集群的最小可用单元通常是三节点:调度层两台做 VIP 漂移,工作节点至少两台,数据库再加主从,硬件门槛就落在“三到五台通用机架服务器”这个区间,单台配置按业务负载从几千到两三万不等,整体硬件投入多在几万元到十几万元。
如果选择云上部署,成本结构就变成按月付费加带宽和存储,前期现金流压力小,但长期跑满负载时,总支出往往高于自建,选择哪条路,取决于业务是长期稳定负载还是波动明显。
选型的三条判断线
- 业务能不能停:能接受分钟级停机,主备加脚本切换就够;要求秒级恢复,才需要完整集群。
- 有没有状态:全是无状态接口,集群门槛低;自研核心数据库,慎重上多主。
- 有没有人管:没有专职运维,优先选托管服务或成熟发行版方案,别自己从零拼组件。
落地步骤(以三节点 Web 集群为例)
- 规划网段,固定各节点 IP,预留一个未使用的 VIP 给 Keepalived。
- 两台入口机安装 Nginx 与 Keepalived,
/etc/keepalived/keepalived.conf中配置virtual_router_id(两机必须一致)、priority(主高备低)、virtual_ipaddress。 - 用
nginx -T | grep upstream确认后端节点列表已经写入配置。 - 在两台入口机上启动服务:
systemctl enable --now nginx keepalived。 - 用
ip addr show查看 VIP 是否落在主机上,随后在主机执行systemctl stop keepalived,观察 VIP 是否漂移到备机,业务是否连续。 - 配置集中管理,把 Nginx 配置放到 Git 仓库,用 Ansible 或配置中心统一下发,避免手工改出三种版本。
上线之后,怎么验证集群真的高可用
配置写完不等于集群可用,建议把下面几项做成定期演练,而不是等出事再试。
- 节点摘除:在入口机上临时关掉一个后端
systemctl stop nginx,观察健康检查多久把该节点标记为 down,用户请求是否报错。 - 入口切换:停掉主入口的 Keepalived,记录 VIP 漂移耗时,多数情况下要求在秒级完成。
- 数据库主从:登录从库执行
SHOW SLAVE STATUS\G,重点看Seconds_Behind_Master是否长期为 0。 - 容器集群:
kubectl get nodes查看节点状态,kubectl describe node <节点名>查看资源压力,kubectl drain模拟节点下线,确认 Pod 能否在其他节点重建。 - 分布式存储:
ceph -s查看HEALTH_OK与副本状态,副本不足会直接反映在输出里。 - 压测:用
wrk或ab灌流量,对比扩容前后吞吐变化,验证“加机器真的加能力”。
关于服务器集群特点的常见问答
服务器集群的机器数量是不是越多越好
不是,节点越多,一致性协议的开销、心跳流量、配置同步的复杂度都会上升,小规模业务三到五台就能覆盖可用性需求,盲目堆机器反而会拉长故障定位时间,真正该关注的是单点有没有消除,而不是节点数字。
服务器集群和云服务器的高可用是一回事吗
不完全一样,云厂商提供的是底层多可用区、多副本能力,保证的是“机器和磁盘不丢”;集群保证的是“业务进程不中断”,云上照样需要自己做入口冗余、健康检查和数据副本策略,只是省略了硬件层面的那部分工作。
没有专职运维的小团队能上集群吗
可以,但要收敛技术栈,优先选带健康检查和自动切换的成熟托管服务,自建部分尽量限制在一两个组件,避免同时维护调度、分布式存储、配置中心三套系统,集群的代价从来不在搭建那天,而在长期值守。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/783787.html