本地服务器监控实现实时状态监控的核心思路,就是让监控工具通过代理或标准协议,以秒级或分钟级频率持续采集CPU、内存、磁盘、网络等指标,并同步推送告警和可视化展示。这条路走顺了,你坐在办公室就能看到机房那台服务器的“心跳”。
本地服务器监控怎么实现实时状态?先搞懂采集原理
很多人以为“实时”就是把刷新频率调到1秒,本地服务器监控的“实时”是一个分层概念:指标采集频率、数据展示刷新率、告警响应延迟,这三者共同决定了你的体感。
本地服务器监控系统通常采用两种采集方式:
- 主动轮询:监控端按固定间隔(比如5秒或30秒)向被监控服务器发送请求,获取CPU使用率、内存占用、进程状态等数据,这种方式实现简单,大部分开源工具都在用。
- 被动推送:在被监控服务器上安装一个Agent,由Agent主动把数据推送到监控端,这种方式实时性更高,因为服务器本身知道自己的异常状态,比如进程崩溃、端口丢失,能第一时间上报。
行业共识认为,生产环境最稳妥的做法是“轮询为主,推送为辅”,用SNMP协议做基础指标采集,再配合Agent做进程级和日志级的细粒度监控。
本地服务器监控怎么实时采集CPU和内存?
CPU和内存是运行状态的晴雨表,在Linux上,你可以直接执行top命令看到实时负载,但脚本化监控更推荐读取/proc/stat和/proc/meminfo,每秒钟读取一次这两个文件,用后一时刻的数值减去前一时刻的数值,就能算出真正的CPU占用率。
Windows服务器则简单很多,用typeperf命令或者PowerShell的Get-Counter即可。
Get-Counter -Counter "Processor(_Total)% Processor Time" -SampleInterval 2 -MaxSamples 3
这条命令每2秒采样一次,连续3次,结果就是本机CPU实时使用率,把输出重定向到监控平台的采集器,就能看到曲线变化。
监控本地服务器的核心步骤:从部署到告警
无论你用什么工具,实现实时监控都绕不开这四个阶段。
- 定义监控对象:列出需要监控的服务器IP、业务角色、硬件配置,别漏了虚拟化环境中的宿主机和VM。
- 选择采集方式:标准SNMP、SSH脚本、Agent插件,三者可以混用,SNMP适合网络设备,Agent适合深入系统内部。
- 设定阈值和告警策略:CPU持续超过80%持续5分钟,磁盘空间剩余少于10%,这些都要触发不同等级的告警。
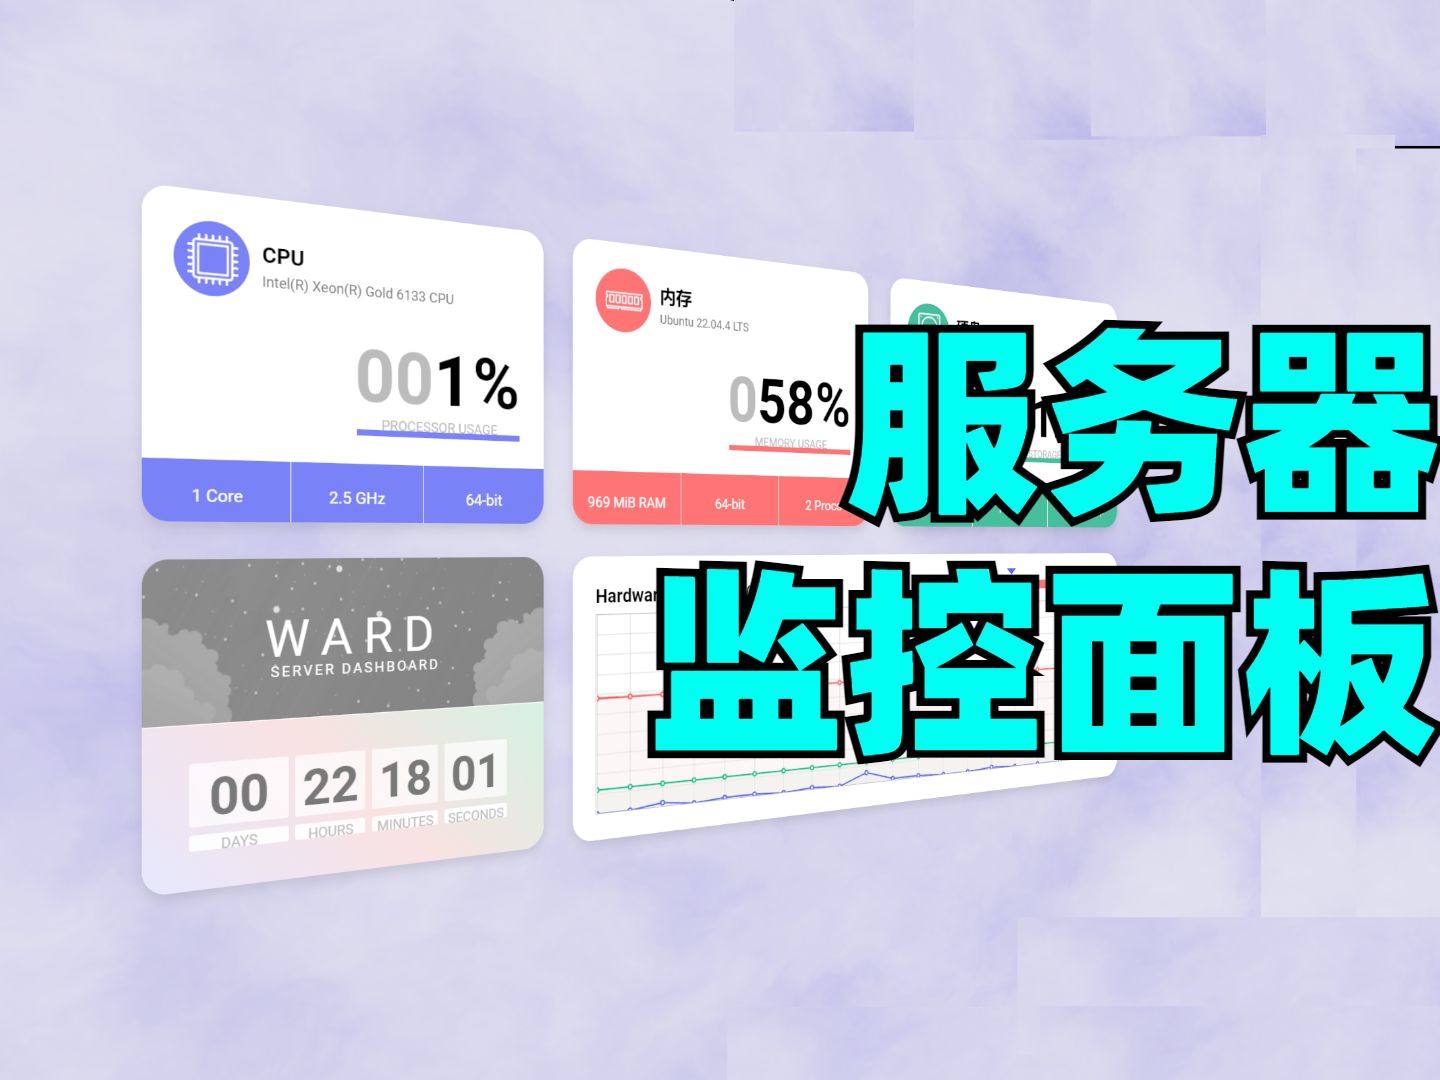
- 构建可视化面板:让运维人员一眼看到整体健康度,而不是面对一堆数字发呆。
本地服务器监控软件哪个好?对比常用工具
市面上既有免费开源的,也有商业付费的,选择标准在于你的服务器数量和是否需要技术支持。
- Zabbix:老牌企业级开源方案,支持SNMP、Agent、IPMI等多种采集方式,上千台服务器的场景也能扛住,但配置学习曲线较陡。
- Prometheus + Grafana:现代云原生监控的事实标准,用exporter暴露指标,Prometheus负责抓取和存储,Grafana做可视化,对于本地物理机,可以用
node_exporter搞定,它的实时性很好,默认每15秒抓一次,调整参数后可以做到1秒级别。 - Nagios:经典但略显过时,适合纯告警场景,它的插件生态很丰富,但可视化能力弱。
- 商业方案:如监控宝、Site24x7等,胜在开箱即用,价格一般按监控主机数量计费,以一台服务器为例,服务器监控系统价格大约每年几百到上千元不等,包含短信告警和客服支持。
如果你只是管理几台本地服务器,在局域网里跑一个Prometheus加上node_exporter,半小时就能上线一套实时监控,如果服务器超过50台,建议直接上Zabbix,它的自动发现功能能省掉大量手动添加主机的时间。
实时监控本地服务器的性能瓶颈:磁盘和网络别忽视
CPU和内存只是上半场,磁盘读写和网络流量往往是真正的“隐形杀手”。
磁盘空间耗尽不会立刻让服务器宕机,但会让日志写不进去,数据库事务卡死,监控时关注三个指标:
- 磁盘使用率:阈值建议设置为85%预警,95%告警。
- IOPS和等待时间:用
iostat -dx 1观察%util和await,如果%util持续大于80%,说明硬盘已经忙不过来了。 - inode使用量:文件系统inode耗尽后,即使空间有余也无法创建新文件,用
df -i查看。
网络方面,实时监控的重点不是带宽,而是错误包和丢包率,用ip -s link查看RX/TX error计数,如果服务器网卡不断报错,说明硬件或者网线有问题,内网服务器之间的互访延迟,可以用
tcping脚本持续探测端口来实现。
实验室服务器状态监控场景怎么落地?
实验室或者小公司的本地服务器,通常没有专职运维,这种情况下,实时监控反而要做得更简单:部署一套服务器状态监控工具,每周自动发送一份健康报告到微信或邮件即可。
具体做法是:在Ubuntu 22.04服务器上安装Netdata,这个工具的Agent非常轻量,安装后自带的Web面板能实时展示每一个进程的资源占用,并且默认每1秒刷新一次,它的告警规则内置了CPU、内存、磁盘、网络四类基础项,几乎不用改配置。
对于跑着多个内部服务的Windows服务器,则可以用自带的任务计划程序调用perfmon记录计数器日志,配合statuswd这类小工具,在CPU连续3次采样超过90%时自动重启对应服务。
本地服务器监控告警怎么设置才不漏报?
实时监控的最终目的是告警,很多团队装了监控,却因为阈值设置不合理,导致半夜疯狂收到邮件,最后所有人把告警静音,真正的故障反而没人发现。
设置告警要遵循“分级通知”原则。
- 严重(P1):服务器宕机、CPU 100%持续10分钟、磁盘写满,这些必须立即电话或短信通知值班人。
- 警告(P2):CPU超过80%持续5分钟、内存使用率超过90%,通知到运维群,30分钟内确认即可。
- 提示(P3):磁盘使用率超过70%、网络延迟轻微升高,写入日报,不主动打扰。
告警必须做“抑制”处理,比如同一台服务器CPU和内存同时告警,只发一条合并后的通知,避免信息轰炸。
局域网服务器监控工具如何选型?
如果监控端和被监控服务器都在一个局域网内,没有公网IP,选型时优先考虑内网穿透能力和离线模式。
- 开源工具里的Prometheus + Alertmanager,它天然支持内网部署,告警通过Webhook转发到企微或钉钉机器人,不需要公网暴露。
- 商业工具中,比如SolarWinds Server & Application Monitor,它的局域网扫描功能很强大,能自动发现所有在线设备,但价格较贵,起始授权大概几万元人民币,适合规模较大的企业。
一个容易被忽略的需求是历史数据回看,实时监控看的是当前状态,但问题排查时需要看故障前半小时的趋势图,因此采集频率最好保留在5秒以内,存储周期至少30天,比如Prometheus的TSDB能按时间压缩数据,默认保留15天,建议调大到60天,磁盘占用并不会太夸张。
如何监控服务器状态的几个实操细节
最后补充三个“落地时容易踩坑”的细节,能让你少走弯路。
- 时区统一:如果服务器和监控端的系统时间不一致,告警和日志时间会对不上,部署前先在所有机器上执行
timedatectl set-timezone Asia/Shanghai,并开启NTP同步。 - Agent版本要固定:不要每台服务器装的Agent版本都不一样,会导致采集指标字段不统一,建议用Ansible批量部署固定版本,升级前先在测试机跑一遍。
- 监控端自身要高可用:监控服务器挂了,所有监控跟着失效,可以把采集端做成双机热备,或者定期备份监控配置和数据库,纯粹的本地场景,至少写一个定时脚本,每分钟探测监控进程是否存在,异常就重启。
回到开头的那个问题:本地服务器监控怎么实现实时状态?一句话总结就是选对采集协议,设定合理频率,用分级告警把异常推给正确的人,这样你不需要整天盯着屏幕,服务器自己会“说话”。
本地服务器监控的常见疑问解答
Q1:服务器数量少,有必要上监控系统吗?
有,即使只有一台服务器,手动敲top和df -h也只能看到当前瞬间的状态,而故障往往发生在你离开座位的时候,用一个轻量级的NodeExport辅助脚本,把指标写到文本文件里,再用cron每分钟做一次阈值判断,十几行代码就能实现最基础的实时告警。
Q2:Prometheus和Zabbix在实时性上哪个更强?
Prometheus默认抓取周期15秒,调低到5秒对现代硬件毫无压力,配合Grafana的自动刷新面板,体感上几乎实时,Zabbix的轮询可以达到更低的间隔,但它的Agent端数据处理开销大一些,对于单纯追求毫秒级变更感知的场景,更推荐用Prometheus,因为它的拉取模型对目标服务器的性能影响更小。
Q3:监控本地服务器时,怎么处理敏感服务器的数据安全问题?
监控系统本身是安全死角,建议对所有数据流做加密,SNMP使用v3版本认证,Prometheus开启TSL,Grafana登录开启二次验证,监控端和被监控服务器尽量划在一个隔离VLAN,只开放必要的端口,避免监控成为攻击跳板,告警通知里的服务器名称和IP,脱敏后再发到外部通信工具,这种部署方式在绝大多数内网审计中都能满足要求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/616551.html