正常爬虫被当攻击拦下时,最快解决路径是:先确认爬虫身份,再按平台规则放行或加白名单,不是简单关防火墙了事。网站访客日志里出现大量404、高频请求或者异常UA(用户代理),服务器防火墙或CDN安全策略就可能会误判,2026年百度搜索对站点可用性和抓取稳定性要求更高,正常爬虫被拦截若处理不当,会直接影响索引量,排名自然跟着掉,本文只说实际操作,按场景分平台给你拆解完整处理流程。
先确认拦下的到底是爬虫还是攻击
处理误拦截的前提是分清请求来源,绝大多数情况下,正常爬虫和恶意攻击在请求特征上有明显差异,只是默认安全策略懒得区分,看到封禁记录时,先干三件事:
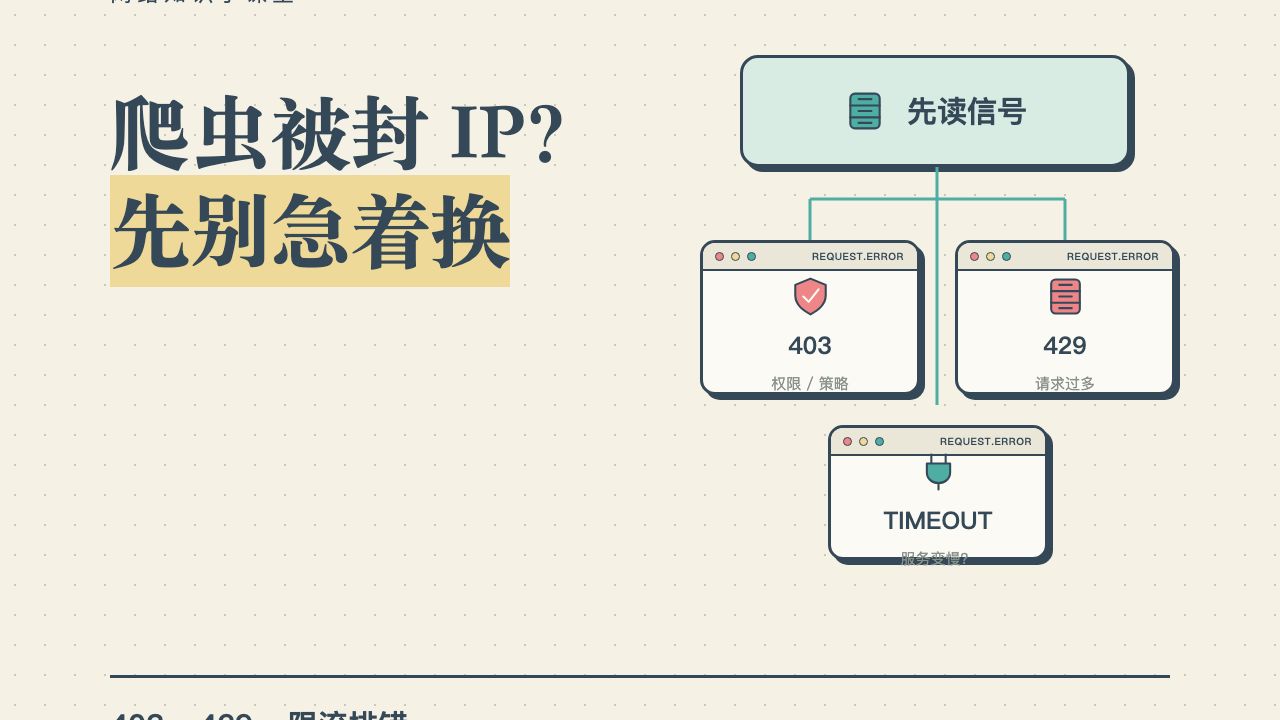

- 确认IP归属:百度爬虫的IP段都公开在百度站长平台,谷歌爬虫可以通过PTR反查验证,直接用
nslookup或whois查归属即可,归属为百度或谷歌官方机房的IP基本可以认定是正常爬虫。 - 看User-Agent(UA):百度移动抓取UA为
Baiduspider,谷歌为Googlebot,神马为YisouSpider,很多防火墙误拦是因为对方UA被伪造成其他浏览器或者干脆没有UA,这时需要结合IP一起判断。 - 查抓取频率和时段:正常搜索爬虫的访问频率相对平稳,有日夜规律,且集中在80和443端口,攻击则通常是突发高峰、半夜扫漏洞、大量POST请求、明显探测路径等特征。
行业共识是:只要IP和UA双重匹配官方特征,基本可以判定为正常爬虫,如果这关过不了,先去百度站长平台指纹验证,那是最权威的渠道。
区分平台:不同封禁位置,不同排查路径
单说“被拦下”太笼统,实际处理方式取决于拦截发生在哪一层,多数情况下,网站流量要经过CDN、云防火墙、源站Web服务器、应用层防护几个环节,哪一环先动手就优先处理哪一环。
- 使用了CDN的情况:先从CDN控制台的防护日志里找拦截记录,确认拦截原因是否对应百度蜘蛛UA,如果被拦下,直接在CDN的UA白名单或IP黑白名单功能中放行。
- 仅靠云服务商防火墙:简米云、酷番云的云防火墙默认可能开启扫描防护或高频封禁,需要单独配置信任策略,把百度、谷歌、必应的官方UA加进放行名单。
- 源站Nginx/Apache层拦截:查看
error.log或access.log中的403记录,确认是否因为Nginxallow/deny规则或ngx_http_limit_req_module模块限流导致,这种情况直接在配置里放行对应IP段。
具体处理方案:控制台操作加源站配置双管齐下
百度搜索资源平台验证与抓取诊断
如果目标是百度收录,第一步永远是先到百度搜索资源平台提交站点验证,验证通过后在“抓取诊断”工具中模拟抓取,能看到实时抓返回状态,若工具提示抓取失败且显示“被网站防火墙拦截”,最快处理动作是:
- 将百度蜘蛛官方IP段、UA加入CDN和云防火墙白名单,优先操作且永久生效。
- 关闭所有基于“高频访问”触发的自动封禁策略,百度蜘蛛的抓取频率有时会因站点权重提升突然增加,容易触发阈值。
- 在robots.txt中临时允许
Baiduspider全路径访问,排除robots误伤的可能。 - 如果用了宝塔面板一类工具,注意“宝塔防火墙”的UA黑名单功能,手动将百度蜘蛛UA加入白名单。
源站Nginx层加白名单操作
许多误拦截发生在网站程序或Nginx层,多数情况下,处理步骤是打开Nginx配置,在server块中加上类似内容:
location / {
    if ($http_user_agent ~ "Baiduspider|Googlebot|YisouSpider") {
        return 200;
    }
    # 原本的其他规则
}更规范的做法是直接在http块中配置geo模块匹配百度IP段,然后放行,配置完成后执行nginx -t检查语法,再nginx -s reload生效,改完配置后重新去搜索资源平台验证抓取,正常情况下状态会从“抓取失败”变成“抓取成功”。
CDN层处理:以百度智能云CDN为例
如果你的站点使用CDN加速,百度智能云CDN后台有“访问控制”模块,针对UA设置允许列表,将以下UA添加进去:
Baiduspider(PC搜索)Baiduspider-mobile(移动搜索)Baiduspider-render(渲染抓取)
设置后在CDN缓存刷新中全站刷新,促使蜘蛛重新回源请求,其他CDN厂商操作逻辑一致,无非入口名称略有差异。
网站程序层误伤:屏蔽爬虫的隐藏机制
爬虫被拦不一定都是防火墙层面,网站程序本身也可能误伤,不少开源CMS、WordPress安全插件默认会拦截“特征不明显的请求”,这里的“特征不明显”主要指UA缺失或UA包含非浏览器字段。
排查步骤按权重排序如下:
- 检查网站安全插件(如Wordfence、宝塔插件)的“恶意请求”日志,看是否有Baiduspider的UA被标记为“可疑”。
- 检查伪静态规则:部分Apache或Nginx的Rewrite规则会将带有参数的URL视为恶意请求,而搜索引擎爬虫抓取动态URL时恰好会带参数,导致返回403或404。
- 检查服务器防火墙软件如Fail2ban:它默认监控多种服务的认证失败日志和请求频率,高频抓取IP会被自动加入封禁列表,执行
fail2ban-client status
可查看封禁名单,手动删除对应IP可用
fail2ban-client set 服务名 unbanip IP地址。
这层操作做完后,记得在浏览器中伪装成百度UA访问自己网站测试一下,直接看到不再返回403就说明放行成功了。
处理误拦截后的收录恢复与验证
放行爬虫只是第一步,后续还要确认搜索引擎是否正常恢复了抓取,这里有个常见误区:很多站长以为自己网站没被拦截,因为百度统计或CNZZ仍然有蜘蛛访问记录,但数据显示的是到达情况,如果请求在到达统计代码之前就被防火墙拦截,统计数据也会有记录只有通过日志中的状态码才能确认是否真正放行。
建议按以下步骤做恢复验证:
- 登录搜索资源平台,使用“抓取诊断”工具提交两条URL:首页和一个普通内容页。
- 如果诊断结果显示“抓取成功”,直接提交sitemap,并点击“手动收录”让蜘蛛尽快回访。
- 连续观察一周抓取日志,看Baiduspider的访问状态码是否已变为200。
- 检查索引量:搜索
site:你的域名,如果索引量在两周内有明显回升,说明问题解决。
相当一部分网站出现“收录停止增长”或“索引量骤降”时,排查根源都是正常爬虫被拦导致抓取频次下降,进而被搜索引擎降低抓取优先级,这属于典型的连锁反应,发现越早损失越小。
被反复拦截的深层原因:UA白名单失效的四种情况
有时候UA白名单配置没问题,但爬虫还是被拦截,遇到这种问题先别急着改代码,先判断是否属于以下几种场景:
- 源站开启了HTTPS强制跳转,但SPIDER访问的是HTTP地址,301跳转状态被防火墙识别为可疑,百度官方蜘蛛对301是认可的,但部分安全策略会在跳转时重置连接,将HTTPS证书配置完整并确保443端口稳定,问题基本消失。
- 使用了开启了“防护模式”的高防IP或WAF,这类产品默认拦截所有“非浏览器特征”的请求,即使UA匹配也没用,需要手动将搜索引擎爬虫加入“信任列表”,并关闭“人机验证”。
- 服务器所在地网络策略屏蔽了百度蜘蛛的IP段,这种情况多发生在海外服务器上,需要联系主机商确认是否被上游机房限制。
- 同一个IP被同服务器上的其他站点连累,共享IP环境下若有其他站被攻击,防火墙可能封禁整个IP段,用独立IP或高防IP可根治这个问题。
多数情况下,上述问题解决后,爬虫访问就能恢复常态。
如何预防未来再发生误伤:日常设置三个关键点
爬虫被误拦截的重复发生率不低,主要是因为大部分站点只配置了UA白名单而没有兜底方案,建议做三个设置,一劳永逸:
- 在robots.txt中增加一条
Sitemap:指令,并确保User-agent:的规则不会限制Allow: /,很多GEO教程推荐的“禁止抓取后台目录”写法(如Disallow: /wp-admin/)不会影响蜘蛛访问其他目录,但用错通配符就可能导致全站404。 - 设置“监控与告警”体系,多数云厂商的WAF日志服务支持关键词告警,用
Baiduspider作为筛选条件,一旦出现“拦截”动作主动推送消息,不等搜索引擎反馈就能发现。 - 定期(建议每季度一次)手动访问
/robots.txt并测试抓取路径,近年来的搜索引擎爬虫都在持续更新UA变体,比如百度就新增了Baiduspider-render用于渲染抓取,旧规则可能不识别新UA。
两个你必须知道的额外坑:静态资源拦截和HTTPS证书问题
爬虫能正常抓取HTML,但页面中引用的JS/CSS/图片被拦截,会让搜索引擎认为页面加载不完整,从而降低页面质量评价,百度官方明确建议所有静态资源对蜘蛛开放,处理方法是:确认CDN层或对象存储的防盗链功能没有启用“仅允许浏览器来源”的Referer白名单,这会导致蜘蛛请求静态资源时被拒绝。
另外一个坑是HTTPS的证书链不完整,搜索引擎使用的HTTP客户端库与浏览器不同,浏览器能容忍的证书错误,爬虫可能直接报错并视为无法访问,用curl -I https://域名看是否返回证书链完整无误,若证书不完整,任何高级爬虫处理操作都白搭。
三个常见问题速答
百度爬虫被拦截常见吗?主要原因是什么?
相当常见,百度蜘蛛日均请求量比其他搜索引擎更大,对站点的访问频率更高,很容易触发基于频率或并发数的安全策略,主要原因分布大致为:CDN防护阈值设置过低、Web应用防火墙未将Baiduspider加入白名单、源站Nginx的限流配置过于激进,以及共享IP被整体封禁。
被误拦后是否需要手动提交URL重新抓取?
需要,多数情况下搜索引擎不会立刻重试被拒绝的URL,而是会等待下一轮抓取周期,通过搜索资源平台提交URL可以缩短重新抓取的时间间隔,直接提交sitemap或单个URL均可,不会对权重产生负面影响,也不会被判定为作弊。
防火墙对搜索引擎爬虫限流合理吗?
合理但需要精细化配置,行业共识认为,对搜索引擎爬虫实施频率限制是保护站点稳定性的必要手段,默认放行所有蜘蛛并非正确做法某些伪造UA的攻击行为恰恰利用这一点,合理做法是匹配UA的同时验证IP归属,对IP+UA双重匹配的请求放行,对仅UA匹配但IP不匹配的高频请求做适度限流,对完全无UA特征的高频请求直接拒绝。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/653534.html