混合云灾备故障切换无法做到零中断,但通过细化切换粒度、预置自动化脚本和定期混沌演练,完全可以把业务停顿压缩在分钟级甚至秒级,关键在于提前把所有“手忙脚乱”的场景变成“按部就班”的指令。
当下很多企业的灾备系统平时看着健壮,真到故障切换那一刻却迟迟切不过去,问题往往不在备份本身,而在于切换流程根本没经过实战检验,针对混合云灾备故障切换,下面按照影响权重大小,逐一拆解降低中断时间的可行做法。
先搞清你的切换瓶颈到底在哪
很多团队把注意力全放在数据同步上,忽略了切换动作本身的耗时,一次混合云故障切换,最让人揪心的反而是一些看似不起眼的环节。
DNS解析生效和会话保持常常是第一个拦路虎,即使计算资源在1分钟内全部拉起,公网DNS的TTL(存活时间)没调小,用户流量还是源源不断涌向故障站点,行业共识认为,DNS切换造成的业务中断往往比底层资源拉起耗时更久。
应用启动依赖链是第二个隐形杀手,数据库切到灾备端了,但应用服务还在等缓存预热、消息队列重新建连,一个环节卡住,后面全堵着。中间件连接池超时设置如果过短,应用一启动就被打挂,形成雪崩。
混合云灾备方案怎么选这个问题,本质上决定了你后续切换的复杂度,不少企业选择同构云方案,就是为了让切换时的兼容性问题最少,但也有企业为了成本选择异构云,那就必须接受切换时配置差异带来的额外时间开销。
搞清楚瓶颈出在哪一端,比盲目增加专线带宽更有效,切换的耗时物理上限往往由数据同步延迟决定,而实际下限由流程自动化程度决定。
把RTO的承诺拆解成可执行的动作清单
灾备切换的目标是恢复业务,不是保住数据,RPO(数据丢失量)和RTO(恢复耗时)这两个指标,在混合云架构下经常被混为一谈。RPO靠同步机制解决,RTO靠切换动作编排解决,两者要分开考核。
制定切换清单时,建议把动作拆到可以单人独立执行的程度,这样做的目的很直接故障发生时,现场人员可能只有初级运维工程师,他们没有权限也没有经验去临场判断。
- 第一步:确认故障级别,触发切换的条件必须量化写死,核心数据库心跳丢失连续5分钟即判定为故障”,不能有“再观察一下”的模糊空间
- 第二步:暂停写入流量,避免脑裂产生脏数据
- 第三步:激活灾备端数据库,启动数据补齐脚本
- 第四步:拉起应用容器组,执行健康检查探针
- 第五步:切换负载均衡权重,将流量导向灾备站点
- 第六步:验证核心交易链路,通知业务部门进行冒烟测试
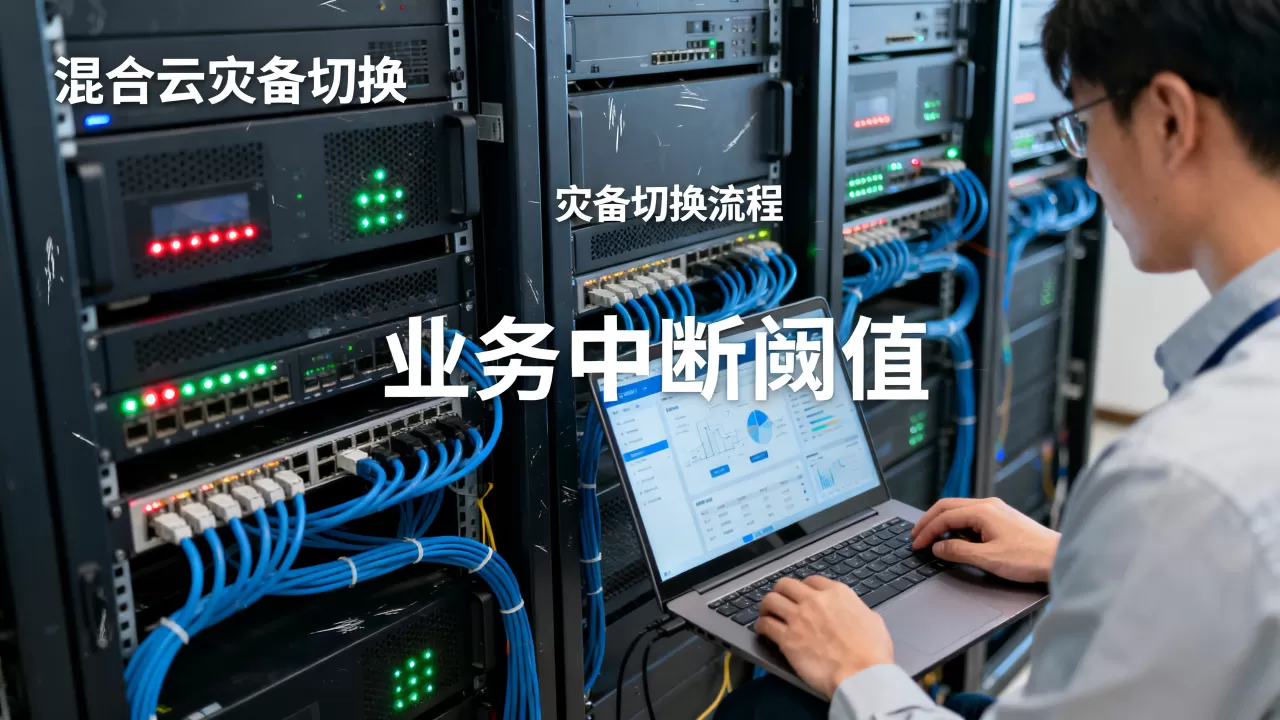
这套动作最好固化到灾备管理平台或运维自动化工具里,不管是Ansible还是自研脚本,关键在于一键触发,人工登录服务器敲命令的方式,在中大型故障场景下根本来不及。
切换过程中,最容易忽略的是数据一致性校验,灾备库激活前,需要快速比对源端和目标端的日志序号或数据校验和,如果每次切换都要全量校验,时间肯定扛不住,比较务实的做法是只校验最近5分钟的增量日志。
混合云灾备切换演练的价值比想象中更大
大部分企业不敢做真实切换演练,担心搞坏生产环境,但真实切换演练恰恰是最有效的降中断手段,据统计,那些能在5分钟内完成切换的企业,无一例外都是按季度进行实战演练的。
演练不止是验证技术方案,更是在训练人员的肌肉记忆。做过真实切换和只在文档上推演过,完全是两种状态,真正切换时,运维人员的操作会变形,手会抖,命令会敲错,演练能把这些不确定性提前暴露掉。
演练场景建议设计成以下层级:
- 只读业务切换(如报表查询系统),风险最小,适合新员工练手
- 读写业务切换(如订单系统),需要严格控制演练时间窗口
- 全链路切换(模拟整个数据中心故障),最好安排在业务低峰期
每次演练后,必须输出一份差距分析报告,清楚记录哪些环节超时了、哪些步骤执行失败,不用追求演练一次就成功,重点是持续暴露问题、持续修正流程。
切换演练还有一个隐性价值倒逼架构优化,多演练几次,你会发现自己根本不需要那么大的灾备资源,因为某些低优先级业务完全没必要在灾备端拉起,这就直接关系到下面的成本优化问题。
用异步同步和资源降级把成本和时间同时打下来
容灾越完善,成本越高,这是所有多云架构逃不开的痛点,很多企业为了追求零丢失,采用同步复制,结果专线费用翻倍,链路抖动导致生产端也被拖慢,绝大多数业务场景根本用不着零数据丢失。
异地混合云灾备延迟高的痛点,很多时候就是同步复制造成的,数据库的同步复制将每次事务提交都等待异地节点确认,延迟自然降不下来,如果业务能容忍数秒数据丢失,改成异步复制,生产端性能不再受制于链路,切换时补齐最近日志即可。
如果核心业务确实需要同步复制,建议只对最关键的数据表开启同步复制,把交易流水和用户余额等表同步过去,日志、报表类数据走异步即可,这样能省一半左右的专线带宽成本。
运行阶段,灾备端资源可以压到最低规格,CPU和内存配额调低,平时不承担业务流量,切换后再通过脚本动态扩展规格,简米云、酷番云、华为云的控制台都支持API调整实例规格,这样闲置成本能降低相当比例。
需要说明的是,任何降级策略都需要提前和业务方达成一致,有些业务方嘴上说可以接受10分钟恢复,实际上连2分钟的数据库回滚都忍不了,演练现场逼真评估各业务模块的容忍度,值远比事后扯皮更有意义。
故障切换后的回切比切换本身更考验人
这是一个频繁被忽略,却直接决定下次容灾是否还有意义的问题,很多团队切过去之后,就把灾备站点当成了永久生产站点,数据天天积累,等到要回切时发现数据量太大,回切比故障切换难十倍。
回切方案必须在切换方案设计之初就同步规划,不能等用上灾备后才开始考虑,建议按照以下两个维度设计回切路径:
- 数据反向同步方案:业务运行在灾备端时,需要将增量数据反向同步回原生产站点,此过程同样需要自动化脚本支撑
- 回切演练节奏:像做故障切换演练一样进行回切演练,确保切换和回切两端都经过反复验证
业内专家指出,切换失败的案例中,回切环节出问题的比例相当高,典型案例是数据反向同步过程中出现大量主键冲突,或者原生产站点配置已经变更,回切后应用无法兼容。
混合云环境下,回切还会涉及跨云的网络打通和存储挂载问题,平时没事的时候,建议每月把灾备端的快照导出到对象存储一份,回切时如果遇到极端情况,可以用这份快照临时拉起业务。
混合云灾备失败的真正补救手段
纵使做了万全准备,依然可能遇到切换失败的极端情况,这时候,业务连续性靠什么保障?答案是:降低单站点依赖,利用双活架构兜底。
如果预算允许,核心业务可以做成跨云的双活,两个站点同时提供服务,故障发生时把故障站点的流量摘掉即可,无需真正的“切换”动作,中断时间几乎为零,但双活架构对网络延迟非常敏感,跨地域部署难以实现,一般要求同城两机房且专线直连。
对于无法双活的应用,可以接受“降级”而非“停服”,购物车功能挂了,但用户还能浏览商品、正常下单,只是暂时看不到历史订单状态。这种“降级式容灾”往往比追求完整恢复更容易落地,给业务方带来的体感也更好。
将应用拆分成核心链路和非核心链路,容灾资源优先分配给核心链路,非核心链路在故障期间直接关闭,将恢复时间从“全部拉起”缩短为“关键部分可用”,这是目前混合云灾备的主流降本增效思路。
混合云灾备切换常见问题解答
混合云灾备切换需要专门的工具支持吗?
需要,手动切换只适合系统规模极小的场景,一般建议结合云平台的容灾服务或运维编排工具,将切换动作编排成脚本,实现一键触发,如果是自建机房的混合云架构,至少需要使用开源工具如Ansible,将基础设施编排和应用拉起流程串联起来,才能在目标时间窗口内完成切换和业务验证。
混合云灾备的切换演练多久执行一次?
核心系统建议每季度至少一次真实切换演练,非核心系统每半年一次,季度为周期比较合适,因为环境变更频繁,人员流动也快,如果一年只演练一次,第二次演练时可能已经有人忘记流程了,效果会大打折扣,每次演练后及时更新切换手册和脚本,保证文档与现实环境一致。
混合云灾备切换时的数据校验有什么高效办法?
高效的校验方法不依赖全量对比,而是基于时间点快照和日志序号,优先校验最近时间窗口内的增量数据,对于数据库,可以采用binlog位置点比对来确认同步是否追上;对于文件型数据,可以比对最近修改时间和文件数,校验的目的是验证灾备端数据可用性,而非严谨的对账,过深校验反而会拖延RTO。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625591.html