长上下文推理的显存挑战,核心在于KV Cache随序列长度线性增长,序列越长,显存占用越恐怖,单纯堆算力或买卡并不解决根本问题。 真正值得关注的,不是模型权重占了多少显存,而是每一轮生成时都要存下“已经看过的所有内容”,上下文从2K涨到128K,模型参数量一个字节没变,显存账单却可能翻几十倍,下面把这个问题拆开讲清楚。
长上下文推理 显存不够怎么办
把显存想象成一个行李箱,模型权重是固定的一层衣物,不管任务多复杂,这一层衣物尺寸不变,长上下文推理时,行李箱里开始塞进一本不断加页的笔记,每生成一个token,就要把之前所有token的Key和Value再抄一遍,序列越长,这本笔记越厚,行李箱很快就合不上了。
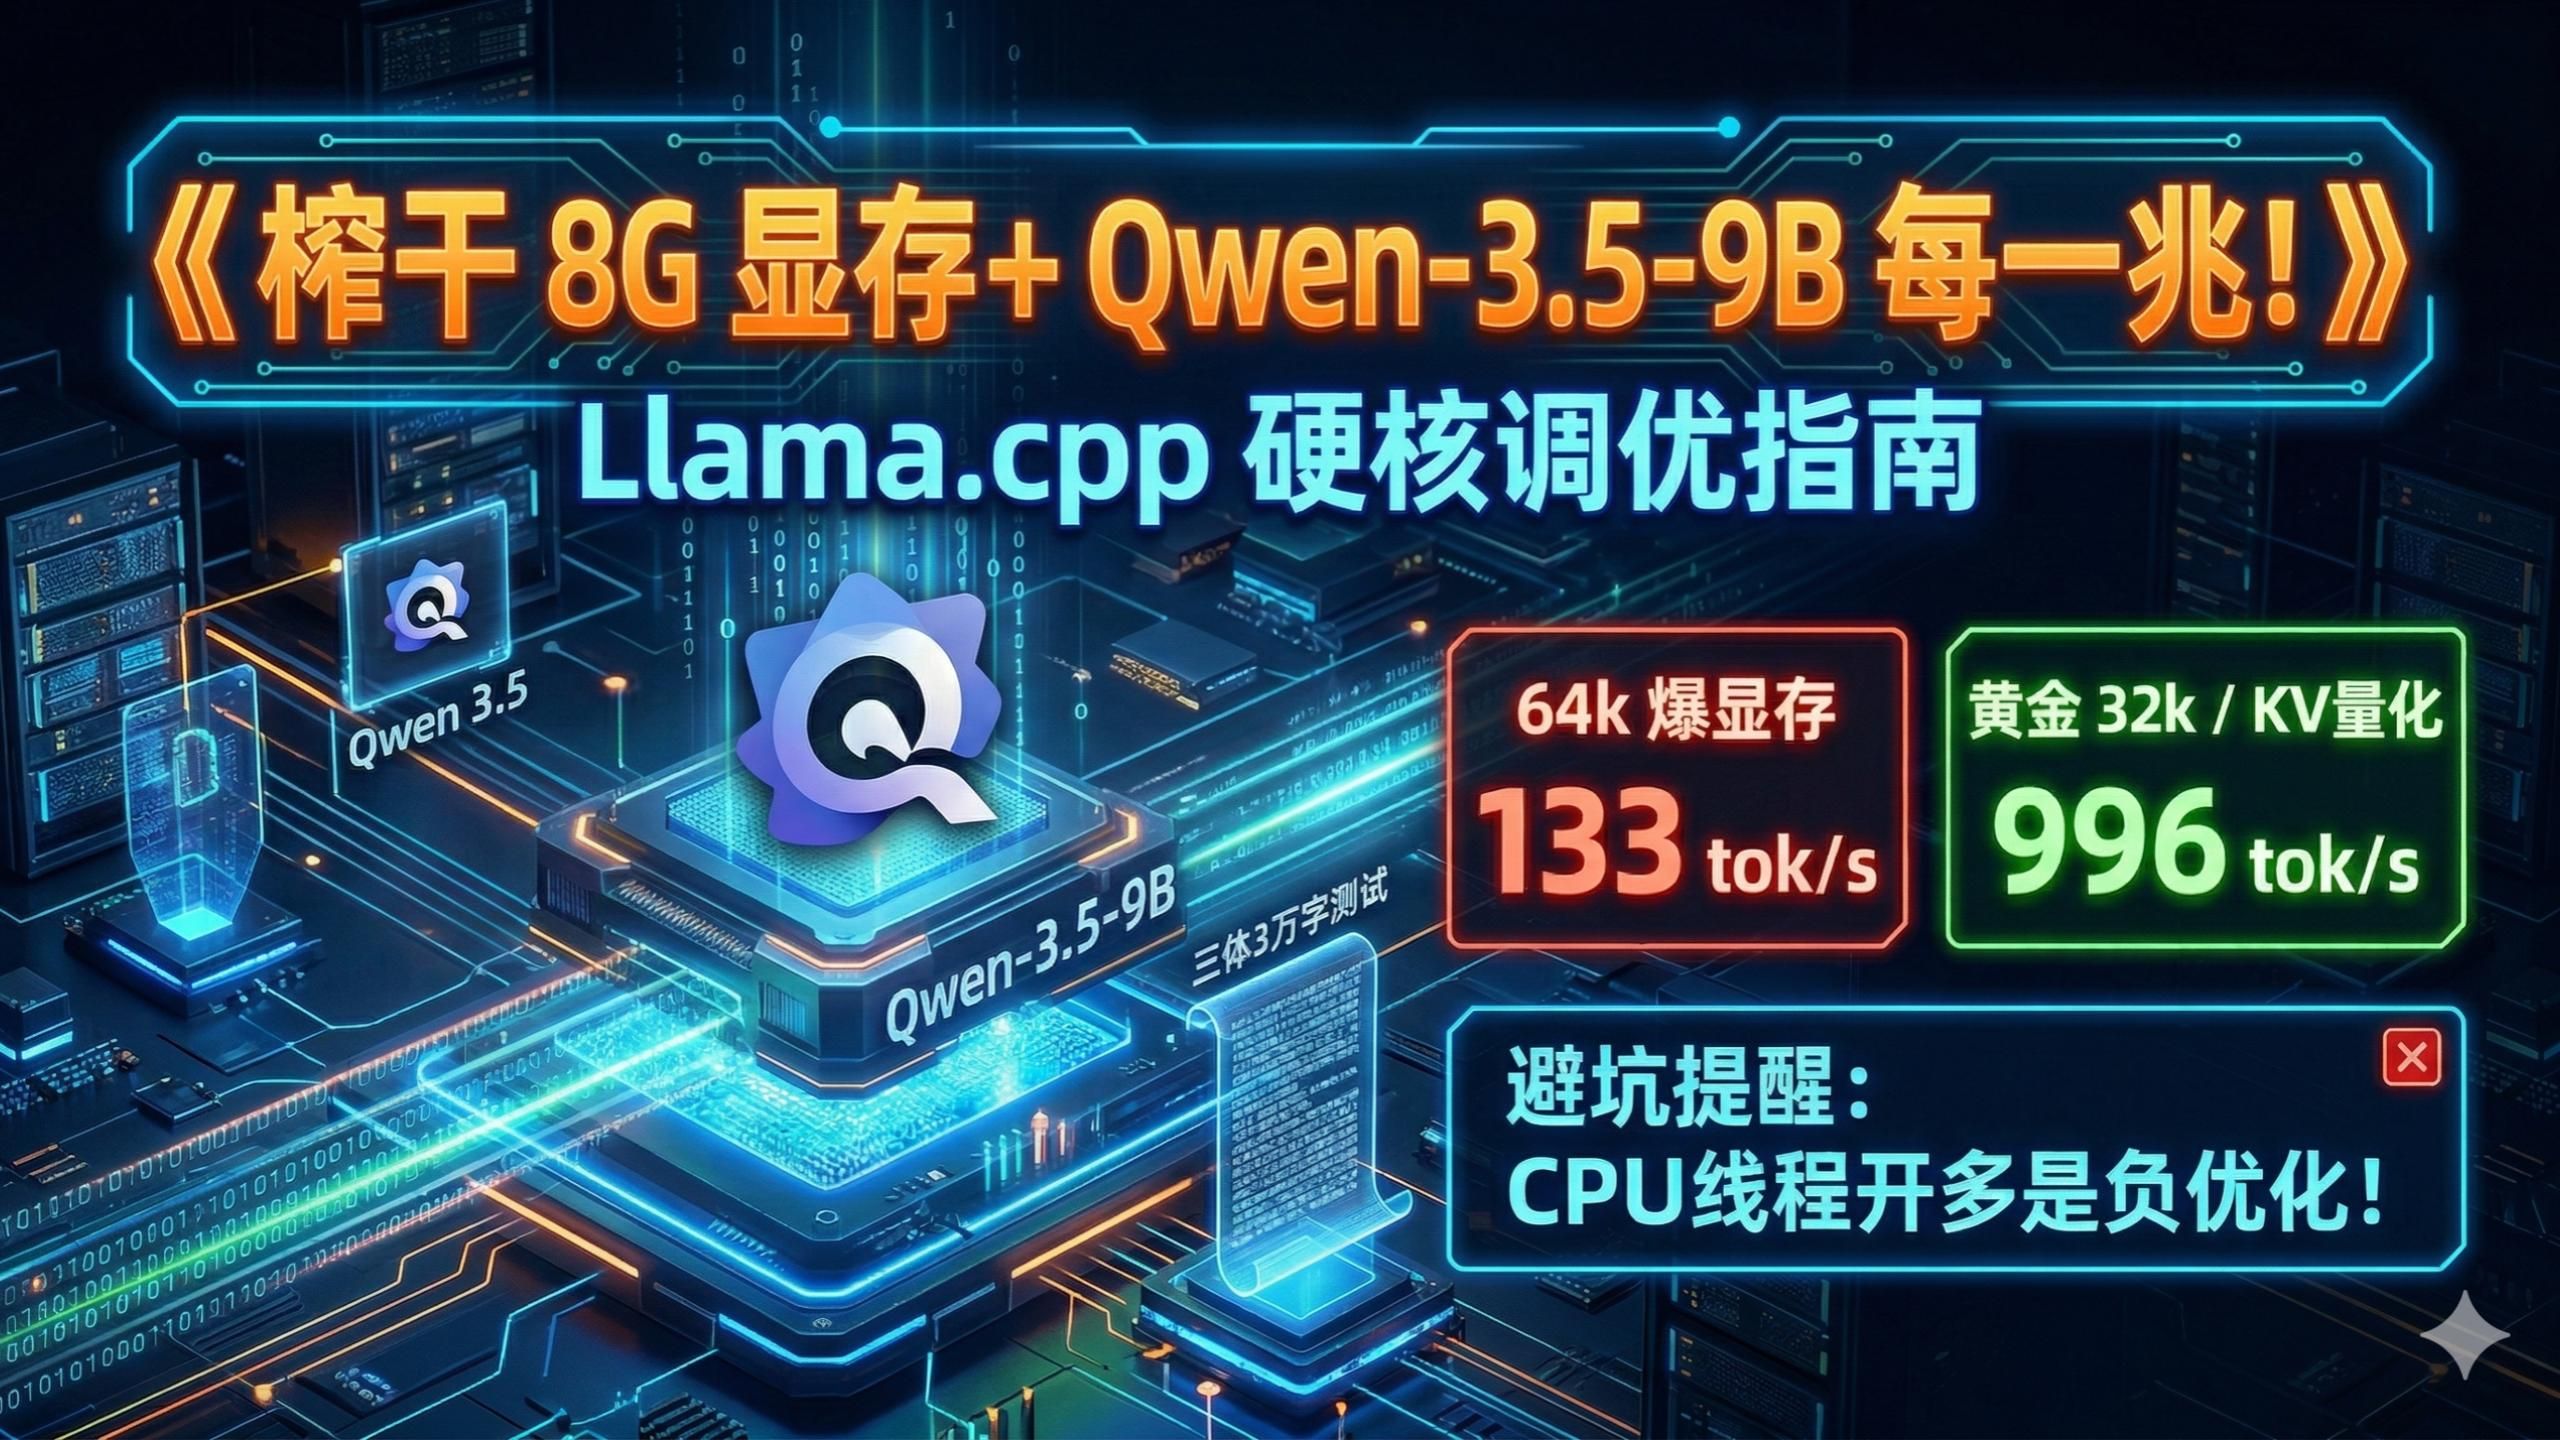

为什么长上下文会让显存“爆仓”
推理分两步走,第一步是预填充(prefill),模型把整个输入序列读一遍,生成第一层KV Cache;第二步是逐一生成token,每生成一个新token,都要更新KV Cache,KV Cache的大小几乎与序列长度成正比,这是长上下文推理显存压力的根源。
- 序列长度翻倍,KV Cache大约也要翻倍。
- 模型权重只在加载时占一份显存,KV Cache却随着生成不断增长。
- 批量推理时,KV Cache还要乘以batch size,几路请求同时跑,显存瞬间见底。
业内专家指出,多数实际业务场景中,序列长度超过8K后,KV Cache占用的显存就已经接近甚至超过模型权重本身,上下文越长,这个比例越失衡。
显存不够的三个信号
很多开发者遇到问题时以为是自己显卡太旧,其实换卡之前,可以先看看是不是触发了以下典型征兆。
- 生成到一半直接报
CUDA out of memory,程序崩溃。 - 首Token延迟不高,但越往后越慢,因为显存不够时框架开始把数据往内存搬运。
- 想提高并发,批量大小从8降到4再降到1,最后只能单条跑。
如果你在长上下文推理时遇到上述情况,第一步不是买新卡,而是先确认KV Cache是否被重复缓存,同一段历史上下文在多轮对话中被反复编码,是显存浪费的重灾区。
从框架层面抢救显存:最快见效的三招
vLLM是目前普及度较高的推理框架,它内置的PagedAttention技术能极大缓解KV Cache的碎片化浪费,操作路径如下:
- 安装vLLM后,启动服务时加上
--max-model-len 32768,允许更长的上下文。 - 开启
--kv-cache-dtype fp8,将KV Cache从FP16压缩到FP8,显存占用直接减半。 - 设置
--cpu-offload-gb,把部分闲置的KV Cache临时放到CPU内存中,GPU只保留当前计算最需要的部分。
这三步做完,显存占用通常会有明显下降,如果仍然不够,就轮到算法侧出马。
大模型长上下文 推理显存占用对比
不少人在选型时会问“大模型长上下文 推理显存占用对比”同样一个模型,上下文从8K拉到32K,到底多占多少显存?这个问题没有固定答案,因为不同的注意力机制和量化方案差别巨大,但行业共识认为,主流稠密模型在不做任何优化时,KV Cache随序列长度线性增长,这是一个躲不掉的规律。
不同参数量模型的长上下文显存压力
用定性的方式看,一张表就能说明问题,以下对比基于单序列推理、半精度模型权重,忽略激活值和优化器状态。
| 模型参数规模 | 2K上下文 | 8K上下文 | 32K上下文 | 128K上下文 |
|---|---|---|---|---|
| 7B | 显存有余量 | 压力尚可 | 接近单卡上限 | 远超单卡上限 |
| 13B | 相对宽松 | 开始吃紧 | 必须分批或多卡 | 多卡也吃力 |
| 70B | 权重就占大头 | 权重+KV超载 | 需要专门优化 | 计算集群级别 |
以大多数GPU单卡80G显存为例,7B模型在32K上下文场景下,KV Cache本身就能吃掉大半张卡,如果同时跑几路请求,OOM几乎是必然的。
长上下文推理需要多少显存:先算这笔账
与其听别人报数字,不如自己动手估算,KV Cache的计算公式并不复杂:
- 显存占用 = 层数 × 注意力头数 × 每个头的维度 × 序列长度 × 2(Key和Value各一份) × 每个元素字节数。
把模型参数带进去,就能算出自己场景下的理论下限,实际操作中,还需要加上激活值、临时缓冲区和显存碎片,最终占用数值通常会比理论值再高一些。
这正是“长上下文推理需要多少显存”这个问题的答案并不统一的原因,同样的序列长度,使用FlashAttention、GQA或KV量化后,占用量可能是数倍的差距。
长上下文推理 价格对比:自己部署还是用API
谈到价格,很多人会把“大模型长上下文 推理价格”挂在嘴边,但价格只是表象,自己部署一张A800,硬件成本不低,还要考虑机房、电费、运维,如果只是偶尔跑几十次长文本分析,按tokens付费的API明显更划算,但如果每天处理海量长文本,API费用会随序列长度水涨船高,这时候自己部署并做显存优化,综合成本反而可控。
选择的标准很简单:低频低并发,用API;高频高并发,自建。 重要的是先把显存优化手段用上,否则不管是API还是自建,费用都会被无谓的KV Cache放大。
长上下文推理 显存优化的实操路径
前面提到了框架层面的临时对策,这一节讲讲更系统的优化思路,显存不够怎么办,本质上是让模型“少记一点”,记得更省”。
从输入侧压缩上下文
输入侧压缩最简单,也最有效,长上下文推理不是所有内容都有用,很多场景里真正需要的信息只占一小段。
- 用检索增强,从长文档里抽出与问题最相关的几个段落,只把这些段落喂给模型。
- 对历史对话做摘要,把五轮天马行空的闲聊压成两句话,再作为上下文输入。
- 设置上下文窗口上限,超出部分按照时间或重要性截断。
几种方法可以组合使用,输入长度下降,KV Cache直接减少,显存压力随之缓解。
从算法侧降低KV Cache的“厚度”
- GQA(分组查询注意力) 是Llama 2和Mistral等模型采用的设计,多个查询头共享同一组Key和Value头,KV Cache直接缩小8倍左右。
- KV Cache量化 把存储精度从FP16降到INT8,进一步减半,当前的主流推理框架中,这个选项通常只需一个启动参数。
- 窗口注意力

只保留最近若干token的KV Cache,较早的信息被丢弃,适合对远距离依赖不敏感的任务。
如果模型本身不支持GQA,也可以通过微调或使用支持稀疏注意力的推理引擎来近似实现。
从推理框架侧调度显存
框架层面的优化空间,往往比想象中大,vLLM的PagedAttention把KV Cache切分成固定大小的块,按需分配,显存碎片大幅减少,除此之外,还有其他值得尝试的手段。
- 打开连续批处理,让多个请求交错生成,提高GPU利用率,避免某一瞬间KV Cache同时爆炸。
- 使用CPU offload,当GPU显存接近阈值时,把暂时不用的KV Cache挪到内存,等需要时再搬运回来。
- 在多卡环境下,用
tensor parallel把KV Cache分布到多张卡上,让每张卡的负担更均衡。
这些手段没有银弹,通常需要组合使用,拿一个13B模型跑128K上下文,你可以同时启用GQA、KV量化和PagedAttention,再看实际问题能否解决。
长上下文推理显存占用常见问题解答
长上下文推理显存不够怎么办?最简单的方法是什么?
最简单的办法是限制输入长度,然后启用vLLM的KV Cache量化,在启动命令中加入--kv-cache-dtype fp8,如果是7B模型,单卡就能较好地处理32K上下文,如果还需要更长的序列,再加一层检索,只把最相关的片段送入模型输入。
大模型长上下文推理需要多少显存?8K和32K差距大吗?
差距很大,相同的模型和精度下,KV Cache的大小随序列长度线性增加,32K的KV Cache理论上是8K的4倍,不过实际差距还受注意力类型影响,使用GQA的模型差距会更小,而使用传统多头注意力的模型差距更明显。
云厂商的长上下文API和自己部署显卡,哪个更划算?
看调用频率和并发规模,低频偶尔用,API按token计价,没有闲置成本;高频大批量调用,API费用随序列长度和调用量线性上涨,自建服务器一次投入硬件成本,边际成本递减,当前云厂商普遍提供长上下文API,并发支持弹性伸缩,但对持续运行的推理业务,自建多卡集群并做KV Cache优化,单位成本更可控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625595.html