混合精度训练要稳住数值,核心就三件事:损失缩放、梯度裁剪、特殊层保持高精度,做对这三步,大部分nan和inf问题都能避开。
为什么混合精度训练容易出现nan和inf?数值范围与精度丢失的根源
混合精度训练不是单纯把模型从fp32换成fp16,而是让fp16负责计算、fp32负责累加,理解这一点,才能明白报错从哪来。
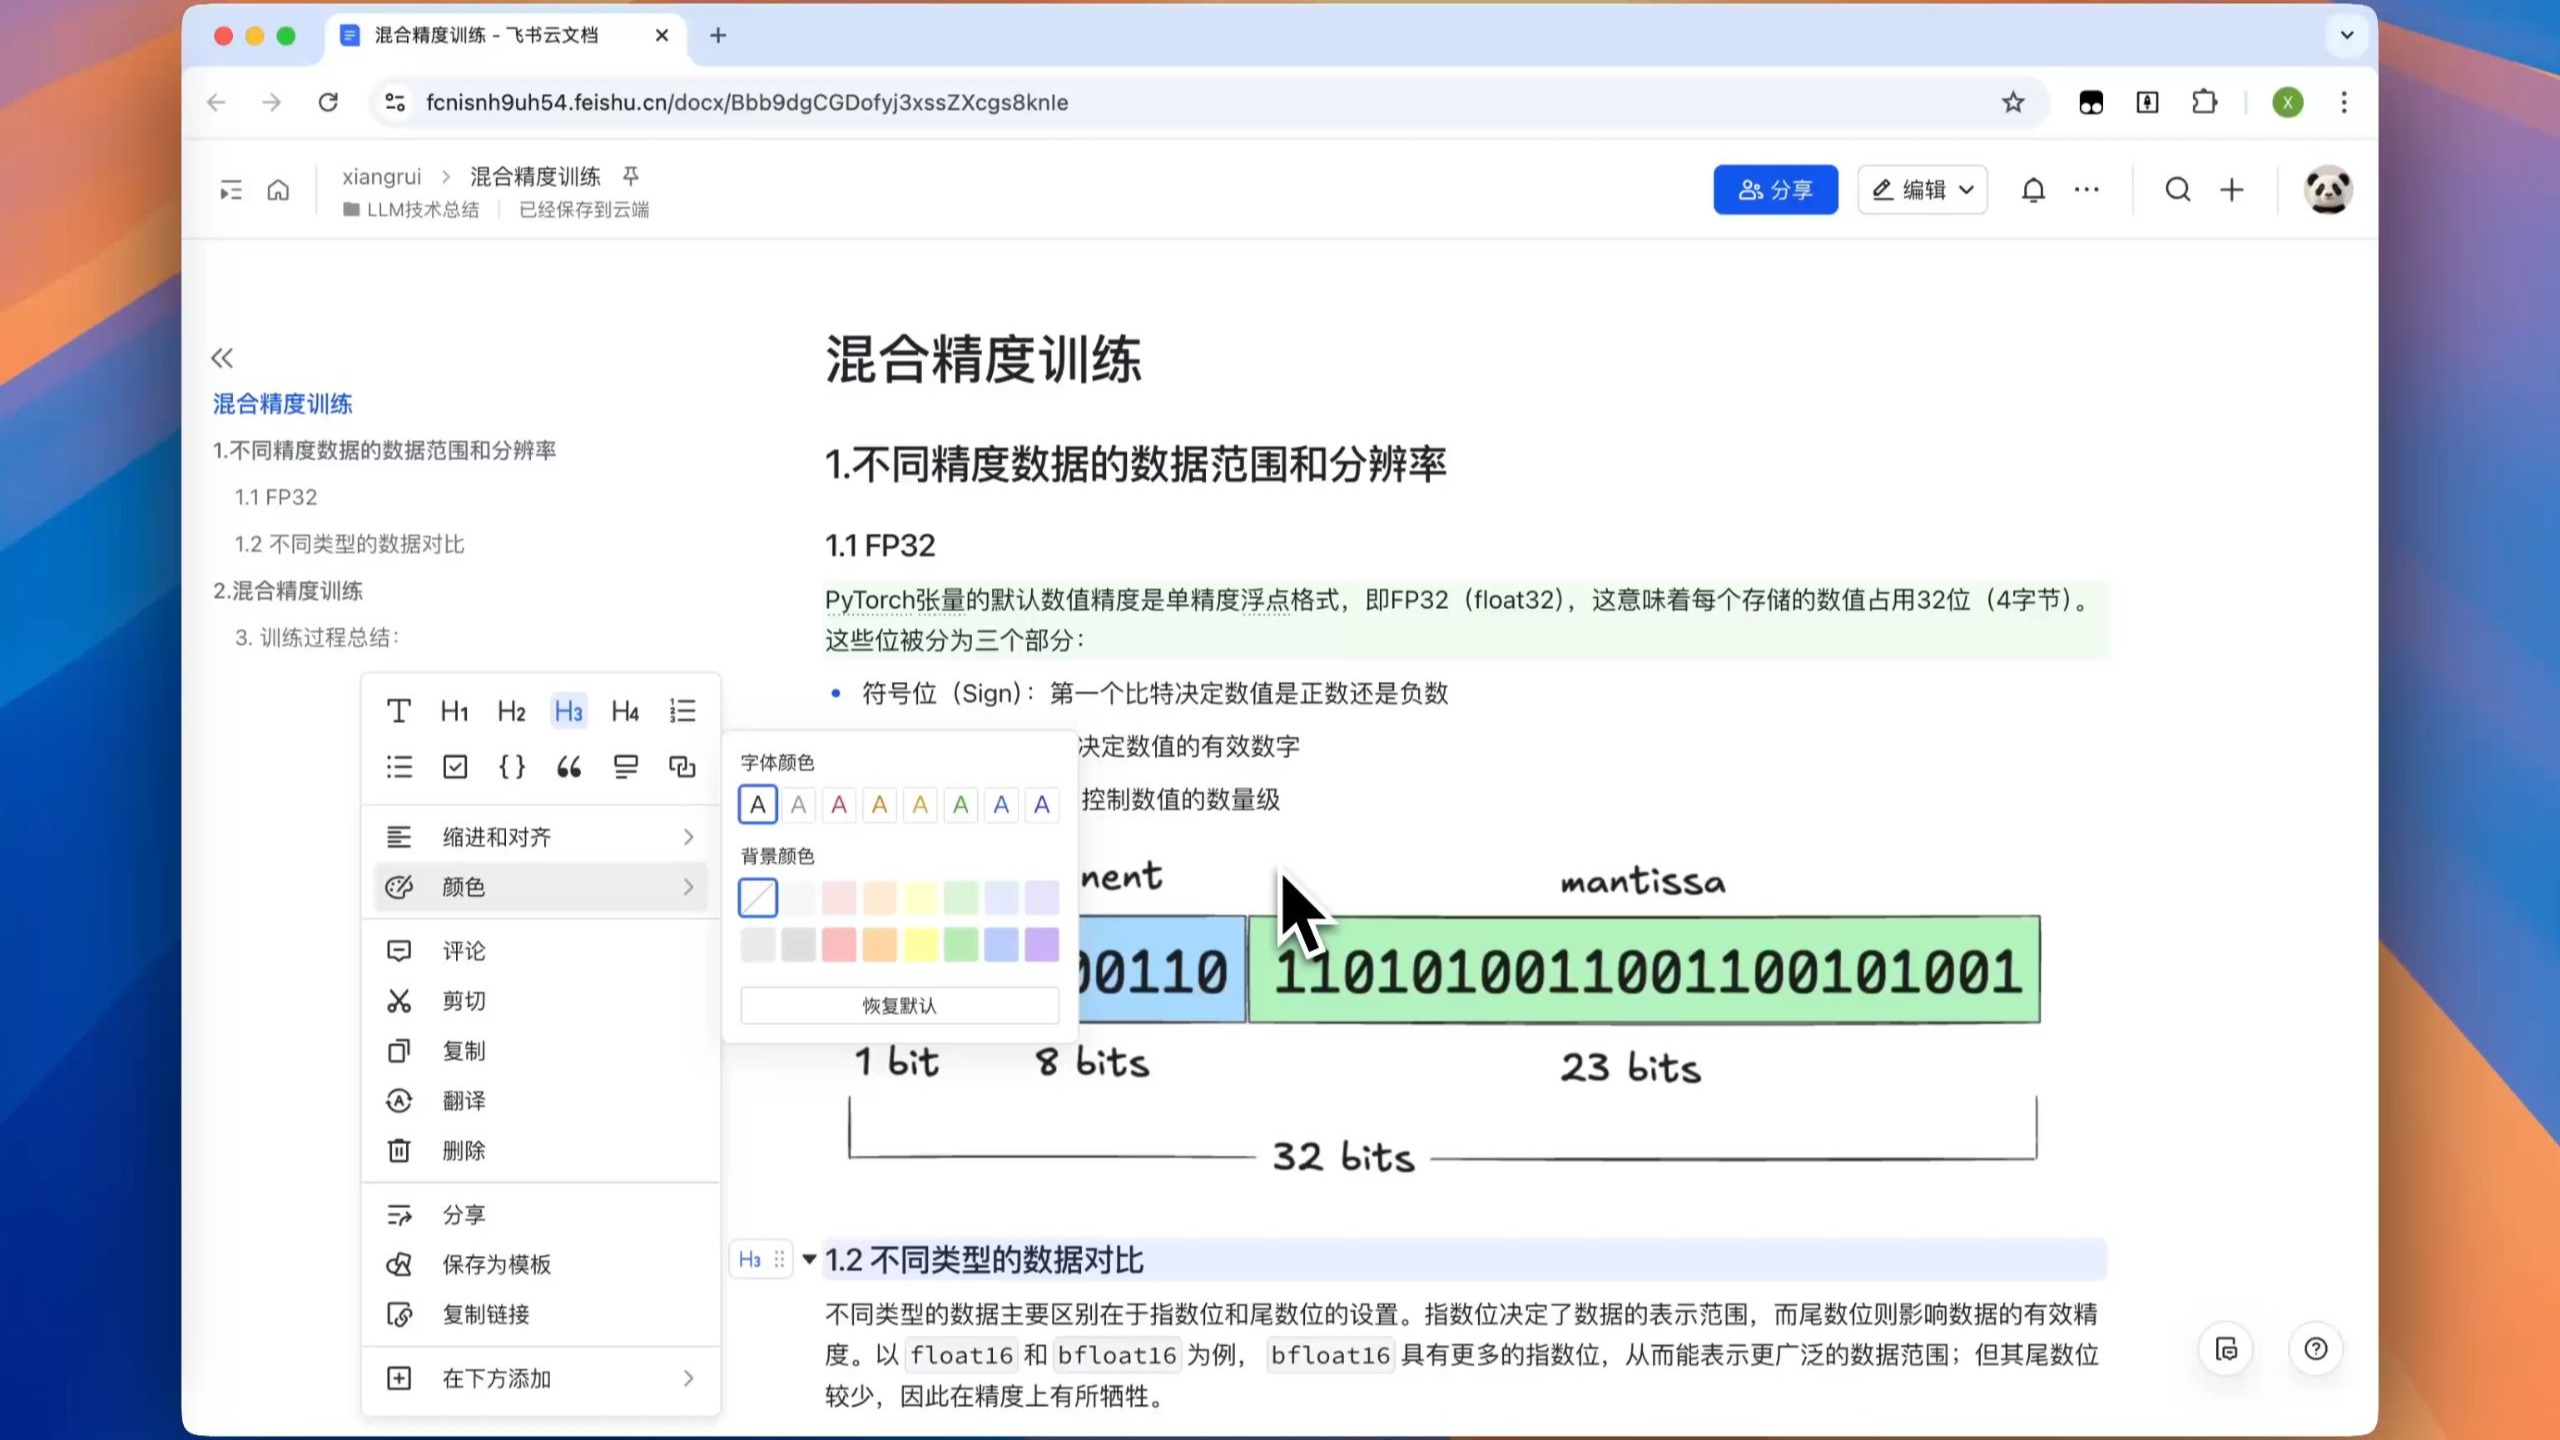

fp16的“动态范围”到底有多窄?
fp16的指数位只有5位,最大值是65504,最小正常数约6e-8,fp32的指数位有8位,最大约4e38,最小约1e-38,两者差距有多大?你可以想象fp32是一个能装下整栋楼货架的仓库,而fp16只给你一个鞋盒。
这意味着两件事:
- 激活值超过65504,直接变成inf,后续所有计算全部失控。
- 梯度值小于6e-8,直接变成0,参数再也不更新。
行业内把这叫上溢和下溢,上溢好排查,下溢更隐蔽模型不报错,但loss降不下去,你以为是学习率问题,其实是梯度已经悄悄“蒸发”了。
梯度消失不是玄学,是下溢
神经网络反向传播时,梯度是逐层连乘的结果,到了靠近输入的前几层,梯度数值往往非常小,在fp32下这些小数值还能被表示,但换成fp16后,它们很可能小于6e-8,直接归零。
所以很多人在混合精度训练初期遇到的现象是:前面的层权重几乎不动,后面的层正常更新,这不是优化器的问题,是fp16把梯度“吃掉”了。
混合精度训练损失缩放(Loss Scaling)怎么调才稳定?
损失缩放是解决下溢的核心手段,思路很简单:反向传播前,把loss乘一个放大因子,比如1024,这样梯度整体被放大,fp16能表示的范围就够用了,更新参数前再除以这个因子,恢复原始尺度。
动态损失缩放和静态损失缩放选哪个?
行业共识认为,动态损失缩放是大多数场景下的稳妥选择,它的逻辑是:
- 检查当前迭代的梯度是否有inf或nan。
- 如果没有,把缩放因子加倍(通常上限到2的24次方)。
- 如果有,跳过这次更新,把缩放因子减半。
静态缩放则固定一个值,比如512或1024,适合你已经对模型规模和数据分布有把握的情况。
实操建议:
- 用PyTorch的
torch.cuda.amp.GradScaler,默认就是动态缩放,基本开箱即用。 - 用TensorFlow的
tf.keras.mixed_precision.LossScaleOptimizer,默认也是动态模式。 - 如果你的batch size特别大,或用的是大学习率,可以手动把初始缩放因子设高一点,比如1048576。
损失缩放阈值step数怎么调?
动态缩放里有个参数叫scale_window,表示连续多少次迭代没有溢出,就把缩放因子翻倍,默认值通常是
2000步。
怎么判断这个值要不要改?
- 训练初期loss下降正常,但隔一段时间突然跳成nan,然后恢复说明缩放因子增长太快,
scale_window调大一些,比如5000。 - 训练一直很稳,但loss曲线有微小毛刺说明缩放因子不够大,
scale_window调小,让因子更快上升。
行业里常见做法是:先用默认参数跑1000步,观察log中是否有“skipping update”相关警告,如果有频繁警告,说明缩放因子经常溢出,需要降低初始缩放值或增大scale_window。
实操:从爆nan到稳定的调整路径
假设你在跑一个BERT-base分类模型,开启混合精度后第10步就nan,按这个顺序排查:
- 检查学习率,混合精度下学习率可以比fp32略大,但如果原本就偏大,nan会更早爆发。
- 确认损失函数输出是fp32。
loss.item()返回的永远是Python float,但loss本身需要是fp32参与反向传播。 - 查看梯度中是否有inf,在第一次
scaler.step(optimizer)之前打印scaler.scale(),确认缩放因子没有被重置为1。 - 如果上面都正常,把缩放因子初始值调小,比如从65536改成1024。
- 仍然nan?检查数据里是否有异常值,fp16对输入数据中的极大值很敏感,比如特征中含有超过1000的原始值,需要先做标准化。
哪些层必须保持fp32?混合精度训练的精度分配策略
混合精度不是所有层都用fp16,有几种层对数值精度极其敏感,一旦降精度就可能导致训练崩坏或精度损失。
BatchNorm和LayerNorm的数值敏感性
BatchNorm在训练时需要统计批内的均值和方差,这些统计量的计算在fp16下会累计误差,导致均值漂移,行业共识是BatchNorm层保持fp32。
PyTorch的AMP会自动让BatchNorm运行在fp32,TensorFlow的混合精度策略默认也是,如果你用的是自定义模型,记得手动检查:
- 使用
torch.nn.BatchNorm1d/2d/3d时,确保模型被torch.cuda.amp.autocast()包裹,权重不会强制转fp16。 - 如果你手动调用
.half()转换模型,一定要在之后把BatchNorm的参数重新转回fp32。
LayerNorm的情况复杂一些,Transformer里的LayerNorm通常保持在fp32更稳,但在某些框架中,fp16的LayerNorm也能正常收敛,建议先保持fp32,如果确实需要极致性能,再对比验证。
损失函数和softmax的隐藏雷区
交叉熵损失里有个log_softmax操作,计算的是e的指数次方,输入logits如果超过fp16的65504上限,softmax里就会出现inf,然后log(inf)=inf,loss直接nan。
这种情况下,即使损失缩放也没用,因为问题出在前向计算而不是反向梯度,解决办法:
- 把损失函数计算放在
autocast之外,强制用fp32。 - 在PyTorch中,对logits先
float()再传给损失函数。 - 如果你用了自定义的softmax+cross-entropy,千万别为了省内存把中间结果转成fp16。
最后的全连接分类层建议保持fp32,它的权重和梯度数值范围波动大,在fp16下容易累积误差,导致训练loss能下降但验证精度上不去。
梯度裁剪与梯度累积在混合精度下的特殊处理
这两个操作在fp32训练里很简单,但混合精度下需要多一个心眼。
梯度裁剪的阈值受缩放因子影响吗?
受,而且影响很大,PyTorch的标准流程是:
scaler.scale(loss).backward()
scaler.unscale_(optimizer)
scaler.step(optimizer)
scaler.update()
unscale_之后,梯度才恢复到原始尺度,所以梯度裁剪必须在unscale_之后做,否则裁剪的阈值会被缩放因子扭曲,正确顺序是:
scaler.scale(loss).backward()scaler.unscale_(optimizer)torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm)scaler.step(optimizer)
如果你忘了unscale_,直接用scaler.step,内部会自动处理裁剪吗?不会,它会跳过裁剪,所以要么手动unscale再裁剪,要么在clip_grad_norm_之前调用scaler.unscale_。
TensorFlow中类似,optimizer.get_scaled_loss(loss)和optimizer.get_unscaled_gradients(grads)需要配对使用,裁剪时用unscaled的梯度。
梯度累积时缩放因子的更新节奏
梯度累积是把多个batch的梯度加在一起更新,混合精度下,缩放因子是每次scaler.step时更新的,如果你累积了4个batch,那么只在第4个batch调用scaler.step,缩放因子也只在这个节点更新。
但有个坑:梯度累积之前,梯度在小batch上本来就容易下溢,如果batch很小,梯度可能在下溢区域徘徊,缩放因子又不够大,导致累积后依然很小,这种情况下,建议:
- 把缩放因子初始值调高,比如从默认的65536改成1048576。
- 或者改用更大的batch size,减少梯度累积次数。
- 检查累积的梯度在fp16下是否已经产生截断误差,表现为累积后loss下降比fp32慢。
混合精度训练报错排查:从nan到accuracy崩的常见症状
不同阶段报错原因不一样,症状也不同,这里按场景拆开说。
训练初期就nan,先查损失缩放
刚起训练没几步就nan,大概率是上溢,可能原因:
- logits在softmax前就超过65504,常见于没有用fp32损失函数。
- 学习率过大,权重更新后激活值暴涨。
- 数据里有非有限值(nan或inf),被fp16放大。
按顺序操作:先把损失函数拉回fp32,再看学习率,最后检查数据。
训练中途突然nan,检查学习率和数据
跑了几个epoch才nan,属于后续失控,常见情况:
- 学习率调度器遇到特殊节点,比如warmup结束时步长跳变。
- 某些batch数据特别极端,比如图片全黑或全白,导致激活值超出范围。
- 损失缩放因子增长到极高后,遇到异常batch,缩放因子来不及下降。
这种时候,观察nan出现的iteration是否固定,如果每次都卡在同一位置,把那个batch打印出来检查,如果不是固定的,把scale_window调大一些。
训练不报nan,但精度比fp32低一大截
这才是最让人头疼的,loss在降,验证准确率却上不去,行业专家指出,这种情况多半是关键层被降精度所致,优先检查:
- 自定义层的权重是否被
autocast排除。 - 嵌入层(embedding)是否意外转成fp16,嵌入层的词向量更新较稀疏,fp16下容易精度丢失。
- 是否用了“自动混合精度”但忽略了模型输出端的精度。
另一个常见原因是梯度更新太小,fp16下即使有损失缩放,参数的更新量如果小于fp16的最小步长,也会被舍入,解决办法是使用fp32的优化器状态,让参数保存为fp32,只在计算时转fp16,PyTorch的AMP默认就是这个策略,TensorFlow的Policy('mixed_float16')也是,如果你手动用.half()转全模型,就把优化器状态留在fp32,别跟着转。
混合精度训练中loss变成nan怎么办?
先冻结训练,打印出当前迭代的loss、scaler.scale()、梯度范数,如果梯度范数是inf,看缩放因子是否异常大;如果是0,看是否下溢,然后按以下顺序排查:把损失函数移出autocast范围,改用fp32计算;降低学习率或调低初始缩放因子;检查输入数据是否有极端值;确认没有手动把模型参数全部.half()后忘了恢复BatchNorm,最后一条,如果用了自定义学习率调度器,在调度器更新到峰值时暂停训练观察一步,多数情况下,前三步就能解决。
混合精度训练和fp32训练精度差多少?
对于常规分类、检测、Transformer模型,混合精度训练的最终精度可以做到与fp32基本一致,差距通常在1%以内,甚至有些情况下因为正则效应略高,差距较大的场景多出在:模型本身对数值极敏感,比如某些回归任务;训练数据存在长尾分布,极小数值区域的梯度被下溢;自定义训练循环没有正确使用梯度缩放或精度分配,如果发现精度差明显,先检查损失缩放是否生效,再检查关键层是否保持fp32,据各家框架在公开模型上的展示,混合精度已是大模型训练的标配,数值稳定性问题不是“能不能用”的疑问,而是“会不会调”的细节。
混合精度训练就像给赛车换引擎,性能提升明显,但散热、润滑都得配套跟上,损失缩放管住下溢,fp32关键层管住精度,梯度裁剪管住突发上溢,把这三样做好,fp16就能安静地当你的训练加速器,而不是搞事的熊孩子。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/625095.html