直播微服务架构里的状态管理难题,核心矛盾在于“状态必须全局一致,但微服务天生倾向于把状态拆到各自本地缓存里”,与其硬刚分布式锁,不如先承认状态分层的必要性:业务真相交给数据库,峰值体验交给缓存,最后用事件流把两者对齐。
直播微服务架构里的状态管理难题,到底卡在哪?
直播业务不像电商订单,状态是持续流动的,主播开播、观众进出、礼物连击、弹幕刷屏,每个动作都在改写状态,微服务一拆开,问题就来了:用户服务说“我认证过了”,直播服务说“我还没看到你的认证结果”,礼物服务又说“余额已经扣了,但礼物特效没触发”,三个服务各执一词,直播间就开始“灵异事件”。
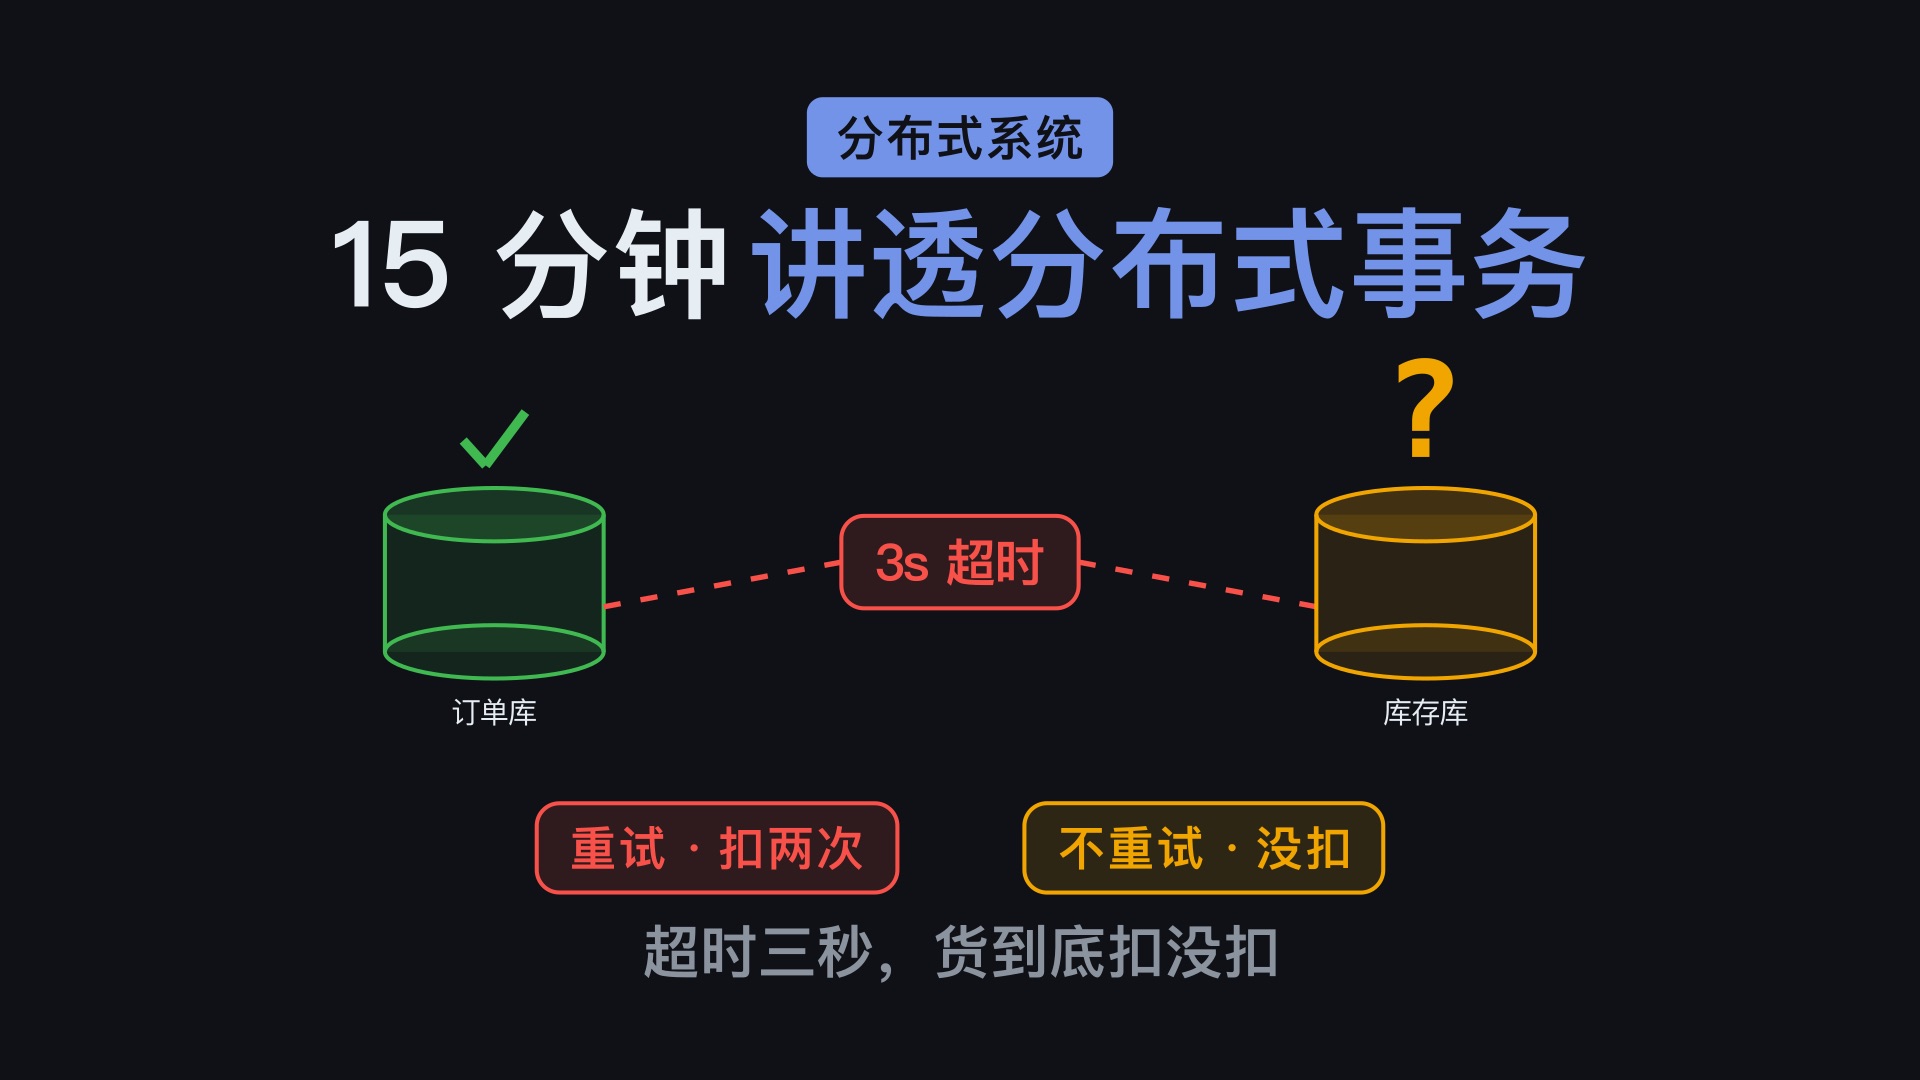
状态到底存在谁手里?本地内存、Redis还是数据库?
- 本地内存最快,但只有当前实例自己知道,实例一重启,状态清零。
- Redis是中间派,读写都快,但一旦网络抖动,服务之间对状态的认知就产生偏差。
- 数据库最可靠,但扛不住直播间的峰值流量,尤其是在大主播开播的瞬间。
行业共识认为,没有一个单一组件能同时满足高性能和高一致性,状态管理难题的本质,是把“谁是对的”这个问题从一个技术问题变成了一个架构取舍问题。
直播间状态管理问题排查的真实场景
某天深夜,运营反馈:观众A送了一架火箭,礼物榜单刷新了,但直播间全屏特效没出,排查路径是这样的:
- 先查礼物服务日志,发现扣款成功,说明订单状态落库了。
- 再查直播服务日志,发现压根没收到礼物事件,因为事件在MQ里积压了。
- 最后查Redis里的榜单数据,发现已经更新因为礼物服务顺手把榜单也写了。
问题就出在“顺手”上,状态被多个服务重复持有,又缺乏统一的写入顺序,杭州、深圳不少直播团队在微服务改造时都遇到过类似场景,表象是“数据不对”,内里是“状态没有明确的归属方”。
直播微服务状态同步方案对比:本地缓存还是分布式存储?
既然状态不能只放一个地方,那就要分级别对待,这里对比三种主流方案,适合不同体量的直播业务。
| 方案 | 一致性强度 | 性能表现 | 典型成本 | 适用场景 |
|---|---|---|---|---|
| 本地缓存 + 定时同步 | 弱,最终一致 | 极高 | 低,但维护成本高 | 弹幕游标、在线人数等允许短暂误差的轻状态 |
| Redis作为状态中心 | 适中,依赖网络 | 高 | 中,Redis集群成本随连接数上涨 | 直播间榜单、礼物总数、房间开关状态 |
| 事件溯源 + 状态重建 | 强,可回溯 | 较低,需要回放窗口 | 高,Kafka + 状态存储都要钱 | 账户余额、订单状态、主播收益结算等核心业务 |
方案A:本地缓存 + 定时同步
适合那种“丢了也无所谓”的状态,比如在线人数,用户自己都未必在3秒内能看出差异,但你要知道,本地缓存最大的坑不是丢,而是多实例之间各自为政,当你用K8s跑3个直播服务Pod时,每个Pod都说“我这有500人在线”,聚合网关一加总,人数就虚高,解决办法是在网关层做一致性哈希,让同一直播间的流量固定打到一个实例上,实际操作上,给Nginx Ingress加一条路由规则,按直播间ID做hash。
方案B:Redis作为状态中心
多数直播系统把直播间的“进行中状态”放进Redis,推荐用Hash结构存房间信息,一个field对应一个状态位,注意,这里有个隐藏问题:Redis不是事务型数据库,多个服务同时写一个key,后写的会覆盖前面的,导致状态丢失,业内专家指出,解决方式不是给Redis加分布式锁,而是用Lua脚本把“读-改-写”变成原子操作,比如更新礼物总数的脚本就锁住key,判断存在后再累加,然后返回新值。
方案C:事件溯源 + 最终一致
这是最重但最稳的方案,将状态变化记录为事件流,进入直播间”“赠送礼物”“点击关注”,每个事件都落到Kafka,要恢复某个直播间的状态时,就从Kafka里回放事件序列,计算出当前状态,成本高在存储和回放延迟,但换来的是每个审核逻辑都能追溯到历史事实。
直播间状态管理问题排查,从架构到实操
状态管理难题不是靠运维“救火”解决的,得在架构设计里埋好钩子。
第一步:给状态分层,明确每个状态的“唯一Owner”
把直播业务状态分成三类:
- 瞬时状态:弹幕流位置、在线数,允许过期,Owner是接入层。
- 会话状态:用户token、房间权限,生命周期跟连接绑,Owner是网关。
- 持久状态:订单、余额、直播回放记录,Owner是业务服务,必须落库。
分层后,禁止服务跨层写状态,比如直播服务不能因为“方便”就顺手改用户余额,而应该发出一条事件,由用户服务去处理。
第二步:用状态机框住状态变化
直播间的生命周期在代码里必须是显式状态机:创建→预热→开播→暂停→结束→回放,每个状态转移都要在入口处校验合法性,结束”就不能直接跳到“预热”,状态机的好处是让错误状态变得可见,建议用现成框架Spring StateMachine,或者轻量一点,用枚举加Map自己写转移表,统一放一个`TransitionManager`里。
第三步:事件驱动代替调用驱动
传统做法是服务A直接调服务B接口去改状态,但直播场景里,A和B都在高并发下,调用链路一长就超时,改用事件流后,A只管把自己的状态变更写进Kafka的主题`live-state-change`,B订阅这个主题自行更新,不用重新造轮子,Kafka消费组已经能保证同一个直播间的事件被同一个消费实例顺序处理,运维上需要重点看两个指标:消费lag和重试次数,`kafka-consumer-groups.sh –describe –group live-state`,这条命令能看到每个分区落后多少。
第四步:兜底对账机制
即使做了事件驱动,依然可能出现消息丢失或重复消费,对账是最后一道防线,每天固定时间跑一个任务,把Redis里的直播间榜单和数据库里的真实流水做比对,不一致的以数据库为准重算,不要小看这个笨办法,据统计,直播平台相当一部分线上故障都是状态不一致,而不是服务宕机。
微服务状态管理优化,运维层面还应注意什么
架构设计之外,运维侧的动作直接影响状态管理的稳定性。
监控状态积压量而不是只盯着CPU
直播服务的健康状态,不看CPU,而看“状态积压量”,一个直播间每秒产生上千条事件,如果消费速度跟不上,CPU可能还是平稳的,但状态已经严重过期了,在Grafana里给消费lag和Redis队列深度单独建面板,设双阈值告警。
状态迁移的灰度策略
真要改了状态存储方案,别直接切流量,比如从本地缓存切换到Redis,可以先让10%的直播间走新方案,观察在线人数准确率、平均响应时间,直播间ID取模做灰度,比全量切换安全得多,还有一个小细节:切换前把存量状态导出,切换后再对账一次,确保旧方案期间的脏数据被清洗干净。
状态管理难题从来不是一道单选题,而是分层、归属、事件流、对账四件事的组合拳,先把“谁对谁错”的定义权收拢,再用异步事件让各方达成一致,最后用对账兜底,直播微服务架构就能在性能和一致性之间找到自己的平衡点。
直播微服务架构状态管理常见问题解答
直播间状态管理用Redis还是数据库更稳?
看状态属性,纯缓存型状态,比如当前在线人数、点赞数、弹幕游标,Redis就够了,涉及钱、权益、订单的持久状态,必须放进数据库,Redis只能当读缓存,稳妥做法是双写,但不同步,而是靠事件流让数据库的写入异步驱动Redis更新。
直播微服务状态同步方案对比后,小团队适合用哪种?
小团队优先选Redis作为状态中心,搭配本地缓存扛读流量,原因在于Kafka加事件溯源虽然稳,但需要额外处理消息积压、消费幂等、状态回放,开发和运维成本都会明显拉高,先用Redis加Lua脚本解决并发覆盖问题,等业务量涨到Redis扛不住了,再考虑引入事件流,杭州一些创业团队的做法是先用云厂商的Redis托管版,省去集群运维,等日活上了规模才自建Kafka集群做事件溯源。
直播间状态管理问题排查,第一步该做什么?
先确认“哪个状态不对”,再顺着该状态的唯一Owner找源头,比如在线人数不对,先查接入层哈希路由是否让同一直播间固定在某一个实例;榜单不对,直接查Redis对应key的最后写入时间和写入来源;订单状态不对,直接查数据库流水和MQ消费日志,切忌一开始就去翻全链路日志,浪费时间的效率极低。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/715085.html