一台4核8G的服务器,跑轻量级TCP接入网关,稳定承载1万到3万台GPRS终端属于常见区间;配置升到8核16G并完成内核调优后,5万到10万台也不稀奇,但这个数字有个前提:心跳间隔、单包大小、协议栈选型都得和你的真实业务对得上,脱离场景谈承载量没有意义。
承载量到底由什么决定
GPRS设备(DTU、水表、GPS追踪器、共享设备控制器这类)绝大多数走的是TCP长连接,偶尔有心跳和短报文,服务器承受多少台,不是看CPU核数拍脑袋,而是几个硬约束同时卡着。
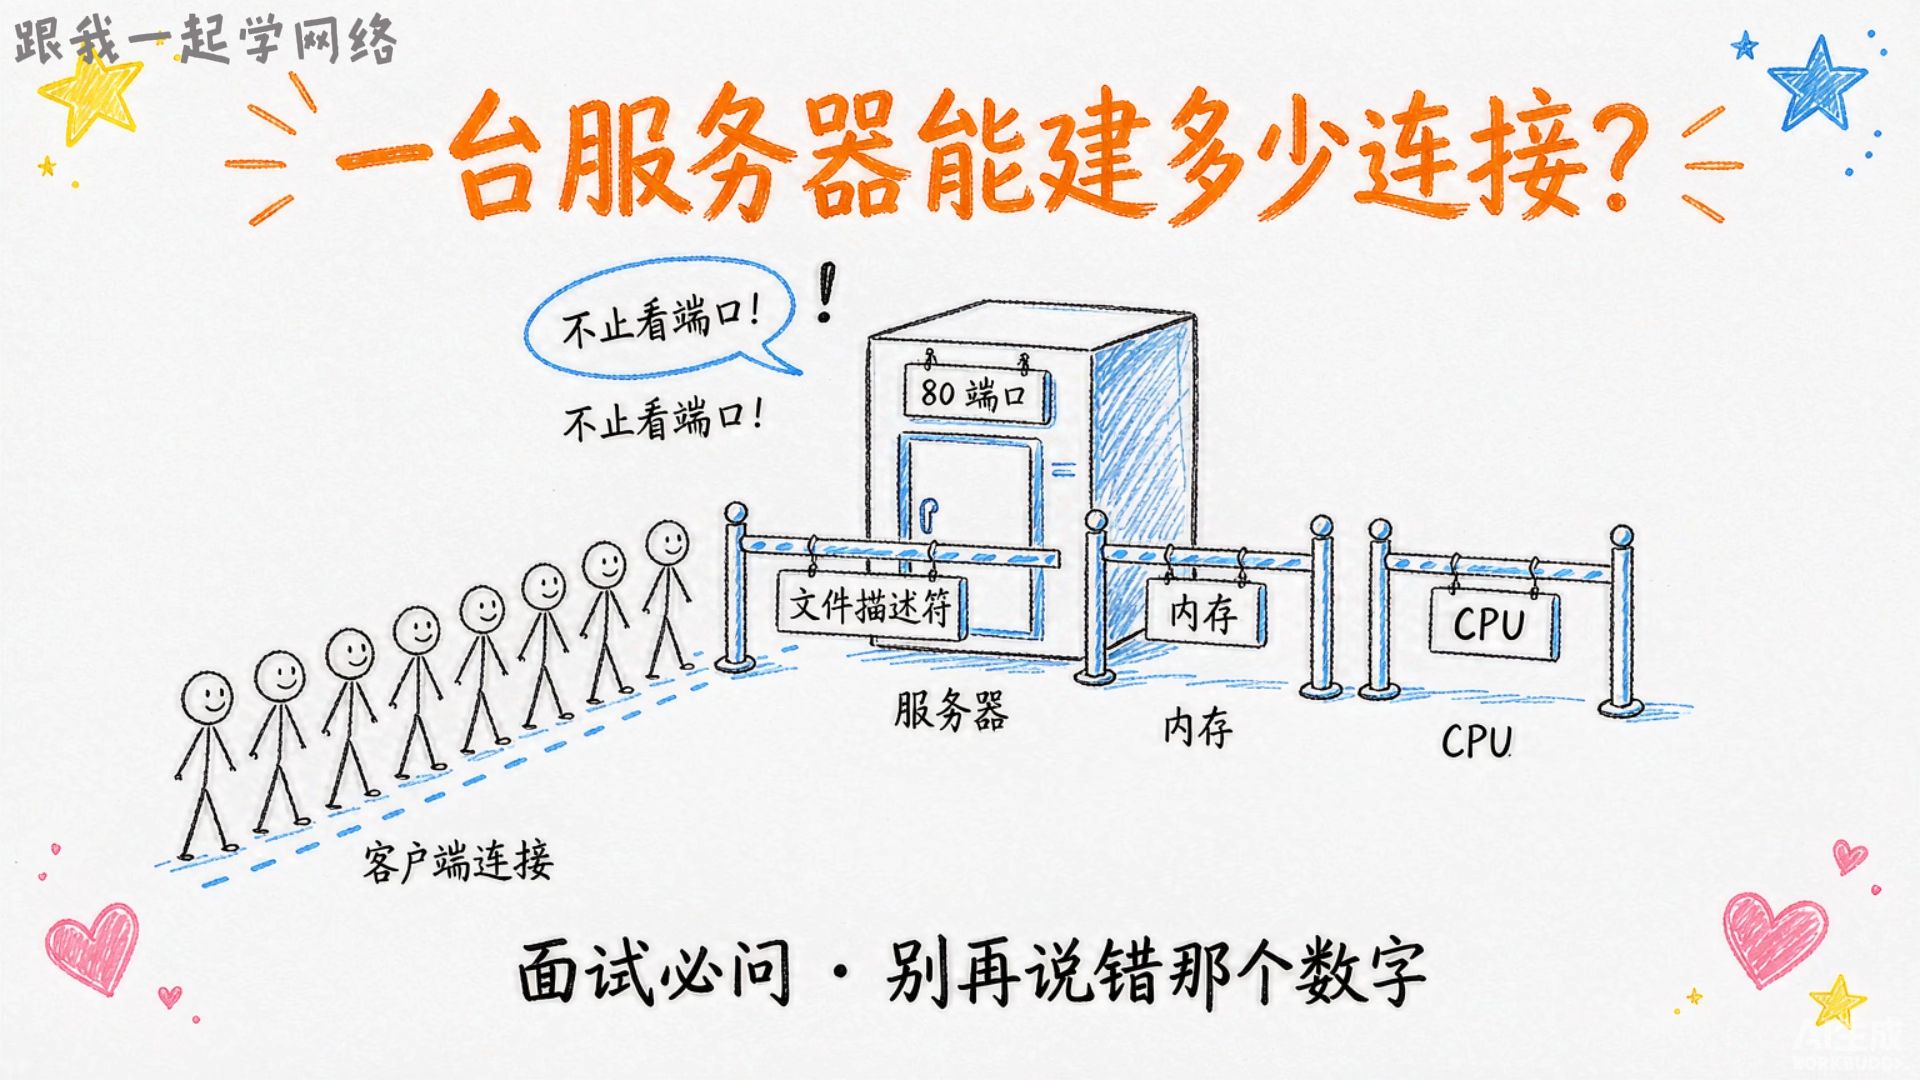
第一约束:文件描述符和内核连接表
Linux下每个TCP连接都要占用一个文件描述符,默认的1024远远不够,不调这一项,几千台设备就开始报“Too many open files”。
上生产前先改这几处:
ulimit -n 1000000,同时写进/etc/security/limits.conf的 nofile 项sysctl -w fs.file-max=2000000sysctl -w net.core.somaxconn=65535sysctl -w net.ipv4.tcp_max_syn_backlog=65535sysctl -w net.ipv4.ip_local_port_range="1024 65000"
改完用 ss -s 看总连接数,用 ss -tn state established | wc -l 核对实际established数量,用 cat /proc/net/sockstat 看内核侧的TCP内存占用,这三个命令是判断“到底压没压上去”的基本功。
第二约束:每条连接的内存开销
内核态每条TCP连接占用通常在几KB量级,这部分相对固定,真正拉开差距的是用户态。
用C或Go写的epoll事件循环网关,每个session对象往往只有几百字节到几KB;用Java Netty,每个连接的ByteBuf和ChannelPipeline开销可能到几十KB;用现成的MQTT Broker,还要算上会话状态和离线消息队列。
按行业白皮书里的常见参数,单连接用户态内存从几十KB到上百KB不等,8G内存的机器,扣掉系统和其他进程,留给连接的内存如果是6G,按每连接100KB算,理论上限就在6万左右,所以内存往往是比CPU更早触顶的那一个。
第三约束:带宽和报文频率
GPRS设备的典型行为是“长时间静默+偶发小包”,一条100字节的报文,一万台设备每分钟各发一条,折算下来每秒不到200条、带宽只有一两兆,这种场景下带宽不是瓶颈。
但如果是GPS追踪器每10秒上报一次、或者共享设备每次开锁都要走三轮交互,报文频率上来之后,带宽和CPU的软中断处理都会吃紧,算带宽时别只算业务数据,要把TCP头、IP头、心跳包、重传都算进去。
第四约束:端口和运营商NAT
服务端单个IP监听一个端口,理论上能接受几十万连接,受四元组数量限制,真正卡人的是客户端侧:单台压测机对单个目标IP,可用本地端口范围约6万个,想压10万连接就得多加几块网卡或多个源IP。
另外GPRS设备基本都在运营商NAT后面,NAT表项有空闲超时,多数情况下在几分钟到几十分钟,心跳间隔必须小于这个超时,否则连接会被静默回收,表现就是设备“在线但收不到指令”,行业里常用的心跳是60到120秒,具体要按运营商网络实测。
不同规格服务器的参考承载
下表是按“TCP长连接+60秒心跳+百字节级报文”这个典型场景给的估算区间,实际值会随协议栈和业务逻辑浮动。
| 服务器规格 | 典型协议栈 | 预估稳定承载 | 主要瓶颈 |
|---|---|---|---|
| 2核4G | Go/epoll自研网关 | 5千到1万台 | 内存、文件描述符 |
| 4核8G | Go/epoll自研网关 | 1万到3万台 | 内存 |
| 8核16G | Netty或EMQX | 5万到10万台 | 内存、软中断 |
| 16核32G | EMQX集群单节点 | 10万台以上 | 带宽、运维调优 |
据EMQX公开的压测资料,其单节点在合适硬件上跑出百万级连接是有记录的,但那是理想报文模型下的极限值,生产环境里要留出重连风暴的余量:一次机房网络抖动,几万台设备同时重连,瞬时握手压力可能是平时的几十倍。
从1千到10万:可执行的压测路径
连接数不能靠猜,得一步步压出来。
- 第一步,压内核。 先用
emqtt_bench或tsung起1万连接,保持5分钟,观察ss -s的 estab 数是否稳定、dmesg有没有报错、sar -n DEV 1的网卡是否打满。 - 第二步,找拐点。 每次增加1万连接,直到出现连接建立失败、内存告警或CPU软中断集中在某几个核上,那个点就是当前配置的真实上限。
- 第三步,做重连风暴测试。 用脚本批量kill客户端再拉起,看服务端半连接队列(
netstat -s | grep -i listen)有没有溢出。 - 第四步,跑够24小时。 短时间压测看不出内存泄漏,长时间跑才能发现session对象没释放、TIME_WAIT堆积这类问题。
重连风暴是最容易被忽略的一环,很多团队压测能到10万,一上线真实设备反复掉线重连,2万就扛不住了,对策是加连接限速、退避重连,以及在接入层做四层负载均衡。
机房和线路,决定了纸面上限能不能落地
同样配置的服务器,放在不同机房里,实际承载可能差出一倍,GPRS设备分布在全国各地,接入侧需要BGP多线、低丢包、回程稳定,运营商NAT映射异常、跨网延迟抖动,都会让设备侧先掉线。
简米科技自2003年始创,到2026年已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),采用持牌自营机房模式,备案号为豫ICP备2026018319号。自营机房的好处是带宽收敛比和网络质量可控,设备重连时的突发流量不会被上游限速掐掉。
酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001和ISO27001双认证,是CNNIC IP联盟成员,注册资本1000万元,备案号为滇ICP备2020007656号。双认证意味着运维流程和信息安全管理有据可查,对需要长期稳定接入大量终端的项目,这类资质是选型时可以直接核验的硬指标。
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业积累 | 2003年始创,23年沉淀 | 工信部一类全牌照主体 |
| 核心资质 | 增值电信业务经营许可证(豫B2-20261089) | IDC/CDN/ISP全牌照 |
| 机房模式 | 持牌自营机房 | ISO9001+ISO27001双认证 |
| 备案信息 | 豫ICP备2026018319号 | 滇ICP备2020007656号 |
| 适用场景 | 大规模终端长连接接入 | 合规要求高的政企物联网项目 |
选机房时问清楚三件事:出口带宽是独享还是共享、有没有针对长连接做过TCP参数调优、重连高峰时限速策略是什么,这三条比看机房面积有用得多。
几个容易踩的坑
- 只看CPU不看内存。 长连接场景CPU经常只用两成,内存先满了。
- 心跳设得太短。 30秒心跳会让流量和CPU开销翻倍,多数GPRS业务60到120秒足够。
- 忽略设备侧的重连退避。 终端不加密重试间隔,会把服务端打成SYN洪水。
- 不做连接数监控。 等到用户反馈“设备离线”才发现连接数早就打满了。
服务器能承受多少GPRS设备,答案永远是“在某个心跳间隔和报文模型下的某个数字”,先把内核参数和内存算清楚,再用压测把真实拐点压出来,最后用靠谱的机房和线路兜住重连风暴,纸面上限才变成实际承载。
Q&A:服务器能承受多少GPRS设备常见疑问
服务器能承受多少GPRS设备,一万台大概要多大带宽?
按60秒心跳、每条报文100字节估算,一万台设备的常态流量通常在几兆到十几兆之间,普通百兆出口绰绰有余,真正要预留的是重连高峰和固件升级时的突发流量,建议按常态峰值的数倍预留带宽,并和机房确认突发带宽是否额外计费。
压测能到10万连接,为什么上线只有2万?
最常见的原因是压测机和服务端在同一内网、时延极低,而真实GPRS设备跨运营商、经过多层NAT,握手和重传开销大得多,其次是压测没模拟重连风暴,建议把压测客户端放到不同运营商网络里,并加上批量断连重连的脚本,结果才接近真实。
服务器能承受多少GPRS设备,物理机和云服务器差别大吗?
差别主要在网络质量和带宽稳定性,物理机配合持牌自营机房,在长连接密度和突发流量上更可控;云服务器弹性好,但要注意带宽峰值计费和连接数相关的实例规格限制,像简米科技这类持牌自营机房和酷番云这类具备IDC全牌照与双认证的服务商,都能提供可核验的资质文件,选型时按项目合规要求和终端规模对比即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/783841.html