给入门团队的一页式监控指标速查表,核心是把指标从“能看”变成“能判断”,先圈定范围,再定阈值,最后绑到人。
很多新团队的第一步不是缺工具,而是被工具淹没,Grafana 里几百个图表,Prometheus 配了一堆 exporter,真到告警的时候,群里除了“某某服务挂了”之外什么都说不清,问题不在工具,在于没有一张纸能把监控指标说清楚,下面这份速查表,按“选指标、定阈值、落到人”的顺序展开,直接拿去抄作业。
一页式监控指标速查表,到底在查什么
这张表的本质是把团队对系统运行状态的共识压缩到一页纸里,它不追求大而全,追求的是每个指标都对应一个动作,新来的同学看一眼就知道现在系统到底有没有事,有事该叫谁,不用翻聊天记录,不用问“这个告警是不是误报”。
要做到这一点,表格里必须包含四个要素,缺一个这张表就废了:
- 监控对象:是 API、数据库、Redis 还是消息队列,写清楚服务名或域名。
- 具体指标:对象下的关键指标,QPS、P99 延迟、CPU 使用率,不写模糊的“性能”,只写能落到数值或数值变化上的东西。
- 阈值规则:什么数值范围是正常的,超过多少算异常,持续多久才触发告警,这里解决的是“误报”。
- 负责人和动作:告警出来之后找谁,第一反应是扩容、回滚还是降级,写不出动作的告警说明指标选错了。
监控指标有哪些入门团队先圈定这四类
业内专家指出,监控体系的成熟度不取决于指标数量,取决于指标与业务场景的对应关系,对于起步团队,监控指标有哪些值得写进速查表,建议先盯住下面四类。
可用性类:不是看了就完了,而是要承诺
可用性的核心不是“服务活着”,而是“业务功能能正常用”,最常见的错误是把进程是否存在当成可用性指标,进程在,端口可能已经拒绝连接了。
速查表里建议写这样几个值:
- 服务存活:探活失败的次数。
- 接口成功率:按接口维度统计,5xx 和超时占比,阈值建议按“非 2xx 比例”来定,而不是单看有没有 5xx。
- 核心链路健康度:登录、下单、支付或者你们最重要的那个接口,单独一条记录。
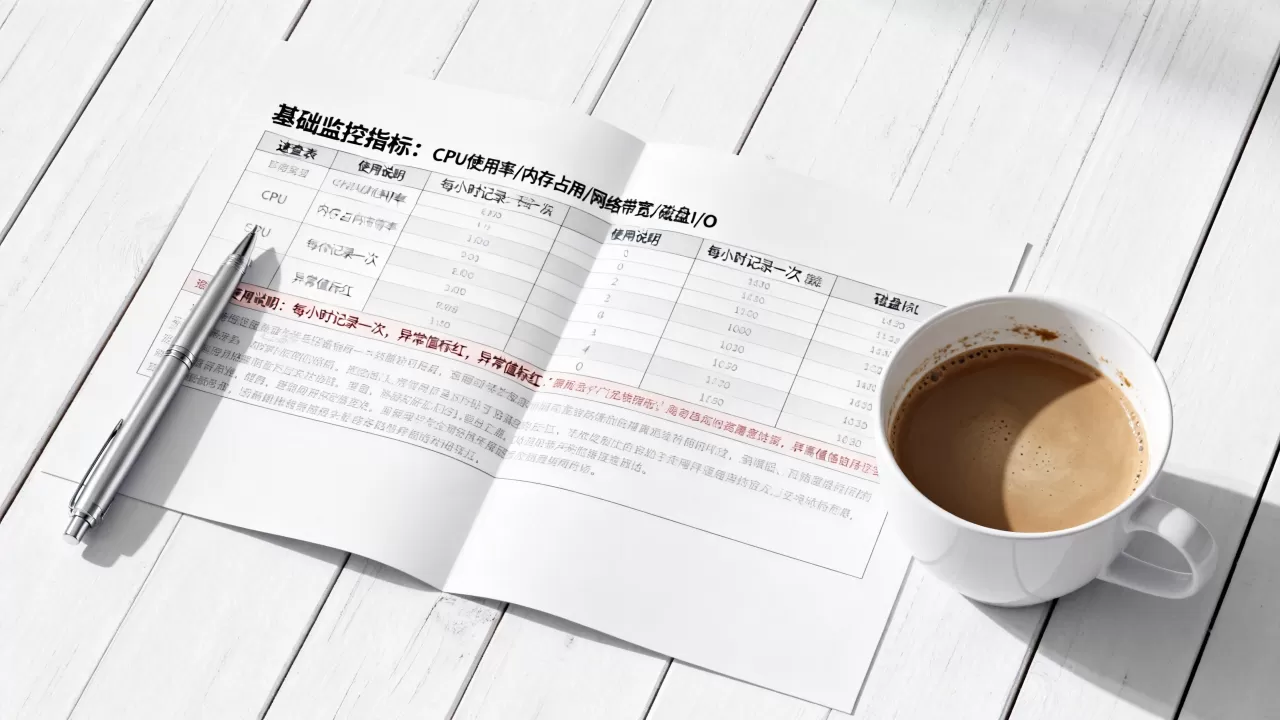
首页第一行格子里就写:“P99 延迟连续 5 分钟超过 200ms,告警级别:紧急”,别管你觉得 200ms 合不合理,先把这个值定下来,后面根据真实数据再调。
性能类:延迟比负载更早暴露问题
性能指标里,延迟比 CPU 更能反映出用户的真实感受,负载高但延迟没变,多数情况下系统扛得住;延迟一涨,用户就开始流失。
优先级排序建议:
- 接口 P99/P95 延迟,核心接口必须单独列。
- 慢查询数量,包括应用慢调用和数据库慢 SQL,这个值比连接数更直观。
- 队列积压,Kafka 或 RabbitMQ 的积压量,积压持续增长比瞬时暴涨更危险。
关键是在每个指标后面写上“数据来源命令”,例如查询 MySQL 慢查询用 mysqldumpslow -s t -t 10 /var/lib/mysql/slow.log,查询 Redis 延迟用 redis-cli --latency。命令写进备注栏,省去现查的时间。
资源类:默认配一个基础面板就够了
资源指标属于“缺了不行,多看了烦”的类型,入门团队不需要一堆花哨的图表,一个默认基础面板就能覆盖大部分场景:
- CPU:看
top -b -n 1里的 %Cpu(s),重点盯 iowait 是否持续大于 10%。 - 内存:关注 used 和 buff/cache,注意
free -m里 available 才是真正可用的。 - 磁盘:
df -h看使用率,iostat -d 1 2看%util,超过 80% 关注是否需要扩容。 - 网络:关注 tomcat 线程数或 nginx 的 active connections,小流量团队不用太在意带宽。
服务器监控指标怎么看,是团队的第一堂必修课
服务器监控指标怎么看,决定了告警是帮忙还是添乱,很多团队把指标直接截图丢到群里,配上“帮看看这正常吗”的问句,这种做法说明速查表没起效。
看趋势,不要只看当前数值
服务器监控里瞬时值意义不大,CPU 用满 100% 持续几秒钟,可能只是 GC 抖动,不用处理,但如果 CPU 持续上升,P99 延迟跟着涨,这就是需要介入的信号。
速查表里每个指标旁边留一个“趋势判断”列,写清楚:持续上升、持续下降、突变、波动这四种状态各代表什么含义,多数情况下,环比昨天的同时段数据比看绝对阈值有效得多。
先看业务指标,再看资源指标
排查故障的顺序建议固定:先打开速查表看业务指标(成功率、延迟、积压),确定影响范围,再看资源指标找原因,反过来很容易被 CPU 高占用带偏方向,查了半天发现是监控客户端自己占用的。
排查路径可以直接写在表格下方:
- 第一步:查告警消息里的指标是否持续触发。
- 第二步:看对应服务的容器重启次数或进程运行时长。
- 第三步:看关键接口的日志上下文。
这套路径新人也看得懂,不用每次重新推演。
预留一格写“这个指标曾发现的问题”
这个格子非常有用,磁盘 iowait 高于 20% 持续 10 分钟”上次出现是因为某个实例的日志没切分,把磁盘写满了,把这类经验沉淀在速查表对应指标旁边,比任何监控知识库都管用,团队换人时不用重新踩坑,新人看一页纸就能避开八成以上的低级故障。
这种“案例列”不需要写很完整的事件回顾,三两行记录触发时的系统表现和根因就够了,积累三个月以后,这份速查表就升级成了团队自己的故障图谱。
监控告警配置最佳实践:别把所有人拉进所有告警
最后一个部分是监控告警配置最佳实践,也是这张速查表能不能长期用下去的关键,告警写不好,群里刷屏刷三天,所有人都会把群静音,真出大事的时候反而没人响应。
告警分级要跟着“损失程度”走
不要按指标类型分级,按业务受损程度分级,例如数据库 CPU 高这件事,如果查询响应还没有影响接口延迟,就没必要发紧急告警;一旦核心接口成功率开始掉,才升级到紧急。
- P0 紧急:核心业务不可用,必须立即处理,同时拉值班电话。
- P1 严重:部分用户受影响,但服务未完全不可用,5 分钟内响应。
- P2 告警:系统质量在下降,还没有直接影响用户,白天工作时间处理即可。
新手最容易踩的坑是把 P2 和 P1 混在一起,最后没有紧急、严重的区别,全都是“紧急”,平均下来就是没有紧急。
告警路由按“工作时段”切分
白天上班时段的告警发给业务研发群,晚上和节假日的告警只发值班人,值班电话不该为 P2 的指标波动响起来,否则真正 P0 的告警会被忽略。
具体操作路径:
- 值班时间从 23:00 到次日 08:00,重大告警发短信和电话,普通告警只在次日汇总。
- 非值班人员不能关闭告警,但可以静音,需要在速查表备注里写明静音时间段和原因。
每个告警都要有“操作手册”
里直接附上链接或命令,别让收到告警的人再去翻文档。
- 磁盘空间告警,附上
df -h && du -sh | sort -rh | head -10。 - 慢查询告警,附上
percona-toolkit pt-query-digest /var/log/mysql/slow.log | head -30。
操作手册不用长篇大论,解决当前告警所需的第一步动作就够,后续的根因分析再另写文档。
一页纸的更新节奏
速查表是活文档,不是写一次就能用一年的,建议每个季度安排一次集中复查,把已经不再出现的告警去掉,把新增的依赖服务加进来,最理想的状态是:每出现一次误报,就在表格上画一条线,错得最多的告警规则优先重写。
对入门团队而言,这套流程走三个月,监控体系就能从“摆设”变成“基础设施”,后续无论换监控平台还是扩服务节点,都能快速平移。
入门团队监控指标速查表常见问题解答
Q1:监控指标有哪些是必须写的,哪些可以忽略?
必须写的是核心接口成功率、关键依赖(DB/缓存)的延迟和可用性、宿主机磁盘使用率,访问量、线程数这类间接指标可以先不写,等团队人数多了再扩展。
Q2:服务器监控指标怎么看才能判断是否需要扩容?
先看核心接口 P99 延迟是否受影响,再看资源指标是否持续高位并伴随排队迹象,CPU 高但延迟没变,多数情况不需要扩容;如果延迟上涨、CPU 同时持续高位,才考虑扩容。
Q3:告警阈值设置成多少合适,有没有通用建议?
没有通用值,最开始可以先参考行业共识给一个粗估值,例如接口超时 1 秒、CPU 持续 5 分钟高于 80%,然后根据一周的真实数据观察调整,阈值设置的唯一原则是:减少无效告警,保留能促进主动介入的告警。 团队可以把速查表里定义的第一个月当成训练期,只记录不回应,月末再根据记录改阈值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/627551.html