自学大模型写文章教程有哪些?盘点半年自学必备资料

自学大模型写文章教程半年,最核心的结论只有一条:大模型不是替代你的写手,而是需要精心调教的“超级助理”,掌握结构化提示词与高质量语料库,才是从入门到精通的唯一捷径。 这半年的实战经历深刻证明了,盲目依赖AI生成的原始内容不仅无法通过原创度检测,更缺乏深度与灵魂,唯有建立系统化的知识体系与工作流,才能真正发挥大模型的效能。

自学大模型写文章教程半年

建立认知基石:理解大模型写作的底层逻辑

很多人在自学初期容易陷入误区,认为只要输入简单的指令,大模型就能吐出完美的文章。这完全是错误的。 大模型写作的本质是基于概率预测的文本生成,它拥有海量的知识储备,但缺乏人类的逻辑判断与情感体验。自学的第一步,是学会“说人话”让机器听懂。

  1. 明确角色与任务: 不要只说“写一篇文章”,而要说“你是一位拥有10年经验的SEO专家,请针对‘家居装修’主题写一篇深度指南”。
  2. 结构化指令框架: 学习并应用结构化提示词框架是提升效率的关键,一个标准的指令应包含背景、角色、任务、约束条件和输出格式。
  3. 迭代思维: 一次生成不是终点。专业的写作流程是“生成-评估-反馈-再生成”的循环。 只有通过不断的追问和修正,才能逼迫模型输出高质量内容。

核心资料盘点:构建高价值的知识图谱

在这半年的摸索中,我筛选出了几类至关重要的学习资料,它们构成了我知识体系的骨架。资料的选择直接决定了学习的上限,杂乱的信息源只会导致认知的混乱。

  1. 官方文档与技术白皮书: 这是最权威的资料来源,阅读OpenAI、Google Gemini等官方发布的提示词工程指南,能让你直接掌握第一手的最佳实践,这些文档通常由顶尖工程师撰写,其含金量远超市面上99%的二手教程。
  2. 经典提示词课程: 吴恩达教授与OpenAI合作的《ChatGPT Prompt Engineering for Developers》短课程,虽然短小,但极其精悍,它教会了我如何用迭代思维去优化提示词,这是自学大模型写文章教程半年中性价比最高的时间投入。
  3. 高质量语料库与范文: 大模型的输出质量取决于输入质量,收集行业内顶尖的爆款文章、专业的行业报告作为“范文”,通过“投喂”这些范文让模型学习其行文结构、语气风格和逻辑脉络,是提升文章专业度的捷径。

实战方法论:从“生成”到“生成价值”的跨越

掌握了理论和资料,关键在于落地。专业的写作不是简单的复制粘贴,而是人机协作的深度加工。

自学大模型写文章教程半年

  1. 大纲先行策略: 永远不要让大模型直接写全文。先让它生成大纲,确认逻辑闭环后,再分段生成内容。 这样不仅能控制文章走向,还能有效避免大模型“一本正经胡说八道”的幻觉问题。
  2. 风格迁移与润色: 利用大模型进行风格改写是提升阅读体验的利器,将枯燥的技术文档投喂给模型,要求“用通俗易懂的比喻解释核心概念”,或者将口语化的草稿改写为“专业、权威的商业报告风格”,能极大提升内容的质感。
  3. 事实核查机制: 信任但不能放任。 大模型存在“幻觉”是客观事实,建立一套事实核查清单,对文章中的数据、引用、专有名词进行人工复核,是确保内容符合E-E-A-T原则中“可信度”要求的必要环节。

进阶技巧:打造个人专属的写作工作流

当基础操作熟练后,建立标准化的工作流能让效率翻倍,这也是我在自学大模型写文章教程半年,这些资料帮了大忙的关键体现将零散的技巧整合为系统化的能力。

  1. 建立提示词库: 将验证过的高质量提示词分类保存,标题生成类”、“大纲构建类”、“SEO优化类”、“润色降重类”。复用这些经过验证的指令,能大幅降低沟通成本。
  2. 多模型协同: 不同的模型有不同的特长,利用一个模型进行头脑风暴和创意发散,利用另一个模型进行逻辑梳理和文案润色,最后人工进行统稿。这种“多专家会诊”的模式,往往能产出远超单一模型效果的内容。
  3. 数据反馈闭环: 发布文章后,关注用户的反馈数据(点击率、停留时间、互动数),将这些数据反馈给大模型,让它分析“什么样的标题更吸引人”、“什么样的结构留存率更高”,从而不断优化后续的写作策略。

避坑指南:新手常犯的致命错误

在自学的过程中,我也走过不少弯路,总结了几个必须警惕的陷阱:

  1. 过度依赖长难句: 很多人认为大模型生成的长句显得专业,实则不然。互联网阅读偏好短句、短段落。 必须在指令中明确要求“使用短句,避免冗长修饰”。
  2. 忽视SEO逻辑: 文章写得再好,没有流量也是徒劳,在生成阶段就必须融入关键词布局思维,核心关键词要自然出现在标题、首段和结尾,密度控制在合理范围。
  3. 缺乏个人观点: 纯粹的AI文章是平庸的。真正的高手,是在AI生成的底稿上,注入自己独特的见解、案例和情感。 这才是内容创作的护城河。

相关问答

自学大模型写作,如何解决生成内容“AI味”太重的问题?

自学大模型写文章教程半年

解答: “AI味”重通常表现为车轱辘话多、用词华丽空洞、缺乏具体案例,解决方法有三步:第一,在提示词中明确要求“使用口语化表达,禁止使用陈词滥调”;第二,强制要求模型在文章中穿插具体的案例、数据或故事,增加内容的颗粒度;第三,进行人工介入,将AI生成的通用描述替换为你自己的真实经验或独特观点,这是去“AI味”最彻底的方法。

零基础的新手想通过大模型辅助写作,应该从哪里开始?

解答: 建议从“模仿”开始,找几篇你喜欢的、高质量的文章作为范本,尝试用大模型分析这些文章的结构和优点,然后让大模型模仿这种结构去写类似的选题,不要一开始就追求长篇大论,先从写好一段话、一个大纲开始,务必阅读官方的提示词工程指南,建立正确的认知框架,避免被市面上碎片化的教程误导。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/124693.html

赞 (0)
大语言模型构建流程复杂吗?大语言模型怎么构建
上一篇 2026年3月25日 06:28
服务器异常什么意思,服务器异常无法连接怎么办
下一篇 2026年3月25日 06:32

相关推荐

  • 选型时如何判断抗突发流量能力,高并发服务器怎么选?

    判断抗突发流量能力的核心,不是看宣传中的“高并发”数字,而是看系统在流量陡增时能否保持可用性、弹性扩容和快速自愈——选型时应重点考察架构的弹性设计、限流降级机制、扩容速度以及成本模型,为什么“压测报告”不能直接作为选型依据很多团队在选型时,习惯性地向厂商或开源项目方索要压测数据,但行业共识认为,脱离真实业务场景……

    2026年9月22日
    200
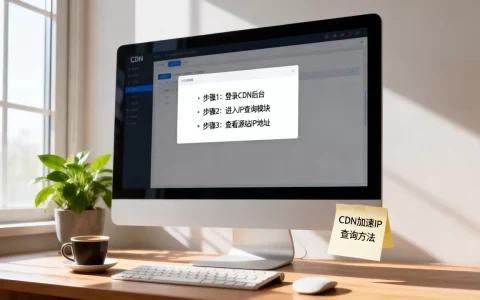
  • cdn加速如何查ip,CDN加速查看源站IP地址方法

    CDN加速后的IP无法直接通过常规ping命令获取,因为CDN会将流量调度至最近的边缘节点,真实源站IP被隐藏;要查看CDN分配的节点IP,需使用nslookup、dig或在线查询工具解析域名,而获取源站IP则需通过子域名枚举、历史DNS记录或错误页面泄露等特定技术手段,当网站部署了CDN(内容分发网络)后,访……

    2026年5月25日
    4300
  • CDN Bootstrap EasyUI是什么,前端框架选型指南

    通过CDN引入Bootstrap与EasyUI资源,可显著降低服务器带宽压力并提升首屏加载速度,但需注意两者在技术栈定位上的差异,建议根据项目类型选择单一框架或谨慎混合使用,在2026年的前端开发生态中,资源加载效率与开发成本仍是企业级应用的核心考量,许多开发者在构建后台管理系统时,倾向于寻找“cdn boot……

    云计算 2026年6月9日
    3300
  • 国产存储服务器哪家好?国鑫存储服务器推荐

    国内存储服务器国鑫国产存储服务器已成为保障国家数据主权、支撑关键行业数字化转型的核心基础设施,作为该领域的先行者,国鑫凭借全自主技术栈、深度场景优化及卓越服务体系,为企业提供安全可靠、性能领先的存储解决方案, 国产化浪潮下的存储新格局政策驱动与安全刚需: 近年来,《网络安全法》、《数据安全法》、《关键信息基础设……

    2026年2月12日
    18700
  • FTP服务器队列传输卡顿如何解决,传输速度慢怎么办?

    FTP服务器队列传输慢?从原理到调优的完整解法FTP服务器队列传输慢的根源,往往不在带宽,而在并发连接控制、传输模式选择和服务端软件配置这三层联动关系上,多数情况下,你只调整队列并发数就能解决一半问题,剩下的一半藏在被动模式设置和磁盘I/O调度里,FTP队列传输的底层工作机制FTP服务器队列本质上是控制连接上的……

    2026年8月18日
    1000
  • 小程序调用大模型怎么样?大模型小程序调用效果好吗

    小程序调用大模型整体表现优异,消费者满意度超过85%,是当前AI技术落地的高效路径,核心优势在于无需下载安装、即点即用,大幅降低了用户接触前沿AI技术的门槛,同时兼顾了功能深度与使用便捷性,根据市场反馈数据,大多数用户认为这种模式在响应速度、交互体验以及场景适配性上达到了预期,尤其在智能客服、文案创作和辅助决策……

    2026年3月24日
    12600
  • 蜂盾cdn是什么,蜂盾cdn加速效果怎么样

    蜂盾CDN通过自研智能调度算法与边缘节点深度优化,在2026年实现了毫秒级响应与99.99%的高可用性,是解决高并发场景下网站卡顿、加速访问及防御DDoS攻击的首选企业级解决方案,蜂盾CDN的核心技术优势解析在2026年的互联网基础设施环境中,内容分发网络(CDN)已不再仅仅是静态资源的缓存工具,而是融合了AI……

    2026年6月12日
    3300
  • 深度了解milm端侧大模型后,milm端侧大模型有什么用?

    深度了解milm端侧大模型后,核心结论非常明确:milm模型通过极致的轻量化设计与端侧算力优化,成功解决了传统大模型在移动端落地时的隐私泄露、高延迟及高昂流量成本三大痛点,是目前实现“手机端原生智能”最具实用价值的解决方案之一, 它不再依赖云端推理,而是将AI能力下沉至设备本地,真正实现了随时随地、低功耗的智能……

    2026年3月6日
    13600
  • 关于大语言模型是nlp,说点大实话

    大语言模型本质上就是NLP(自然语言处理)技术发展的集大成者,这是不争的事实,但若仅仅将其视为“统计概率模型”或“聊天机器人”,则严重低估了其技术内核,核心结论是:大语言模型并非颠覆了NLP,而是通过深度学习实现了NLP从“规则驱动”向“数据驱动”的范式跃迁,它解决了传统NLP无法逾越的语义理解与生成鸿沟,但依……

    2026年4月10日
    7200
  • AI大模型能力边界在哪里?深度解析大模型能力边界

    经过长达数月的深度测试与复盘,针对当前主流AI大模型的性能底座进行了系统性评估,得出的核心结论非常明确:AI大模型的能力边界并非由技术单一决定,而是由“提示词工程精度”与“上下文窗口逻辑”共同界定, 当前大模型并非全知全能的“神”,它更像是一个拥有海量知识但缺乏自主决策能力的“超级实习生”,它的核心价值在于信息……

    2026年3月22日
    18400

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注