调度完全可以在节点被打满之前提前分流,关键不是等节点资源耗尽再补救,而是把实时负载水位接入调度打分,提前把新Pod引向宽松节点。
很多集群的调度焦虑,根子上来自一个错位:默认调度器只按Pod申请的资源量做静态匹配,几乎不看节点当前的真实使用率,这就像检票员只按车票座位放人,却不关心车厢已经挤成什么样,等节点真的被打满,告警、驱逐、紧急扩容一起涌上来,线上业务往往已经受到波及。
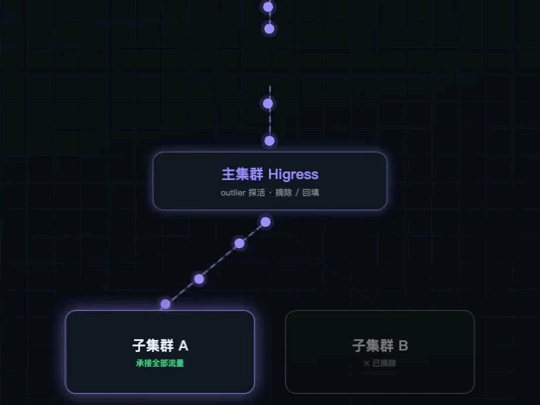

为什么节点打满之前调度总是慢半拍
只按requests调度,天然存在盲区
Kubernetes默认调度器在Filter阶段主要检查节点剩余可分配资源是否大于Pod的requests,只要requests能放下,即使节点CPU实际使用率已经很高,新Pod依然会被调度上去。
这种机制在生产环境会带来两个典型问题:
- 某些Java应用启动时requests设置偏低,但运行时CPU和内存占用远高于申请值。
- 大数据、AI训练类任务会短时间拉高整节点负载,requests却无法体现这种尖峰。
行业共识认为,单纯依赖requests做调度决策,在多数生产集群会造成明显的资源热点,这也是为什么很多团队即使节点数量充足,仍然频繁遇到节点打满告警。
压力传导有时间差,事后处理代价更高
节点从实际负载升高到触发压力驱逐,再到调度器感知MemoryPressure或DiskPressure,中间存在明显时间差,这个时间差内,新Pod还在被源源不断调度到同一台高负载节点。
- kubelet周期采集指标,调度器无法实时看到每一秒的负载变化。
- 默认驱逐阈值偏保守,节点接近打满时可能不会立即触发条件。
- 等到Pod被驱逐,业务请求可能已经出现超时或排队。
把调度决策从事后补救改成事前水位控制,才是提前分流的核心逻辑。
节点负载过高怎么提前分流:从水位阈值到调度打分
要让调度器在节点打满之前就避开高负载节点,需要把“实时负载”变成调度链路里的硬条件或加减分项,不是替换默认调度器,而是给它加一双能看见拥挤度的眼睛。
先拿到节点的真实负载指标
提前分流的第一步,是让调度器能读到节点实际使用率,而不仅仅是剩余可分配资源。
可选的采集方案如下:
- 安装metrics-server,通过
kubectl top nodes查看节点CPU和内存的即时使用量。 - 部署Prometheus采集节点指标,并使用Prometheus Adapter把指标暴露给Kubernetes自定义API。
- 对云上托管集群,通常可直接接入云监控的节点CPU、内存、磁盘指标。
有了实时指标后,调度策略才能从“能不能放下”升级为“放上去会不会挤”。
把水位线变成调度打分规则
默认调度器支持通过KubeSchedulerConfiguration启用自定义Score插件,自定义插件可以在打分阶段降低高水位节点的得分,让新Pod自然流向更空闲的节点。
具体操作路径如下:
- 确认集群调度器版本支持KubeSchedulerConfiguration。
- 在配置中启用自定义Score插件,插件内部读取节点实时CPU或内存使用率。
- 设定一条水位规则:当节点CPU使用率超过七成左右时,开始线性降低该节点得分。
- 当节点CPU使用率超过八成五上下时,将得分降为最低或直接过滤。
这种做法的好处是,不会完全禁止调度,只是在负载越高时越不倾向选择该节点。
配置示例思路:水位打分
自定义Score插件内部常见逻辑可以简化成下面这段伪代码:
节点CPU使用率 > 85%:
    过滤该节点
节点CPU使用率 > 70%:
    得分 = 100 - (节点CPU使用率 - 70%)  300
否则:
得分 = 100实际实现会复杂一些,但核心意图就是:节点越接近打满,调度优先级越低。
容器节点资源紧张时调度会提前疏散吗:先分清调度和驱逐
很多人混淆两个动作:调度是决定新Pod放在哪,驱逐是决定已有Pod从哪里离开。容器节点资源紧张时调度会提前疏散吗?答案是:默认调度器不会主动把Pod从紧张节点搬走,但它可以通过节点Condition把紧张节点从候选集中排除,让新Pod不再进入。
调度与驱逐的触发边界不同
| 机制 | 触发时机 | 动作对象 | 业务影响 |
|---|---|---|---|
| 提前分流 | 节点负载达到七成到八成水位 | 新创建Pod | 几乎没有影响 |
| 压力驱逐 | 节点资源即将耗尽 | 运行中Pod | 容器被终止,请求中断 |
| 主动疏散 | 水位超过软阈值,且策略允许 | 可迁移的Pod | 可能有短暂抖动 |
从表中可以看出,提前分流对新业务无感,而驱逐和疏散都会影响存量业务,合理的顺序应该是:
- 先做调度分流,降低新Pod进入紧张节点的概率。
- 再做主动疏散,把低优先级Pod从热点节点逐步迁走。
- 最后才让系统压力驱逐兜底。
如何配置压力驱逐与调度避让的联动
kubelet的驱逐阈值可以控制节点什么时候触发压力条件,可以设置当节点内存可用量持续低于一定数值时,节点进入MemoryPressure状态。
evictionHard.memory.available设置为低于数百MiB时触发驱逐。evictionSoft.memory.available设置为更高的软阈值,并配合宽限期,提前让节点进入压力状态。- 调度器默认会过滤带有MemoryPressure、DiskPressure条件的节点。
但仅依赖默认Condition还不够,因为Condition触发时,节点已经接近极限,更优做法是把调度打分阈值设置得比驱逐阈值更严格,让调度先避让,而不是等驱逐兜底。
提前疏散的适用场景
提前疏散不是所有Pod都适合做,尤其涉及有状态服务、本地存储或长连接业务的Pod,要谨慎迁移。
适合提前疏散的Pod类型:
- 无状态Web服务,副本数充足。
- 批处理任务,允许中断后重跑。
- 开发测试环境Pod,优先级较低。
- 已配置PodDisruptionBudget且预算充足的Deployment。
不适合提前疏散的Pod类型:
- 数据库、消息队列等有状态核心组件。
- 使用本地盘或GPU绑定的工作负载。
- 单个副本且无法容忍中断的Pod。
华东和华南节点流量对比下的提前分流策略
多地域部署时,不同地域节点的流量高峰并不完全同步。华东和华南节点流量对比常被用来分析如何设置差异化调度阈值,核心认知是:同一个水位标准,在不同地域可能产生完全不同的效果。
地域差异对调度水位的影响
- 华东节点接入的客户端来源偏集中,晚高峰可能更明显,但夜间回落也快。
- 华南节点如果承载较多游戏、直播类业务,突发流量可能更尖锐,水位波动更大。
- 跨地域集群中,不同区域的节点规格、计费模式也可能不同,导致节点成本存在差异。
提前分流的阈值不能全集群一刀切,更适合的方式是:
- 按地域给节点打标签,例如
topology.kubernetes.io/region=east或south。 - 调度打分插件根据标签读取对应地域的水位阈值。
- 对流量高峰更尖锐的地域,将分流触发水位适当调低。
- 对资源成本更高的地域,可以稍微提高水位容忍度,避免过早扩容。
地域差异化阈值的实操步骤
以下是一个可按地域调整调度阈值的简化操作路径:
- 用
kubectl label node <node-name> region=east给目标节点打标签。 - 在调度器配置中维护一个区域阈值表,例如
east:cpu=70%,memory=65%,south:cpu=75%,memory=70%。 - Score插件读取Pod请求的节点地域后,匹配对应阈值并打分。
- 监控不同地域节点的真实负载与调度成功率,逐步调整阈值。
这样做的好处是,华东和华南节点流量对比不再是经验判断,而变成调度策略的一部分。
集群节点调度成本优化:提前分流会不会更烧钱
提前分流的另一个顾虑是:如果节点还没打满就让新Pod避开,会不会造成节点资源闲置,进而增加集群节点数量?
实际情况恰恰相反。集群节点调度成本优化
的核心不是把所有节点用到极限,而是减少紧急扩容和热点故障带来的额外成本。
被动扩容与提前分流的成本差异
| 成本类型 | 被动扩容 | 提前分流 |
|---|---|---|
| 节点峰值利用率 | 经常打满 | 保持在七成到八成 |
| 紧急扩容频率 | 高,需要快速拉起新节点 | 低,计划性扩容为主 |
| Pod驱逐导致的重试 | 多,业务受影响 | 几乎没有 |
| 容量规划难度 | 高,依赖经验估算 | 较低,水位数据更透明 |
从成本角度看,提前分流虽然可能让单节点利用率略微下降,但换来的是更少的紧急扩容、更少的业务中断和更平稳的集群水位。
节点资源预留多少合适
预留资源过少,节点容易在高峰被打满;预留过多,节点成本又会明显上升。
可按业务等级做预留:
- 核心在线业务节点:CPU预留三成左右,内存预留两成到三成。
- 一般在线业务节点:CPU预留两成左右,内存预留一成到两成。
- 批处理或低优先级节点:可接近打满,但需配合调度抢占和优先级控制。
- GPU或高性能计算节点:预留比例可适当降低,但需监控显存和功耗。
这些数值并非固定标准,而是要根据集群实际水位和业务容忍度调整,节点资源预留本质上是在“稳定性”和“成本”之间找一条可以灰度调整的线。
调度提前分流不是一套神秘算法,而是把节点水位、调度打分、地域差异和成本约束放进同一条决策链路,越早把“打满”从结果变量改成前置条件,集群越不容易被个别热点节点拖垮。
Q&A:节点被打满之前调度能否提前分流
节点被打满之前调度能提前分流吗
可以,通过把节点实时CPU、内存使用率接入调度打分,节点负载达到七成到八成水位时,调度器就会降低该节点的优先级,让新Pod流向更空闲的节点,这比等节点打满后再驱逐或扩容更平滑。
节点负载过高怎么提前分流而不影响在线业务
优先调整新Pod的调度目标,避免把新流量引入高负载节点,对已运行Pod的主动疏散要设置PodDisruptionBudget,保证核心业务副本数不下降,调度分流本身不触碰存量业务,因此影响极小。
容器节点资源紧张时调度会提前疏散吗
默认调度器不会主动疏散已有Pod,它主要通过节点MemoryPressure、DiskPressure等Condition把紧张节点从候选节点中排除,影响的是新Pod调度,若需主动疏散,要借助Descheduler或自定义控制器,并建议在提前分流之后执行,以减少对业务的影响。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/655565.html