训练数据去重能节省相当一部分存储空间,尤其在图像、视频和日志类数据集上,普遍能省下30%到50%的容量,甚至更高。这并不意味着所有数据都值得去重文本数据重叠率低,而去重算法的选择与计算开销直接影响实际收益,下文将直接拆解“训练数据去重对存储容量的节省”这件事,讲清楚能省多少、怎么省、用什么工具,以及不同场景下的取舍。
训练数据去重到底能省多少存储容量
先给一个直观的参照:在自然语言处理领域,常见的大规模文本语料通常有5%到15%的重复内容,这些重复内容来自网页抓取时的镜像页面、转载文章和文档片段,而图像数据集的情况完全不同,尤其是从网络爬取的图片集,重复率可以超过40%,因为同一张图片会以不同尺寸、水印版本或裁剪形式反复出现,视频数据集更夸张,帧间相似度极高,去重后容量可能缩减到原来的三分之一。


业内专家指出,存储容量节省的实际幅度取决于三个变量:数据本身的冗余度、去重的粒度(文件级、块级还是语义级),以及采用的哈希算法精度,具体到数字,下面这个对照表能帮助你快速预估:
| 数据类型 | 常见重复率区间 | 去重后存储节省幅度 | 备注 |
|---|---|---|---|
| 网页文本语料 | 5% – 15% | 5% – 15% | 需用MinHash或SimHash近似去重 |
| 图像数据集 | 25% – 50% | 25% – 50% | 感知哈希适合处理缩放和加水印的副本 |
| 视频帧数据 | 60% – 80% | 60% – 80% | 结合帧间相似度计算,效果明显 |
| 用户行为日志 | 10% – 20% | 10% – 20% | 精确的MD5去重即可 |
需要明确的是,这个节省不是一次性收益,训练过程中还会产生中间检查点、缓存特征、预处理后的增强数据,这些中间产物的去重空间同样可观,如果之前没有做过任何去重,第一轮清理后存储压力会明显缓解。
为什么很多团队忽略了去重带来的存储收益
原因很现实:模型训练流程中,数据工程师的优先级是数据质量和覆盖度,存储管理员则关注成本,两个角色之间常常存在信息断层,训练数据从采集到进入训练管道,会经历清洗、标注、增强等多个步骤,每一步都可能复制出一份新版本,这些版本之间大量重叠,但没有人会逐字节比对。
另一个常见心态是“怕误删”,担心去重工具把相似但不同的样本删掉,影响模型泛化能力,这种担忧有道理,所以实际项目中更推荐用保守策略先做精确去重,再评估近似去重,精确去重只删除内容完全相同的样本,零误删风险;近似去重则依赖相似度阈值,需要验证对验证集准确率的影响,大多数存储节省恰恰来自精确去重,因为重复样本往往连文件名和路径都不同,但内容完全一样。
训练数据去重的常用方法和实操路径
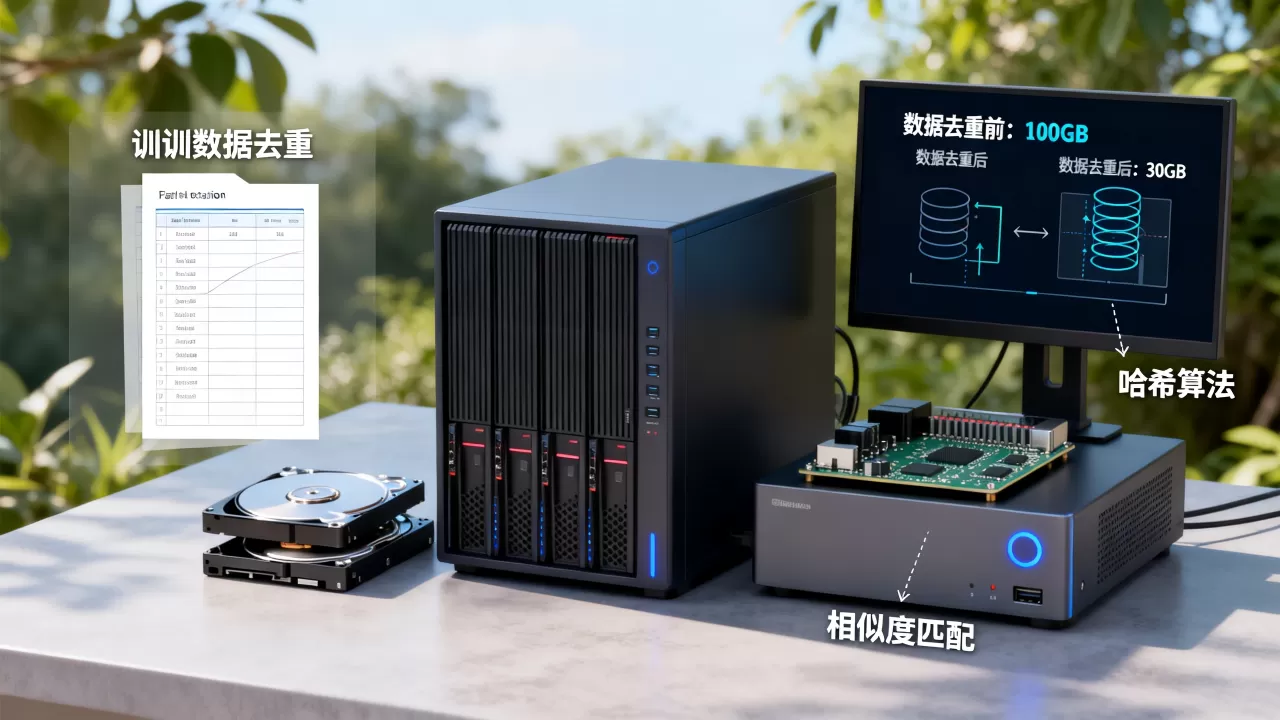
选择去重方法时,要同时考虑数据规模、数据类型和可接受的去重精度,以下按从简单到复杂的顺序排列。
精确去重:最快见效的存储瘦身方式
精确去重适合文本、表格、结构化日志,核心步骤是:
- 对每一条样本计算MD5或SHA-1哈希值。
- 用哈希值建立索引,第一次出现的记下,后续相同哈希值的直接标记为重复。
- 删除重复项后,重新统计各分片的数据量,确认节省效果。
命令行实操示例:在Linux环境下,用fdupes可以扫描目录中的重复文件,对于已经按行存储的文本数据集,用awk或Python的pandas对哈希列去重即可,需要特别注意的是,先排序再比较哈希值能大幅减少内存占用,如果你处理的是TB级数据,建议用RapidCRC或HashCheck这类支持并行计算的工具。
近似去重:识别“改了又没完全改”的数据
精确去重解决不了一些场景:图片被重新压缩、加了一行版权信息、视频被重新编码,此时需要使用感知哈希或MinHash,具体做法是:
- 图片数据:用pHash(感知哈希)提取每张图片的指纹,两两比较汉明距离,小于设定阈值(通常为5到10)则视为重复,实际操作中,先用
ImageHash库生成64位或256位哈希,再通过球树或VP-Tree做最近邻搜索,避免O(n²)的暴力比对。 - 文本数据:先将句子拆分为shingle(连续n个字的组合),再用MinHash计算Jaccard相似度,业界常用的工具是
datasketch库,其MinHashLSH能在海量文本中快速找到相似文档。 - 视频数据:抽帧后按图像哈希处理,同时统计帧间汉明距离的均值,超过阈值就认为两段视频冗余。
近似去重会消耗较多CPU资源,因此需要评估“节省的存储费用”与“新增的计算成本”是否划算,对于小规模数据集(百万样本以下),暴力两两比对反而更简单可靠。
去重算法的对比与选择建议
不同算法在不同场景下的表现差异明显,下表整理了常见的去重算法对比:
| 算法 | 适用数据类型 | 精度 | 速度 | 存储开销 | 典型场景 |
|---|---|---|---|---|---|
| MD5/SHA-1 | 任意类型 | 完全精确 | 极快 | 低 | 文本、日志、文件级去重 |
| SimHash | 长文本 | 近似 | 快 | 低 | 新闻语料、网页文档 |
| MinHash | 文本集合 | 近似 | 中 | 中 | 大规模文本相似度检索 |
| pHash/dHash | 图像 | 近似 | 中 | 低 | 图片去重、盗图识别 |
| 帧间差值 | 视频 | 近似 | 慢 | 高 | 视频帧去重、短视频清洗 |
行业共识认为,没有“最好的去重算法”,只有“当前数据量下最优的方案”,你可以在小规模样本上做一次抽样测试,比较不同算法的查准率和查全率,再决定全量执行。
训练数据去重对存储成本的价格影响
存储成本是训练项目预算里不可忽视的一环,公有云对象存储的价格大约在每GB每月0.12元到0.25元之间(据主流云厂商公开定价),高性能SSD块存储则更贵,假设一个训练数据集原始大小为10TB,按近似30%的去重节省计算,就能释放出3TB容量,一年下来,仅对象存储费用就能减少数千元,如果使用本地数据中心的大容量SATA盘,电费和机柜空间同样能省下一笔。
从项目全周期看,去重不只是省存储本身,还能减少后续环节的隐性成本:
- 数据加载时间缩短,GPU训练时的I/O等待变少。
- 标注费用降低,因为重复样本不需要重复标注。
- 模型迭代速度加快,日志和检查点的版本管理也更清晰。
实际采购时,你可能会遇到“训练数据去重工具价格”这类问题,开源方案完全免费,比如fdupes、rdfind、datasketch,但需要自己写调度脚本;商业方案如ActiveData或云厂商的数据湖分析服务,按扫描数据量计费,单次全量扫描的成本大约在每TB几十元,如果数据量超过数十TB,后者的成本可能反而不如自建离线任务划算,建议先算一笔账:用免费工具做一次精确去重,看节省的容量是否值得投入更多时间去优化。
去重操作中的常见坑与避坑指南
去重看似简单,实际操作很容易踩到几个隐蔽的坑。
哈希碰撞与文件元数据干扰
MD5等哈希算法在百亿级别数据上可能出现碰撞,虽然概率极低,但训练数据量级大时不能完全忽略,稳妥的做法是双哈希校验,即同时计算两种不同哈希值,都一致才判定为重复,文件大小、修改时间等元数据不应该作为去重依据,因为两次拷贝的文件时间戳往往不同。
跨语言编码导致的假重复
同一个中文句子,在UTF-8、GBK、Big5编码下哈希值完全不同,处理前先统一转码为UTF-8,再计算哈希,这一步很容易被忽略,却直接决定去重效果的准确性。
增强数据生成后的去重时序
很多团队会在数据增强后进行去重,这样做会放大存储消耗,正确做法是:先对原始数据去重,再执行增强,最后对增强后的结果做一次轻量级精确去重,因为某些增强操作(如回译、随机裁剪)可能产生与原始数据高度相似的样本,如果不去重,会变相增加训练轮数的时间开销。
在线去重与离线去重的分工
推荐采用两阶段策略:离线阶段做全量去重,生成一个白色名单文件;在线阶段在数据加载管道中,根据样本哈希值直接过滤,这样既能保证最终存储容量最小化,又不会因为实时去重拖慢训练速度。
训练数据去重如何融入现有数据管道
如果你已经有了自己的数据预处理流程,不需要推翻重来,只需在“原始数据收集”和“清洗标注”之间插入一个去重模块,具体操作路径如下:
- 在数据采集端,为每条样本附加一个哈希字段,存入元数据数据库。
- 在清洗阶段,先执行哈希去重,输出重复样本列表。
- 对于近似去重,用Spark或Dask分布式计算,每12小时跑一次增量去重任务。
- 将去重结果写入Parquet格式的分区表,以日期为分区,方便回滚和审计。
这样做的好处是,去重过程完全可追踪,存储节省的数据量可以写入监控报表,管理层能直接看到容量曲线下降。
模型精度会不会因为去重而下降
这是个高频问题,实际项目中,大部分情况下去重不会降低模型精度,反而可能略有提升,原因是重复样本会让模型在训练时对这部分特征过拟合,减弱对稀有模式的泛化能力,图像分类任务中,去除重复图片后,若验证集精度无明显变化,则说明这些重复数据本来就是多余的,如果使用近似去重,建议保留一个去重前的备份,用于A/B对比。
Q&A:关于训练数据去重与存储节省的常见疑问
问题:训练数据去重到底适合哪些项目?成本高不高?
适合数据量达到TB级别、数据来源杂(网页爬虫、多份备份、多人标注)的AI项目,成本方面,使用开源工具进行精确去重几乎为零额外成本;如果使用商业数据管理平台,费用可能占总体存储预算的5%左右,建议先用免费方案试跑一次。
问题:去重后的数据万一发现误删了,还有办法恢复吗?
有,常规做法是将去重操作设计为“软删除”:被标记为重复的样本先移动到隔离区,保留至少一周,确认训练任务正常后再物理删除,同时记录每一条删除记录的哈希值和来源文件路径,便于定向回滚,另一个办法是对原始存储做快照,去重任务执行前生成一次快照,恢复成本远比重新爬取数据低。
问题:我用的是开源大模型微调框架,训练数据去重对存储容量的节省效果明显吗?
多数开源框架自带的数据处理脚本只做基础清洗,不会主动去重,如果你从HuggingFace或ModelScope下载的公开数据集本身已经过上游去重,节省空间有限;但如果混入了私有数据,重复率往往很高,实际操作中,先对你的数据集跑一次哈希统计,就能看到精确重复样本的占比,再决定是否引入MinHash做语义级去重,最终存储节省量完全取决于数据的冗余程度,而不是框架本身。
回到最初的话题:训练数据去重不是一项锦上添花的工作,而是数据工程中直接对应存储账单的关键步骤,只要数据源不是单一的、完全干净的,去重就值得做,优先做精确去重,拿到初始节省数据后,再评估是否值得投入算力去做近似去重,这既保证了模型数据质量,也让每一份存储空间都花在刀刃上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623337.html