请求头校验的本质
识别并拦截伪造流量,不能单看某一个请求头字段的值,而是要校验字段之间的逻辑自洽性、行为一致性,再配合服务器端的主动探测策略。仅靠比对User-Agent字符串是否包含“bot”或封禁可疑IP,已经是2026年以前的老办法了,真正的请求头校验,是围绕HTTP协议特征做一次“身份追问”。
为什么传统请求头拦截策略失效了
很多站长遇到网站被刷流量、接口被恶意调用的情况,第一反应是封IP、封UA,但在当前的攻防环境下,伪造成本极低,攻击者通过curl、Python脚本或开源压测工具就能轻松构造任意请求头。
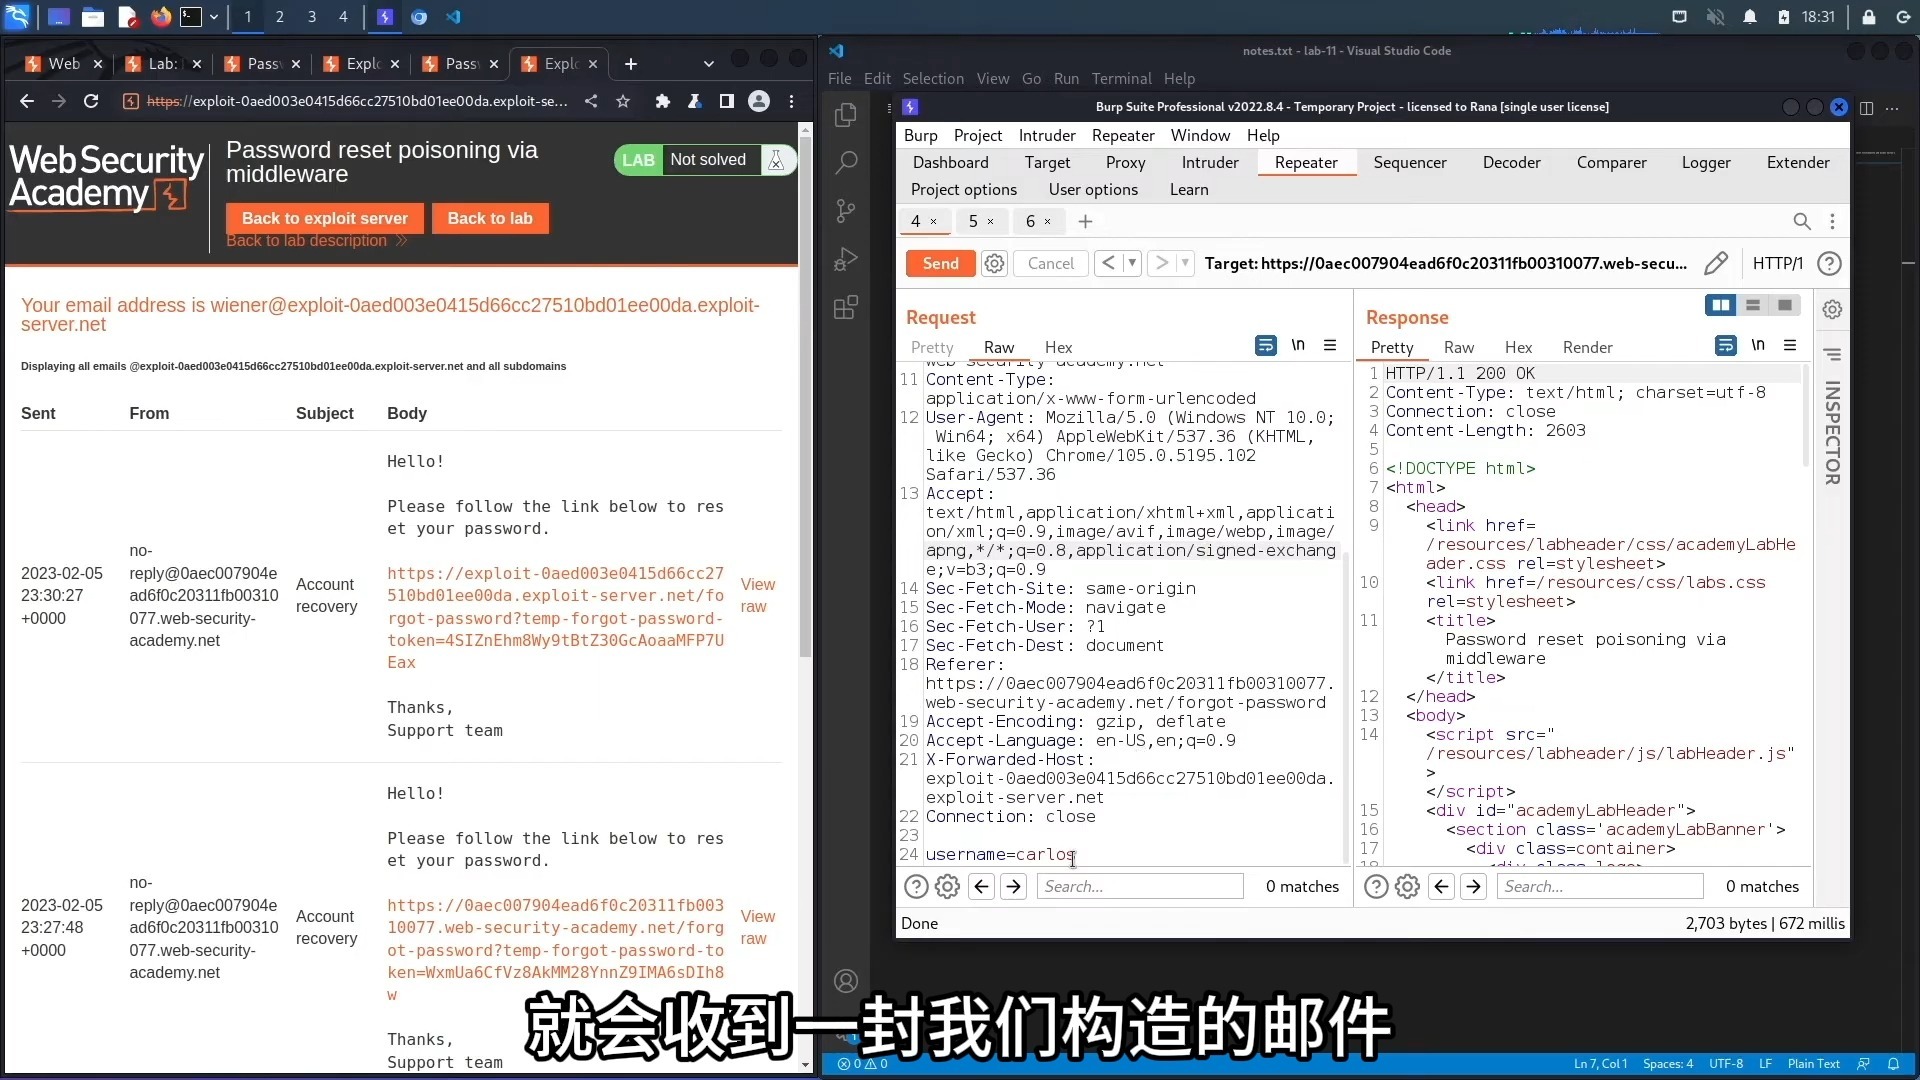
- curl命令可随意指定UA、Referer、X-Forwarded-For字段。
- 开源工具如HTTPie、Gatling提供参数化请求头模板。
- 大量“秒拨IP池”让封IP策略形同虚设。
行业共识认为:仅依赖单一请求头字段做黑白名单判断,误杀率高且无法防住有组织的伪造流量。你会看到很多真实流量被拦截,但恶意请求依然穿透防线。
核心校验策略:从单点走向多维
要精准识别伪造流量,关键是掌握请求头的“内在逻辑”。
字段缺失与冲突检测
真实浏览器的请求头有固定发送顺序和必填字段,脚本伪造的请求头往往有“营养不良”的问题。
- 检测必需字段是否缺失:现代浏览器必带Accept、Accept-Language、Accept-Encoding、User-Agent,缺任一字段,极大可能是脚本。
- 检测字段值冲突:UA为最新版Chrome,但Accept-Language却缺失zh-CN或en-US的优先权重;Referer是站内链接,但Sec-Fetch-Site却是cross-site,这些冲突是伪造流量的致命弱点。
- 检测HTTP版本与头字段的匹配度:HTTP/1.1请求却带上了HTTP/2专属的伪头字段(如:authority),一眼假。
请求头强度校验的实操路线
在Nginx层,可以通过一段简单的配置实现基础冲突检测。
# 拦截缺失Accept-Language的请求
if ($http_accept_language = "") {
    return 403;
}
# 构造扭曲UA组合,精准拦截
if ($http_user_agent ~ "python|curl|wget") {
    return 403;
}
但这只是开胃菜,更有效的是利用Nginx的map指令,将多个请求头组合成指纹串,再做规则匹配。
map $http_user_agent $device_browser {
    ~chrome chrome;
    ~firefox firefox;
    default other;
}
map $http_accept $is_html {
    ~text/html 1;
    default 0;
}
# 当浏览器指纹为chrome,但Accept不支持HTML时,判定异常
if ($device_browser = chrome) {
    if ($is_html = 0) {
        return 403;
    }
}
这套逻辑解决的是“身份指鹿为马”的问题。
进阶防线:TLS与HTTP/2指纹识别
基础请求头校验可以做逻辑校验,但TLS指纹和HTTP/2指纹是针对伪造流量的降维打击。
为什么请求头校验需要结合TLS指纹
即便是最严谨的请求头逻辑,也能被精良的脚本模拟,但请求头是在TCP三次握手之后发送的,而TLS握手发生在HTTP请求之前,每个客户端操作系统、浏览器版本、补丁级别,都会在ClientHello报文中留下独特特征,即JA3/JA4指纹。
- 正常浏览器的JA3指纹是高度统一的。
- Python的requests库或curl工具生成的TLS指纹,与主流浏览器完全不同。
- 伪造者很难修改底层TLS库去模仿浏览器的ClientHello行为。
开源方案的限制与应对
业内专家指出,目前开源界最常用的方案是JARM指纹工具和nginx-http-ja4-digest模块,它们能将TLS指纹计算成哈希值,并纳入请求头校验体系。
真实操作路径:
- 开启TLS指纹计算模块,记录每个请求的JA4哈希。
- 对比主流Chrome和Safari浏览器的指纹库,生成白名单哈希。
- 当请求的UA声称是Chrome 125,但JA4指纹对应的是Python httpx库时,直接拦截。
这套方案能过滤掉较大比例的恶意扫描和刷量行为,但它的短板在于:攻击者一旦发现指纹被统计,也会转向使用真实浏览器内核(如Headless Chrome)来制作流量,这也是后续防护需要持续演化的问题。
场景化校验:请求头与行为模式结合
识别秒拨IP与数据中心IP流量
请求头中的X-Forwarded-For经常被伪造,但TCP连接的真实来源IP仍可从$remote_addr读取,对于高防御需求的场景,建议直接禁用对X-Forwarded-For的信任,转而从云服务商获取真实IP。
- 对于IP,建议比对ASN归属,普通住宅宽带用户绝不会从中大型云厂商的IP段(ASN标定为DIGITALOCEAN、ALIBABA等)发起正常访问。
- 配合MaxMind GEOIP2数据库,在Nginx层级拒绝对应数据中心IP段。
基于时间戳的请求头一致性校验
伪造流量普遍缺乏“耐心”,真实用户从输入网址到发起请求,中间需要加载HTML、CSS、JS,通常间隔数十到数百毫秒不等。
- 通过Nginx的$request_time变量配合Cookie中的_timestamp,计算请求时间差。
- 在第一响应中内部设置含有时间戳的Cookie值。
- 当第二次请求携带的Cookie_timestamp与服务器收到请求的时间差不足均少于50毫秒时,判定为脚本高速请求。
借用这种模式,可将校验逻辑从静态头字段升级为动态会话追踪。
Q&A环节:高频关注的实战问题
问题1:Nginx层面做请求头校验,会影响网站百度收录吗?
百度spider(百度爬虫)拥有非常明显的User-Agent,且其请求头中Accept-Language、Accept字段非常稳定,不会触发冲突规则,百度搜索资源平台提供“抓取诊断”工具,你可以观察百度爬虫抓取是否遇阻。
问题2:哪些场景下的请求头校验,适合放到CDN而不是源站?
大量CC攻击尚未到达源站,就在CDN边缘节点消耗带宽和连接数,凡是需要拦截大流量DDoS的场景,建议在CDN的WAF(Web应用防火墙)规则中设置请求头校验策略,从而就近丢弃恶意数据包。
问题3:如何处理移动端App的URL请求,避免误杀?
App请求不走浏览器栈,天然缺少Sec-Fetch-头或Accept字段,应对方案是单独划分App专用的URI前缀,在Nginx中对该前缀略微放宽请求头校验强度,改用API Token校验和签名防伪机制加固。
动态令牌方案:从请求头校验升级为私有协议
纯粹的请求头校验永远有一个瓶颈:请求头本身可以被任意客户端构造,如果你的业务面临持续的高级伪造流量,最终方案一定是“挑战-应答”动态令牌机制。
向真实用户动态下发校验Cookie
第一次访问时不直接返回页面数据,而是返回一段JavaScript计算脚本,用于完成动态计算并设置Cookie字段,由于恶意脚本通常不具备JS渲染引擎,该方案能拦截大部分非浏览器脚本流量。
# 通过Nginx的auth_request模块,先验证动态cookie是否存在
location /api/ {
    auth_request /check_token;
    proxy_pass http://backend;
}
location = /check_token {
    internal;
    if ($cookie_dynamic_token = "") {
        return 403;
    }
    # 此处可对接Redis校验token合法性
    proxy_pass http://auth_server;
}
私有请求头字段作为第二道认证
- 在前端JS、客户端SDK中写入自定义Header字段,比如X-Client-Sign。
- 签名规则:将时间戳、URI路径、随机数做HMAC-SHA256加密后,附带在请求头中。
- 后端网关校验签名是否过期、随机数是否重复使用。
该方案确实能极大提高伪造成本,但真实用户在首次访问时会感觉加载时间变长,对于高并发门户站点建议仅对登录、支付等敏感接口启用。
维护黑名单库与智能学习机制
在持续对抗中,基于请求头指纹的静态黑名单已精确到“指纹级”,允许管理员手动标记某类异常指纹,同时接入日志分析系统,自动聚合高频异常头组合,系统对疑似伪造流量仅返回503状态码,并给予短暂的浏览器挑战。
请求头校验的目标并非追求单点的绝对安全,而是构建多道递进的验证防线。从字段逻辑自洽到TLS指纹匹配,再到动态令牌,这三道关卡环环相扣,足以拦截各层级伪造流量。攻击者永远在模仿真实身份,而校验逻辑的核心始终只有一个:比攻击者更了解真实的访问,究竟是何种模样。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/634402.html