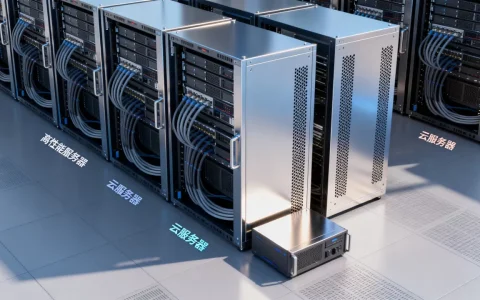
渲染农场、渲染集群、计算农场、GPU云服务器、分布式渲染节点,这些都是指同一类设备。不同岗位、不同场景的人叫法完全不同,工程部叫它”渲染节点”,制片人叫它”渲染农场”,云厂商则直接叫”云渲染服务器”,这些别称背后对应着不同的硬件形态、部署方式和计费逻辑,搞清楚它们才能在同行的交流中不蒙圈。
渲染服务器六大别称,你听过几个
渲染农场(Render Farm):最老派也最形象的叫法
这个称呼源自传统影视动画行业,早期一部动画电影需要渲染数万帧画面,单台机器要算几个月,于是机房被塞满了几十台甚至几百台主机,像农场里密集排列的庄稼一样”成片生长”,业内专家指出,直到今天,国内一线动画公司内部沟通时依然习惯把渲染任务称为”扔进农场跑一跑”。
这个别称强调的是规模感和批处理属性,如果你听到有人说”农场在跑任务”,指的就是渲染服务器集群正在批量出图,而不是真的有农业设备。
渲染集群(Render Cluster):技术文档里的官方叫法
“集群”这个词更强调技术形态多台服务器通过网络互联,由调度软件统一分配任务,程序员和运维人员偏好这个称呼,因为它准确描述了系统架构,在技术方案和采购合同里,你大概率看到的是”渲染集群”,而不是”渲染农场”。
行业共识认为,集群叫法更严谨,农场叫法更口语,两者指的是同一批设备,只是描述角度不同。
计算农场(Compute Farm):泛化后的别称
有些做通用高性能计算的团队会把渲染服务器叫成计算农场,因为除了渲染,这些机器还能跑物理仿真、流体模拟甚至AI训练,这个称呼弱化了”渲染”这个垂直功能,强调的是算力复用,如果你在一家做视效的同时也做深度学习业务的公司,你会发现机房里同一批机器今天跑渲染、明天训模型,”计算农场”这个名字确实更准确。
GPU云服务器(GPU Cloud Server):云厂商的营销词
现在绝大多数云平台都把渲染服务器包装成”GPU云服务器”对外售卖,这名字重点突出GPU型号和显存大小,A100云服务器””RTX 4090云服务器”,云厂商这么叫是为了和普通CPU服务器做区分,方便用户按显卡选型。
分布式渲染节点(Distributed Render Node):架构师的称呼
在讨论多机协同渲染架构时,工程师会说”我们有200个渲染节点”,这相当于把每台服务器拆开命名单个节点就是一台独立的渲染服务器,节点之间通过网络通信,这个别称出现频率很高,尤其是在讨论任务调度、网络带宽、存储共享这些底层问题时。
图形渲染服务器(Graphics Render Server):传统硬件商的叫法
一些老牌服务器品牌如惠普、联想的早期产品线里,”图形服务器”或”图形渲染服务器”是正式商品名,这类机器会配一块专业显卡(如NVIDIA Quadro系列),现在慢慢被游戏卡和工作站替代,但名字留了下来。
渲染服务器和普通服务器区别,别再叫错
很多人分不清楚渲染服务器和普通Web服务器到底差在哪,甚至出现过买了一大堆CPU服务器做渲染结果效率极低的案例,要区分两者,从下面三个角度看。
算力侧重完全不同
普通服务器面向高并发请求,重视CPU多核心和网络I/O,比如跑数据库、跑网站,渲染服务器则面向单帧密集型计算,现代渲染引擎(如V-Ray、Octane、Redshift)几乎都依赖GPU的CUDA核心并行计算,CPU反而成了辅助角色。
硬件配置差异非常明显
普通服务器的标配是双路CPU、大内存、万兆网卡,不需要好显卡。 渲染服务器的标配则是单路或双路CPU加一到四块显卡,散热方案要专门设计,PCIe通道数要足够,电源功率动辄2000W以上,下表可以直观看出核心差异:
| 配置项 | 普通服务器 | 渲染服务器 |
|---|---|---|
| GPU配置 | 无或亮机卡 | 1-4块高性能显卡 |
| CPU要求 | 高主频多核心 | 中等即可,显卡决定速度 |
| 内存 | 大容量ECC内存 | 一般或超大显存优先 |
| 网络 | 万兆起步 | 万兆起步或InfiniBand |
| 散热 | 风冷为主 | 风冷或水冷,高功耗设计 |
| 典型功耗 | 300-600W | 1000-3000W+ |
软件栈与优化方向不同
普通服务器跑的是Windows Server或Linux发行版,安装Nginx、Tomcat这类服务软件,渲染服务器则要装显卡驱动、渲染器插件、任务调度客户端(如Deadline、Royal Render),有些渲染农场甚至直接装Windows 10工作站版就是因为渲染器对驱动支持更友好。
按场景叫法有讲究,别闹笑话
影视动画圈:渲染农场是唯一指定叫法
在影视公司,”渲染农场”几乎等同于渲染服务器的代名词,你如果跟一位动画制片说”你们的GPU云服务器跑完了吗”,对方大概率会愣住;但你说”农场今天出了多少帧”,他马上能反应过来,国内知名的CG社区和制作公司,如Base FX、More VFX的内部工作流里,”农场”已经是行业黑话。
建筑可视化圈:直接叫”渲染服务器”
做效果图的工作室通常只有几台机器,他们习惯直接说”渲染服务器”或者干脆叫”出图机器”,这类用户更关心每张图的渲染时长,对集群调度没什么概念。常州渲染服务器这类地域词的搜索量并不低,说明大量做建筑可视化的个人和工作室在本地找设备或云资源,他们搜索习惯就是”城市名+渲染服务器”。
游戏开发圈:GPU服务器或云渲染
游戏开发团队做光照烘焙、视频预渲染时,更倾向于把设备叫成”GPU服务器”,因为游戏引擎(如虚幻引擎、Unity)的渲染管线已经和GPU绑定,团队选型时会直接说”我们需要几台支持RTX的GPU服务器跑光照烘焙”,在云平台上,这类需求直接对应”云渲染服务器”的实例类型。
渲染服务器多少钱一台,价格逻辑说清楚
这是搜”渲染服务器”的人最常问的问题,但答案没法给死,一台渲染服务器价格从两三万到二十万以上都正常,核心变量就是显卡数量与型号。
一台单卡RTX 4090级别的渲染服务器,品牌整机价格大致在4到8万元区间;四卡A6000级别的工作站则要到15到25万元。 如果你去电商平台搜索,会发现DIY组装的单卡渲染主机可能低至2.5万元,但机架式服务器(含冗余电源、IPMI管理模块)就要贵得多。
云渲染按小时计费的模式也在改变价格认知,以公有云GPU实例为例,单卡V100的按量价格大约每小时十几元,一张效果图的渲染成本可能就几块钱,但长期跑大项目,云成本会超过自购设备,这时候很多团队会算一笔账。
云渲染服务器怎么选,看这五个指标
既然”云渲染”是当下最普及的形态,那选择时怎么不踩坑?这五个指标覆盖了绝大多数决策因素。
GPU型号与显存:决定渲染速度的根
不同渲染器对显卡的利用效率差别很大,V-Ray GPU版在NVIDIA显卡上优化最好;Octane只支持NVIDIA显卡;Redshift虽然跨厂商,但NVIDIA生态最成熟。选型第一原则是:你的渲染器支持哪家的显卡,就选哪家的云实例。
显存大小直接决定你能否渲染大场景,8GB显存跑1080p的复杂场景勉强够用,4K场景至少需要16GB以上显存,如果你做建筑漫游动画推荐直接选24GB显存的型号。
CPU与内存配置不能缩水
GPU渲染时CPU主要负责几何处理和驱动,频率比核心数更重要,内存建议搭配32GB起步,处理大场景的拓扑数据时64GB也不嫌多,云服务器选型时别只看GPU参数,CPU和内存规格也要匹配。
存储与网络延迟
云渲染服务器通常需要挂载共享存储(如NAS或并行文件系统),因为渲染节点要读取贴图、输出序列帧。选云服务商时问清楚存储IOPS和吞吐量,这决定了场景加载和文件保存的速度。 网络方面,万兆内网是标配,否则多机协同传输资产时会卡很久。
计费方式要匹配项目节奏
云渲染的计费方式通常有三种:按量计费、包周包月、竞价实例。按量适合临时补渲;包月适合长期项目;竞价实例适合不赶时间且任务可中断的渲染,价格能便宜一大截。 很多云厂商还有”渲染专用集群”套餐,包含调度软件授权,省去自己搭建Deadline的麻烦。
服务商的任务调度能力
真正专业的云渲染服务商会提供现成的调度平台,你只需要上传工程文件就能自动拆分帧任务、批量渲染、自动回传,瑞云渲染、炫云这类垂直服务商走的就是这条路,如果你的团队没有专门的TD(技术指导)维护,建议优先选带调度平台的一站式服务。
常见疑问解答
渲染服务器是什么?和GPU服务器是一回事吗?
渲染服务器是指专门用于3D图形渲染、视频特效合成、动画帧计算的高性能服务器,它和GPU服务器在硬件上高度重合,但概念不完全一样:GPU服务器还包括用于AI训练、科学计算的机型,而渲染服务器更偏向图形输出场景,实际采购时,GPU云服务器通常可以用来做渲染,但如果跑AI推理,显存和带宽的调优方向会不同。
自建渲染农场和租用云渲染,哪种更划算?
如果渲染任务稳定且密集(比如每周都有固定出片量),自建农场的长期成本更低,因为硬件是一次性投入,三年摊销后每小时成本只有云的几分之一,但如果项目波动大、峰值需求猛增,云渲染的弹性更划算不需要为了一个月的量产项目买几十台机器吃灰,多数中型公司选择”自建小集群+高峰期上云”的混合模式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784060.html