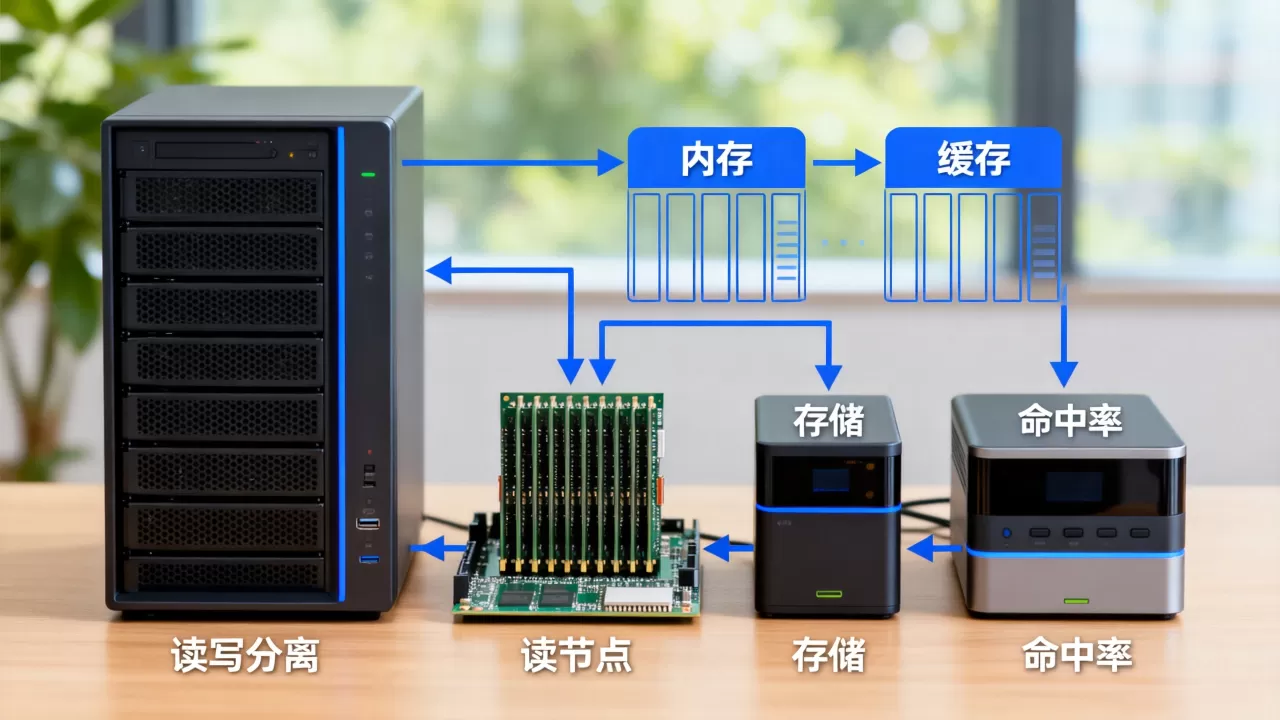
读写分离部署中,读节点的性能瓶颈几乎总是出现在内存容量和缓存命中率上,而不是CPU或磁盘吞吐。写节点靠磁盘落盘保证数据持久化,读节点则靠内存和缓存扛住高并发查询,命中率一旦下滑,响应时间会成倍恶化。
为什么读节点的命脉是内存,不是磁盘
读写分离的核心思路是把写压力集中在主库,把读流量分散到从库,但很多团队在扩容读节点时,第一反应是加CPU核数或换更快的SSD,忽略了内存规划,这个思路在数据量小的时候看不出问题,一旦缓存装不下热数据,故障就会以最难看的方式暴露。

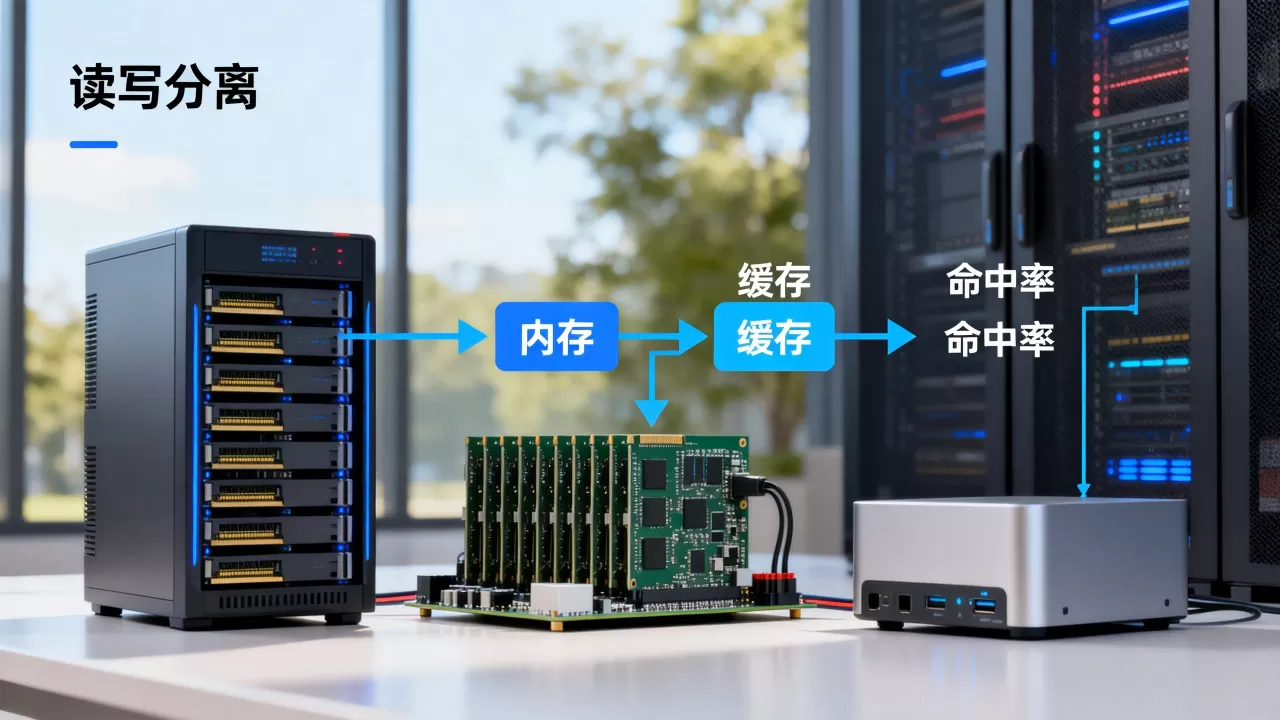
写节点是”落盘优先”,读节点是”命中优先”
主库处理写入时,核心动作是写binlog、刷redo log、更新数据文件,这些操作最终都要落到磁盘上,磁盘顺序写性能尚可,随机写才是灾难,但从库的职责完全不同,它接收的绝大多数请求是查询,而查询最快的路径不是去磁盘找数据,而是直接从内存拿结果。
MySQL的InnoDB缓冲池、Redis的键空间、Elasticsearch的页缓存,这些机制存在的唯一目的就是把热数据留在内存里,读节点一旦发生缓存淘汰,每一次未命中都要穿透到磁盘,这意味着随机I/O,而随机I/O的延迟是内存访问的几十倍甚至上百倍。
连接数和临时结果集是隐藏的内存杀手
读节点承接的连接数通常远高于写节点,一个典型的业务场景是:应用层做了读写分离,十个应用实例共用两个读节点,每个实例维护几十个连接池,这些连接本身不占太多内存,但每个连接都可能带回一个结果集。
更隐蔽的是排序和分组操作。ORDER BY、GROUP BY、DISTINCT如果无法在索引内完成,MySQL会在内存中创建临时表,一张百万行的临时表,按每行几百字节计算,轻松吃掉几百MB内存,多个查询并发时,内存瞬间触顶。
读节点缓存命中率低怎么办:先算清这笔账
缓存命中率是一个读节点健康状况的核心指标,很多人盯着CPU使用率和磁盘I/O,却忽略了一个事实:CPU飙升往往是命中率下降的结果,而不是原因。
命中率的分母和分子各代表什么
以MySQL InnoDB为例,命中率的计算口径是:
命中率 = 缓冲池读取次数 / (缓冲池读取次数 + 磁盘读取次数)这个指标可以通过
SHOW GLOBAL STATUS查看到Innodb_buffer_pool_read_requests和Innodb_buffer_pool_reads两个计数器的值,前者是逻辑读总数,后者是落到磁盘的物理读总数,两者相减再除以逻辑读,就是缓冲池命中率。
命中率多高才算健康
行业共识是:读节点的命中率应稳定在95%以上,低于90%意味着有大量查询在穿透缓存,高于99%则说明内存大概率存在冗余,具体到不同存储引擎和缓存组件,标准略有差异:
- MySQL InnoDB缓冲池命中率,建议不低于95%
- Redis所有操作都走内存,命中率不是核心指标,内存淘汰策略才是关注重点
- Elasticsearch的页缓存命中率,建议不低于90%
这些数字不是拍脑袋定的,而是基于缓存局部性原理和大量生产环境的经验值,如果你发现命中率长期趴在80%附近,加CPU没有任何意义,问题出在内存装不下工作集。
怎么定位哪些查询在拖累命中率
不要靠猜,打开慢查询日志和性能分析工具。
步骤一,开启慢查询日志:
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 1;
步骤二,查看performance_schema中的表扫描统计,找出全表扫描的查询,全表扫描是缓存命中率的头号杀手,因为它会把整张表的数据页读入缓冲池,把原本适合缓存的热数据页挤出去。
步骤三,用EXPLAIN分析这些查询的执行计划,重点看type字段,如果是ALL或者index,说明没有走索引,需要优化SQL或添加索引。
读写分离性能上不去,内存配置的三个常见误区
InnoDB缓冲池设置成物理内存的50%就够了
这是最危险的说法,缓冲池的大小取决于两个因素:热数据的总量和总内存的余量,热数据总量可以通过查看information_schema.tables统计每张表的索引和行数估算。
如果物理内存是64GB,热数据有80GB,那么50%即32GB的缓冲池显然装不下,合理做法是预留操作系统和其他进程所需的内存后,尽量把剩余内存给缓冲池,MySQL官方建议InnoDB缓冲池设为物理内存的70%-80%,但前提是这台机器专门跑MySQL。
读节点如果是独立部署,可以考虑把innodb_buffer_pool_size提高到物理内存的75%左右,还要注意开启
innodb_buffer_pool_instances,用多个实例减少内部锁竞争。
Redis只用来做分布式缓存,部署随意
读写分离架构中,Redis通常承担两件事:一是为应用层提供热数据缓存,二是缓解MySQL读节点的压力,但Redis本身的内存规划直接决定了MySQL缓存的压力。
如果Redis设置了maxmemory,并且淘汰策略是allkeys-lru,那么当内存写满时,最久没被访问的key会被淘汰。这会造成缓存雪崩的隐患,而且Redis的逐出节奏和业务访问模式错位时,MySQL读节点的命中率会被瞬间拉低。
更稳妥的做法是给Redis分配足够内存,让热数据完整驻留,还需要监控evicted_keys指标,这个指标如果持续增长,说明Redis内存不够用了,需要扩容而不是优化业务。
启用查询缓存就能解决命中率问题
MySQL 8.0已经移除了查询缓存功能,原因在于它适合读多写少的场景,但更新频繁的表会让查询缓存频繁失效。缓存失效的开销远大于缓存命中的收益,这是业界公认的结论,如果你还在用MySQL 5.7及以下版本,建议直接关闭query_cache_type。
读节点内存规划的实操步骤
以一套标准的电商订单同步系统为例,主库写入订单,两个从库承接查询,热数据集中在最近三个月的订单上,历史数据归档到冷存储,那么读节点的内存规划按以下步骤执行:
- 第一步,盘点工作集大小,用
SELECT COUNT()结合平均行长度估算最近三个月的订单数据量,假设有2000万行,平均每行500字节,加上索引占用,工作集约15GB。 - 第二步,按工作集的5倍到2倍规划内存,缓冲池至少30GB,留出操作系统、连接线程、排序缓冲区的余量,物理内存选择64GB。
- 第三步,测试不同缓冲池大小下的命中率,先用
innodb_buffer_pool_size=32G跑一周,观察Innodb_buffer_pool_reads的变化趋势,如果命中率稳定,再考虑是否调优。 - 第四步,配置监控告警,对
Innodb_buffer_pool_reads和磁盘I/O的await指标设置阈值,当磁盘读次数持续上升或响应时间超过200ms时触发告警。
冷热分离比单纯加内存更有效
内存再大也是有限的,读节点更依赖内存但不可能无限堆内存,一个务实的方向是把数据按热度分层:线上库只保留近期数据,历史数据迁移到归档库或对象存储,这样热数据规模被压缩,内存命中率自然就上去了。
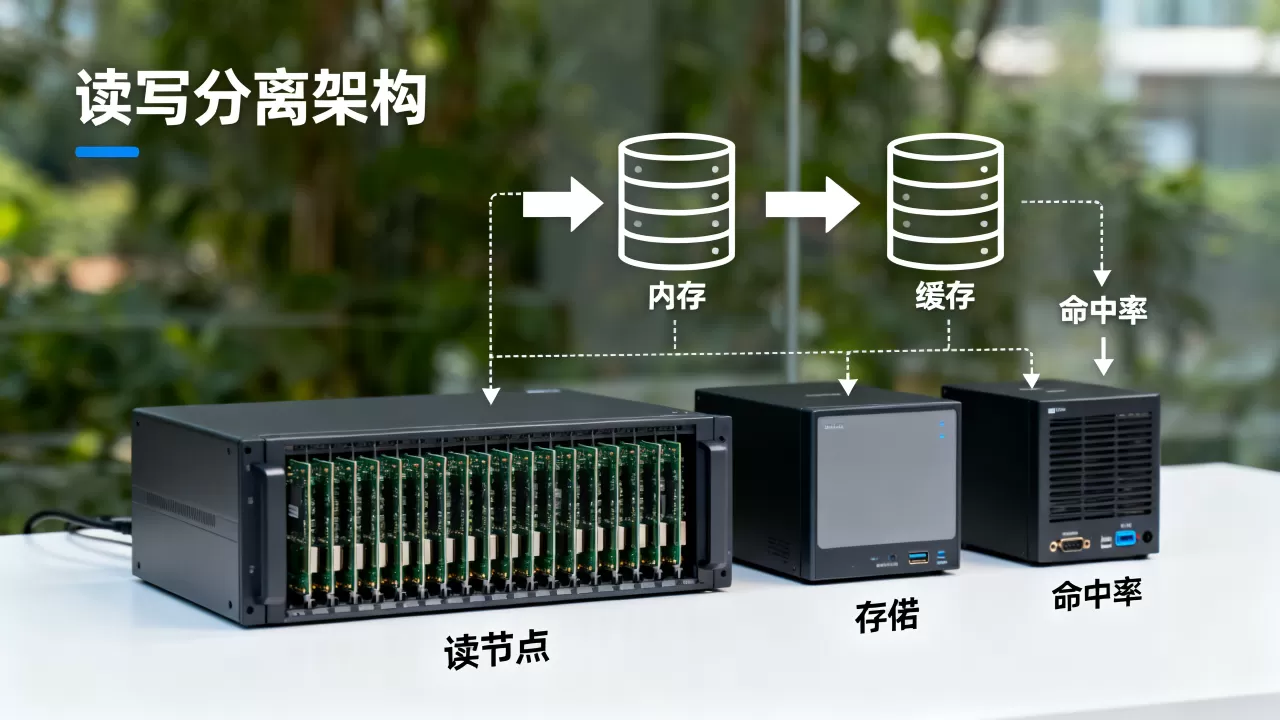
不少团队遇到读写分离性能上不去的问题,方案都是给读库加内存,但加完发现效果不明显,原因很可能是缓存里塞了太多冷数据,把热数据挤出去了,比较合理的做法是在应用层做两级缓存:本地缓存命中高频热点key,Redis兜底次热点,MySQL读节点只接收无法缓存的查询。
观察内存命中率时的系统负载视角
不要单独看某一个指标,内存命中率下降时,磁盘I/O的util会同步抬高,但util达到100%不代表磁盘满了,也可能只是产生了大量随机读,此时应该先看iostat的r/s和await,如果每秒读请求数很高且延迟大,基本可以判定是缓存穿透。
还要看CPU的sys和wa。wa过高说明大量进程在等待磁盘I/O完成,CPU无事可做,这个状态下的CPU使用率虚低,容易被误判为系统空闲。
读节点缓存命中率相关Q&A
读库的内存和缓存一般怎么配比
读库内存规划以热数据工作集为准,先把业务查询涉及的表和索引加起来,估算出活跃数据总量,然后给MySQL缓冲池分配工作集大小的5倍以上,如果部署Redis作为前置缓存,Redis内存按热数据总量的一半起步,后续根据命中率调整。
为什么读写分离后从库的查询还是慢
从库查询慢的根源大概率不在SQL,而在缓存未命中,建议先查从库的Innodb_buffer_pool_reads,如果这个值在持续增长,说明缓冲池有效容量不足,其次查慢查询日志,看是否存在扫描行数远超返回行数的SQL,最后检查从库的复制状态,如果Seconds_Behind_Master持续大于0,说明从库可能在用单线程复制追赶主库的大事务,这个与内存无关,需要调整复制并发策略。
哪些业务场景不适合用读写分离
实时性要求极高且写入量大的场景不适合,以秒杀系统为例,库存扣减必须走主库并配合分布式锁,读写分离会把读到的过期库存发给用户,另一个不适合的场景是账务类系统,资金明细的查询要求强一致性,从库存在复制延迟,可能读到旧数据,这类系统应该用高性能单库加分区表,而不是拆成读写分离。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/640003.html