任务之间天然存在依赖关系,调度顺序必须按照区块高度递增、日志解析优先于数据聚合、基础层先于应用层来推进,谁先谁后不靠感觉,靠的是依赖判据和拓扑排序。
链上数据索引任务调度顺序怎么定
先理清任务之间到底依赖什么
链上数据索引不是单条SQL能搞定的事,它是一串任务的接力,从区块同步开始,到日志解析、地址归类、交易关联、聚合表生成,每个环节都建立在上一环节的输出上,这个依赖关系可以分成三类:
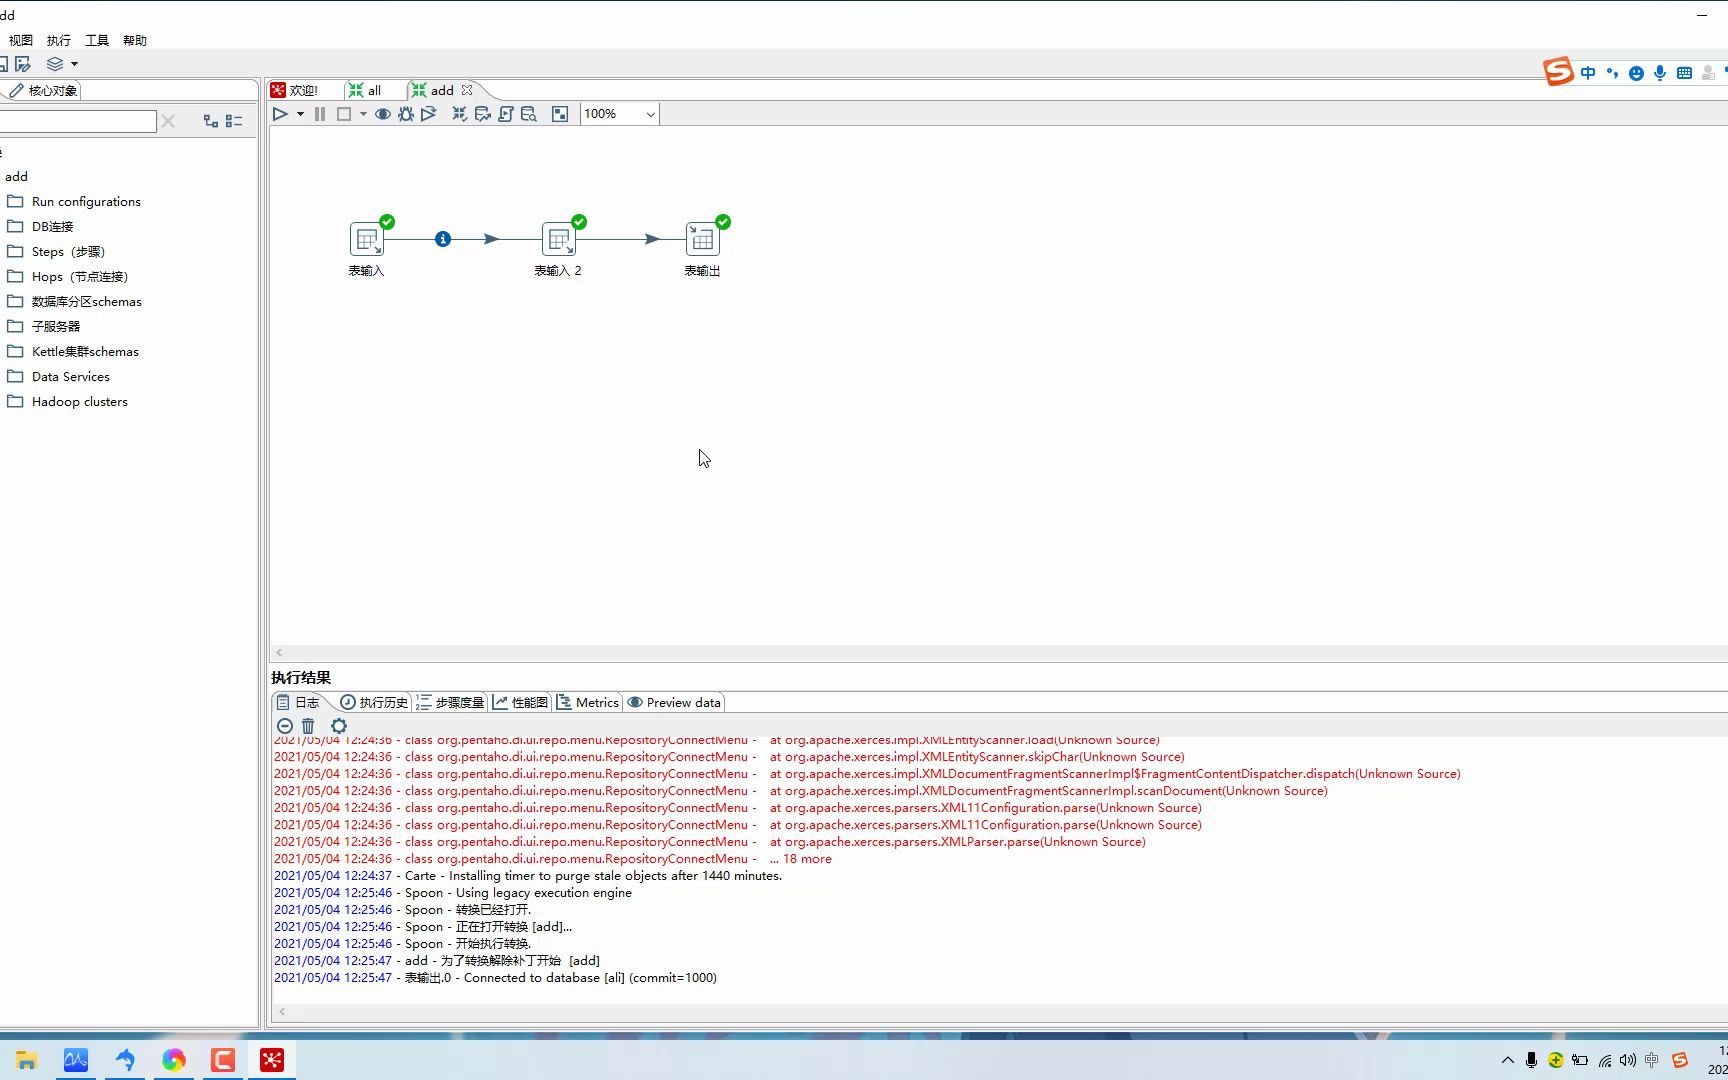

- 数据血缘依赖:下游任务消费上游任务的产出,日志解析必须等区块原始数据落地,余额计算必须等转账事件解码完毕,这类依赖不能打破,只能按序执行。
- 时间窗口依赖:某些任务需要等待特定区块高度到达后才能启动,例如统计某地址的日交易量,必须确认该日最后一个区块已经同步完成。
- 资源竞争依赖:不是严格的前后关系,但并发执行时会产生资源冲突,两个同时扫描全量交易的任务会让节点RPC请求超时,需要做并发控制。
调度顺序的实操判据
行业共识认为,判断任务先后顺序有一个简单标准:先看产出物是否被下游消费,再看数据范围是否覆盖上游的范围,用这个标准去排顺序,比依赖配置图更直观。
具体执行路径如下:
- 将索引任务拆成原子操作,每个操作只做一件事:拉取区块、解析日志、写入中间表、构建聚合视图。
- 按数据流向画出依赖图,识别出哪些任务是阻塞点,阻塞点指的是多个下游任务共同等待的任务,这类任务需要优先调度且保证高可用。
- 对同一层级的任务,按起始区块高度的先后排列,先处理低区块,再处理高区块,避免回查历史数据时反复扫码。
- 跨链数据索引场景下,先处理来源链的数据,再处理目标链的关联数据,例如索引跨链桥的交易,必须先确认来源链的事件已确认,再索引目标链的对应交易。
区块链索引任务依赖关系如何处理
同层任务并行,层间任务串行
依赖关系明确之后,调度策略就清晰了:同一依赖层级内部可以并行,跨依赖层级必须串行等待,拿以太坊索引举例,解析第1000万到1001万个区

块里的ERC-20转账事件,和解析第1000万到1001万个区块里的NFT铸造事件,两者互不依赖,可以并行跑,但生成某个地址的持仓汇总,必须等这两类解析任务都完成,如果强行在解析完成前就去算持仓,得到的是残缺数据,后续还得重跑。
实操中常用的调度框架,例如DAG任务编排器,就是基于这个原则工作的,节点代表任务,边代表依赖关系,调度器按拓扑序列逐层执行,你可以用以下命令验证任务当前的依赖状态:
- 在调度器里查看每个任务的上游依赖数,上游依赖数为零的任务是当前可执行任务。
- 对每个可执行任务分配独立的worker进程或线程池。
- 每当一个任务完成,更新下游任务的上游依赖计数,释放新的可执行任务。
这套机制看似简单,但真正考验人的是依赖粒度的把控,依赖粒度太粗,一个大型任务内部仍有很多串行等待;依赖粒度太细,任务数量爆炸,调度器本身成为瓶颈,多数情况下,按数据类型拆分依赖粒度是合理的:区块同步、事件解码、交易关联各为一个粒度层。
实时索引与全量索引的调度差异
业内专家指出,实时索引和全量索引在调度顺序上有着明显的顺序之别,全量索引的调度顺序是从创世区块往最新区块扫,一次性把历史数据补齐,实时索引则从当前最新区块开始往后监听,每到一个新区块,立即触发解析任务,两者在并行运行时,依赖关系需要额外的协调逻辑。
实际场景中常见的做法是:
- 全量索引先跑,跑到与实时索引的区块高度对齐之后,将任务切换到实时增量模式。
- 在切换点,需要暂停实时任务的消费,等待全量任务追平,这个过程称为接缝处理,接缝处处理不好,会出现数据重复或遗漏。
- 切换完成之后,全量任务可以释放资源,实时任务接管后续的索引工作。
区块重组时的回退顺序
区块链偶尔会发生区块重组,区块回退时,依赖关系的方向会反转,即下游任务需要先回滚,上游任务后回滚,正确的回退顺序如下:
- 先删除聚合层的数据,再删除交易关联层的数据,最后删除原始事件解析层的数据。
- 将同步高度指针回退到重组前最后一个稳定区块。
- 重新执行从该区块开始的解析与聚合任务。

多数索引框架会记录每个任务的已处理区块范围,回退时只需找到最小的公共稳定区块,将其后所有层级的数据全部重置,这里有一个常见认知误区:不少人把回退顺序当成正向索引顺序的严格逆序,实际操作时做反向逐层重置即可,不需要重新跑全量。
索引任务调度中的失败重试该怎么排
重试的本质是调整依赖状态
任务失败时,优先重试的是当前任务本身,而不是依赖它的下游任务,判断能否直接重试,看失败原因是否与区块数据缺失有关,如果是节点未同步到目标区块,重试没有意义,需要等节点追块完成后,再触发依赖该区块的任务,如果失败原因是节点RPC超时或临时网络抖动,可以按指数退避策略重试。
推荐按以下策略分层处理:
- 第一层:任务内部重试,请求失败时自动重试3次,间隔时间依次为1秒、5秒、15秒。
- 第二层:调度器层面重试,任务连续失败超过5次时,暂停该任务及所有下游任务,标记为失败状态。
- 第三层:人工介入修复,检查数据源节点是否健康,检查中间表磁盘空间,修正后从失败任务的起点重新执行。
失败任务的恢复顺序
恢复失败任务时,必须从失败任务的上游最近成功点开始,而不是从失败点开始,原因是上游任务的产出可能已部分更新,直接接续会漏掉数据,正确操作路径:
- 找到调度器日志中记录的最近一次成功执行的区块高度。
- 将同步指针回退到该高度减一的位置。
- 从该位置重新拉取区块数据,并触发后续解析任务。
重试时要留意索引队列的堆积情况,任务失败期间,实时同步的数据仍在持续推进,恢复后需要先追赶实时高度,再处理失败期间的历史区间,这里有个约定俗成的调度顺序:先处理实时增量,确保当前数据是最新的,再回头处理缺口数据,如果反过来,用户查询最新数据时会看到一大段时间空白。
链上数据索引方案选型对调度顺序的影响
不同工具的依赖管理方式对比
选型会直接影响你能编排出的依赖关系,下表对比了主流工具的调度能力差异:
| 工具类型 | 代表方案 | 依赖管理方式 | 适合场景 |
|---|---|---|---|
| 通用DAG调度器 | Airflow、DolphinScheduler | 通过代码显式声明任务依赖 | 离线全量索引、周期性任务 |
| 区块链专用框架 | SubQuery、The Graph | 内置清单文件按实体定义依赖 | 应用层索引,适用中小规模 |
| 流式处理引擎 | Flink、Kafka Streams | 数据流隐式传递依赖关系 | 实时事件监听与聚合 |
| 自定义脚本编排 | Node.js/Python调度 | 手动编码控制并发顺序 | 小型项目快速原型 |

如果你只需要初始化几个关键地址的历史数据,用专用框架的清单声明方式就够,看到一个实体依赖另一个实体时,框架会自动处理顺序,但如果你的任务逻辑复杂,例如多个来源链的数据需要跨链关联,使用通用DAG调度器更直观,可以精确控制每一步执行顺序。
上游数据源的选择顺序
调度的起点是数据源。多数据源并行获取时,根据节点响应速度和数据完整度来排优先级,首选本地全量节点,其次选公共RPC服务,最后选第三方数据服务API,这样排序的原因是本地节点没有请求配额限制,重试成本最低。
如果是多链场景,还需要考虑不同链的区块时间差异,较快的链,例如Solana每400毫秒出一个区块,任务调度频率需要提高;较慢的链,例如比特币的10分钟出块间隔,调度按区块触发即可,这个差异决定了你在编排依赖时,粒度单位到底用区块高度还是时间窗口。
链上数据索引任务调度顺序常见问题解答
问:链上数据索引任务依赖关系太复杂怎么办?
先从数据血缘方向梳理,只保留消费关系,如果A任务的产出被B任务消费,B被C消费,链路清晰,那么按A-B-C的顺序执行一定不会错,把不相关的任务分离到不同调度组,每组内部独立排序。
问:全量索引和实时索引的调度冲突怎么解决?
采用水位线机制,全量索引追踪到实时水位线后,触发一次状态切换,将全量任务转换到增量监听模式,切换点前用全量任务的处理逻辑,切换点后用实时任务的增量逻辑,两者通过数据库中的同步高度记录衔接,这个高度记录是两者的依赖边界。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/%e9%93%be%e4%b8%8a%e6%95%b0%e6%8d%ae%e7%b4%a2%e5%bc%95%e4%bb%bb%e5%8a%a1%e9%97%b4%e4%be%9d%e8%b5%96%e4%b8%8e%e8%b0%83%e5%ba%a6%e9%a1%ba%e5%ba%8f%e6%80%8e%e4%b9%88%e8%ae%be%e7%bd%ae%ef%bc%8c%e8%b0%83/