高并发加购请求下,连接池不能按默认值硬扛,最大连接数应按“核心加购QPS×单请求占用连接时长”反推,再配合获取超时、空闲回收和最大存活时间,最后用压测把数值固定下来。
高并发加购请求为什么会让连接池先崩
加购接口和普通浏览接口不一样,它集中在活动开场、优惠券整点、库存释放这些时间点,流量会在几秒内冲高,每个加购请求都要先从连接池借一个数据库连接,执行完插入或更新后再归还,连接池里的连接一旦被占满,后续请求只能排队等待,等不到就直接报错。
- 加购链路通常涉及购物车写入、库存校验、商品状态更新,事务持有连接时间比单纯查询长。
- 活动峰值QPS可能是日常的几倍甚至几十倍,连接池默认的10个连接完全不够用。
- 数据库本身也有最大连接数限制,应用侧连接池调得太大,会把数据库CPU和内存一起拖垮。
连接占用时间可以用一个简单方式估算:从发起SQL到事务提交或回滚,中间包含网络往返、锁等待、磁盘写入,高并发下如果数据库响应变慢,单请求占用连接时间还会被动拉长,连接池消耗速度会成倍增加。
高并发下连接池最大连接数多少合适:先算后测
用公式反推连接池大小
高并发下连接池最大连接数多少合适,没有固定答案,但可以从核心链路倒推,公式如下:
最大连接数 ≈ (核心加购QPS × 单次请求平均占用连接毫秒) / 1000
举例:假设加购接口平均占用连接40毫秒,目标支撑2000QPS,那么需要的连接数约为:
(2000 × 40) / 1000 = 80
这80个是理论值,实际还要留10%到20%冗余,业内专家指出,连接池并非越大越好,连接数过多会让数据库上下文切换和锁竞争加剧,响应时间反而变长。
参照硬件规格定起步值
生产环境常用的起步算法是:最大连接数 = CPU核数 × 2 + 有效磁盘数,这个值只用来起步,不是最终配置。
- 4核8G应用服务器,起步可设10到15个连接。
- 8核16G应用服务器,起步可设20到30个连接。
- 16核32G以上服务器,数据库如果是云RDS,还要先看数据库规格里的最大连接数限制,应用侧总和不能超过它。
用压测做减法而不是加法
配好起步值后,用JMeter、wrk或Gatling模拟真实加购请求,观察数据库活跃连接数、接口响应时间、错误率,行业共识认为,连接池参数必须经过接近真实流量的压测验证,否则线上容易出事故。
- 压测时若活跃连接数长期贴近最大连接数,说明连接池偏小,可上调5到10个连接。
- 若数据库CPU先接近满载,连接数还没用完,说明连接池已经偏大,需要下调。
- 每次调整幅度控制在5到10个连接,不要一次翻倍。
电商秒杀加购连接池参数设置与Spring Boot连接池性能对比
HikariCP和Druid怎么选
Spring Boot 2.x默认使用HikariCP,Druid是阿里开源的连接池,两者都能扛住高并发加购,但侧重点不同。
| 对比项 | HikariCP | Druid |
|---|---|---|
| 默认性能 | 较高,字节码精简 | 稍弱,但差距不大 |
| SQL监控 | 需要额外接入 | 自带SQL统计和慢查询 |
| 参数配置复杂度 | 低 | 高 |
| 生产排查便利性 | 一般 | 强 |
| 适用场景 | 追求低延迟、简单配置 | 需要可视化监控和SQL审计 |
多数情况下,加购服务如果已经有Prometheus、SkyWalking这类监控平台,可以直接用HikariCP,如果团队需要快速看到SQL执行次数、慢SQL和连接等待线程数,Druid更顺手。
可落地的配置片段
Spring Boot中HikariCP配置如下:
spring.datasource.hikari.maximum-pool-size=30
spring.datasource.hikari.minimum-idle=10
spring.datasource.hikari.connection-timeout=1000
spring.datasource.hikari.idle-timeout=30000
spring.datasource.hikari.max-lifetime=1800000
spring.datasource.hikari.validation-timeout=500
Druid配置类似,额外增加监控参数:
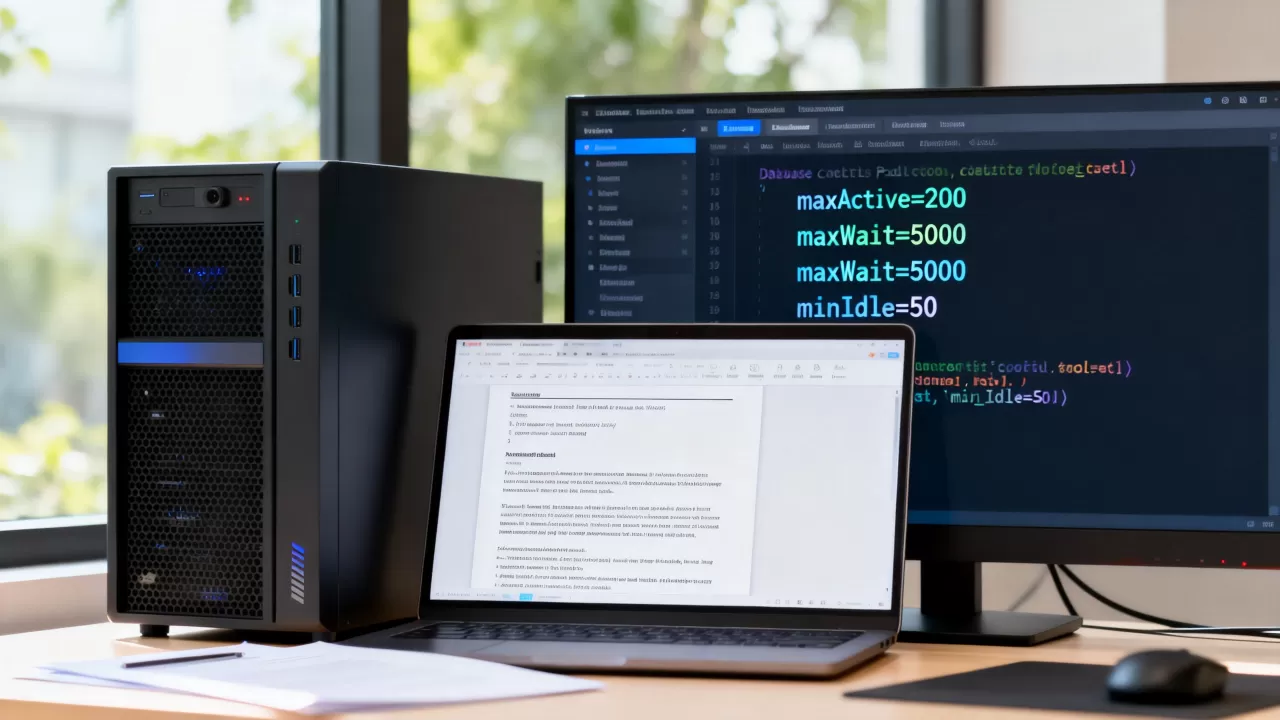
spring.datasource.druid.max-active=30
spring.datasource.druid.initial-size=10
spring.datasource.druid.min-idle=10
spring.datasource.druid.max-wait=1000
spring.datasource.druid.time-between-eviction-runs-millis=60000
spring.datasource.druid.min-evictable-idle-time-millis=300000
关键参数不要照抄默认值
- maximum-pool-size / max-active:连接池最大连接数,高并发加购场景不要低于20,具体按公式和压测结果定。
- minimum-idle / min-idle:最小空闲连接,太小会在流量突增时来不及创建,太大会常驻占用数据库连接。
- connection-timeout / max-wait:获取连接超时时间,建议1000毫秒到3000毫秒,不能让线程无限等。
- max-lifetime:连接最大存活时间,要小于数据库的wait_timeout,避免应用拿到已被数据库关闭的连接。
- idle-timeout:空闲连接回收时间,过长浪费资源,过短会频繁创建销毁。
云服务器地域部署对连接池延迟和成本影响
连接池配置看起来只和应用有关,但云服务器和数据库的地域选择会直接改变连接复用效率,北京、上海、广州等地域内网互联延迟通常较低,跨地域访问数据库会增加网络往返时间,单请求占用连接时间变长,同样的连接池大小能支撑的QPS就会下降。
- 应用部署在北京云服务器,数据库也在同一地域,内网延迟通常维持在1毫秒到3毫秒。
- 应用在北京,数据库在上海,跨地域延迟可能上升到几十毫秒,连接归还速度变慢,连接池更容易被打满。
- 连接池本身不直接产生费用,但最大连接数设置过高,会迫使你升级云数据库规格,带来额外的包年包月成本。
生产环境数据库连接池调优时,先确认应用和数据库是否同地域、同可用区,跨地域部署下,优先通过专线或内网打通,再调整连接池参数,否则调参收益有限。
线上排查和监控路径
高并发加购请求下连接池配置错误的常见表现,可以按下面顺序排查:
- 日志出现“Connection is not available, request timed out after 1000ms”:连接池太小或获取超时太短。
- 数据库报“Too many connections”:应用连接池总和超过数据库最大连接数。
- 压测时响应时间突然变长,但数据库CPU不高:可能是连接池最大连接数过大,线程切换和锁竞争加剧。
- 隔一段时间出现一次“Connection reset”:max-lifetime设置过长,数据库先断了连接。
- 每次流量上来都出现大量“Cannot get a connection”:minimum-idle设置过小,流量突增时来不及扩容。
排查命令和访问路径:
- 查看MySQL当前连接数:
SHOW STATUS LIKE 'Threads_connected'; - 查看最大连接数限制:
SHOW VARIABLES LIKE 'max_connections'; - 查看HikariCP运行状态:在Spring Boot Actuator中访问
/actuator/metrics/hikaricp.connections.active。 - 查看Druid监控:访问Druid内置监控页
/druid/index.html,观察活跃连接数和等待线程数。
高并发加购请求下连接池配置Q&A
高并发加购请求下连接池最大连接数多少合适
没有固定值,按公式估算后再压测,起步值可以参考CPU核数×2+磁盘数,压测时观察数据库活跃连接和CPU情况,逐步调整到刚好满足目标QPS,并保留10%到20%冗余。
Spring Boot连接池性能对比中HikariCP和Druid谁更适合电商加购
HikariCP在纯性能上更轻量,适合已有监控体系的团队,Druid自带SQL监控和慢查询,适合需要快速定位慢SQL的小团队,两者都能扛住高并发,关键在参数和数据库规格匹配。
连接池配置错误会增加云数据库费用吗
会,连接池最大连接数配置过大,会占用云数据库连接额度,迫使升级到更高规格,跨地域部署还会因为延迟增加连接占用时间,间接推高数据库负载,最终增加包年包月成本。
连接池配置的本质是让应用获取连接的速度跟上加购流量,同时不让数据库被过多连接拖垮,先算公式定起步值,再用压测做减法,最后把超时和回收参数配到位,高并发加购请求就能稳下来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/637107.html