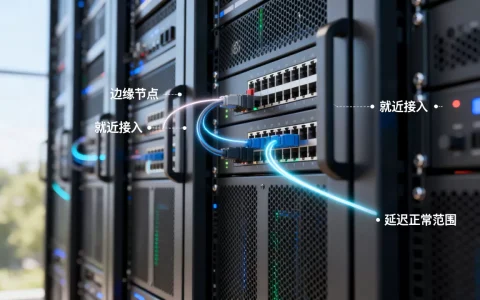
高频交易专线延迟优化没有统一标准答案,但核心结论可以先放这里:把传输路径压到最短、把数据包在设备里的停留时间降到最低、把协议栈旁路做到极致,多数场景下延迟能从毫秒级向微秒级逼近。
高频交易专线延迟多少毫秒才算正常?先把底线说清楚
高频交易里,延迟不是一个模糊的“快”,而是每一微秒都在账上,行业共识认为,延迟的稳定性往往比平均延迟更重要,一次下单慢10微秒,但如果时快时慢,策略会把大量时间浪费在等待确认上。
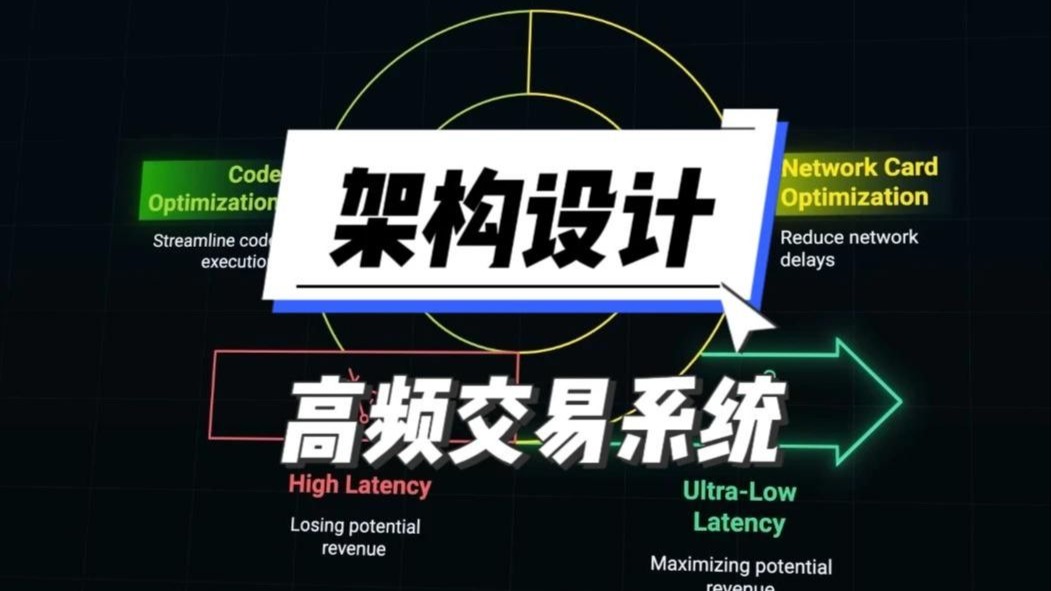
先拆一下延迟的物理底子,光在光纤里跑一公里大约需要5微秒,这是公开物理常数,也就是说,上海到深圳直线距离约1400公里,光传输理论下限就在7毫秒左右,加上路由器、交换机、网卡、服务器协议栈,实际跨城专线多数落在8到10毫秒区间,这个下限不是你花钱买更贵的设备就能砸穿的。
所以高频交易专线延迟多少毫秒算正常,要看交易场景:
- 同城交易所托管机房互连,往返延迟通常可以做到几十微秒到几百微秒。
- 同城跨机房专线,延迟常见在1到3毫秒。
- 跨城专线,物理距离直接决定下限,多数在5到10毫秒以上。
- 做市和套利类策略对延迟最敏感,趋势类策略容忍度高很多。
延迟抖动比平均延迟更值得盯,一条专线平均2毫秒,但抖动到5毫秒,对高频策略的伤害可能比稳定3毫秒更大。
高频交易专线和普通专线区别在哪?关键不在带宽
很多人上来就问带宽,100M还是1G,高频交易专线和普通专线区别在于,带宽是普通专线的核心指标,但对高频交易专线来说,它只是入场券。
普通专线关心的是可用率、丢包率、能不能跑满带宽,它的路由可能经过多个运营商POP点,路径可以动态变化,设备深缓冲,队列长,高峰期流量一大,数据包在交换机里排队,抖动自然就来了。
高频专线要的是确定性:物理路径固定、跳数少、设备浅缓冲、端口不对数据包做过多处理,业内专家指出,把串行设备从链路里拿掉,比单纯升级带宽更有效。
用一张表看差异:
|
维度 | 普通专线 | 高频交易专线 |
|---|---|---|
| 核心指标 | 带宽、丢包率、可用率 | 延迟、抖动、尾部延迟 |
| 路由方式 | 可动态变化 | 固定物理路径 |
| 设备缓冲 | 深缓冲,优先吞吐 | 浅缓冲,优先转发速度 |
| 串行设备 | 可能经过防火墙、负载均衡 | 尽量避免任何串行设备 |
| SLA重点 | 可用性 | 延迟上限与抖动范围 |
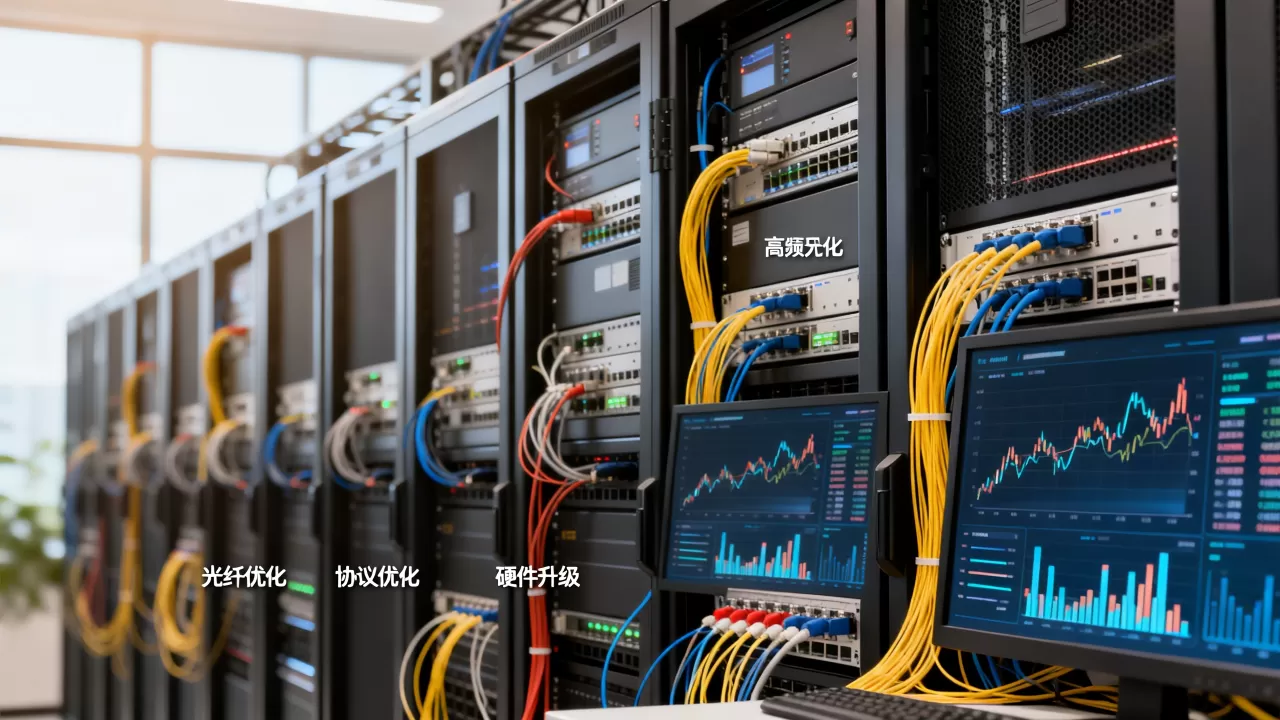
证券高频交易专线部署方案里最容易被忽视的三个环节
上海高频交易专线优化的机房选址逻辑
证券高频交易专线部署方案第一步不是找运营商谈价格,而是先看机房位置,据交易所公开托管机房信息,上交所托管机房在金桥,深交所托管机房在凤岭,上海高频交易专线优化的核心逻辑,就是尽量缩短机柜到交易所撮合主机的物理距离。
同城几公里的裸纤,延迟可以压到几十微秒;跨城一百公里的专线,光传输就要500微秒以上,所以机构会优先在交易所托管机房内部署策略服务器,再通过低延迟专线连接自有机房,机柜到配线架的光缆长度、楼层间走线,都会影响实际延迟。
操作路径可以按这个顺序:
- 先确认co-location机柜到交易所主机所在楼层的实际光缆路由长度。
- 用OTDR或交换机光模块数字诊断读取实际光纤长度,不要只看地图距离。
- 再把接入交换机放在离服务器最近的位置,减少铜缆或AOC跳线长度。
设备端口与网卡参数能吃掉几十微秒
服务器网卡和交换机端口是隐藏的延迟大户,默认参数为了兼容性和吞吐量,会打开中断合并、自适应调整、节能模式,这些对高频交易全是负担。
在Linux服务器上,至少可以做几件事:
- 关闭网卡中断合并:
ethtool -C eth0 rx-usecs 0 adaptive-rx off - 把网卡队列中断绑定到指定CPU核心:调整
smp_affinity_list,避开CPU 0。 - 查看队列分布:
ethtool -l eth0,确认队列数是否与CPU核心匹配。 - 关闭CPU省电状态:BIOS里关掉C-states、SpeedStep,保持核心全速。
- 使用内核旁路技术,让数据包不经过内核协议栈,直接到用户态应用。
- 高频行情数据包通常很小,不要盲目开启巨型帧,小包等待填充反而增加序列化延迟。
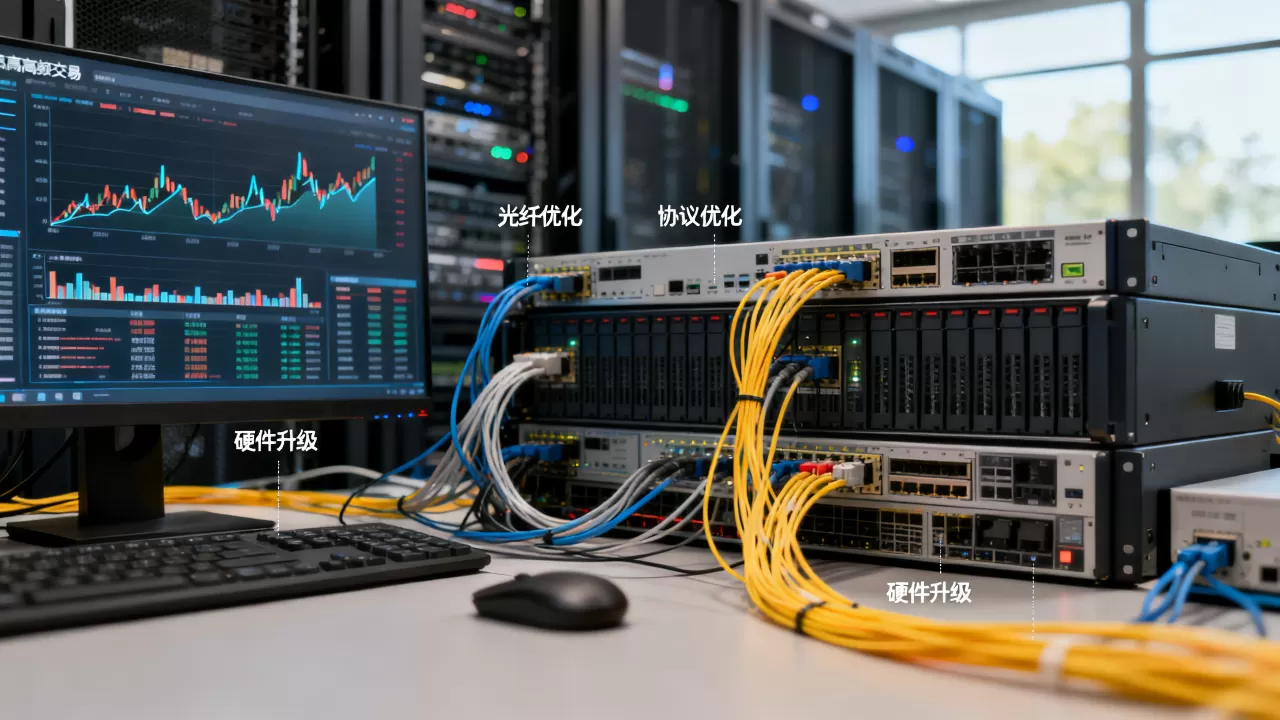
这些操作不是一次性设置,每次换内核、换网卡驱动、上安全补丁后都要复查,很多延迟劣化就发生在变更窗口之后。
行情接收与下单通道必须物理分离
证券高频交易专线部署方案里,一个常被忽略的点是:行情通道和交易通道如果共享同一条物理链路,突发流量会互相挤占,行情组播流量一旦突发,下单包可能在交换机队列里多等几十微秒。
所以成熟的做法是:
- 行情专线和交易专线使用不同物理端口、不同光纤、不同交换机。
- 交易通道优先级最高,尽量保持低负载。
- 行情接收服务器与策略服务器之间用低延迟交换机直连,不做三层路由。
- 下单通道上游设备不要做流量统计、镜像、采样,这些都会增加处理负担。
路由与交换机跳数比想象中更影响抖动
数据包每经过一台三层设备,就要被路由查找、队列调度、缓冲区处理,多一跳,延迟会加,抖动更会加,证券高频交易专线部署方案里,链路跳数越多,尾部延迟越不可控。
具体做法:
- 专线两端走二层直连或VLAN隔离,减少三层路由。
- 移除防火墙、IDS、负载均衡等串行设备,即使是透明模式也会增加处理延迟。
- 交换机开启cut-through转发模式,收到帧头就开始转发,不用等整个帧收完。
- 用
traceroute或Paris traceroute检查路径,如果跳数异常增加,立刻找运营商核对路由。 - 关闭交换机上不必要的协议,比如生成树、动态路由、CDP/LLDP,让数据面更干净。
高频交易专线价格一般多少?延迟优化的钱要花在刀刃上
高频交易专线价格一般多少,取决于几个变量:物理距离、端口速率、SLA等级、是否裸纤或波长,同城裸纤和跨城专线价格差距很大,跨城专线价格通常明显高于同城裸纤,但延迟优化空间反而更小。
如果只盯着线路月租,很容易花错钱,一条价格更高的跨城专线,物理下限卡在光速上,优化空间有限;而把预算花在交易所co-location、低延迟网卡和浅缓冲交换机上,往往能在同城链路里抠出更多微秒。
多数情况下,机构预算的大头不在线路月租,而在机房托管费、低延迟设备和运维人力,所以高频交易专线价格一般多少合理,答案是:先算清每微秒的优化成本,再决定要不要上更贵的跨城线路。
可落地的延迟优化顺序
把上面的技术方向串成一条可执行路径:
- 先量测:OTDR光纤长度、交换机光模块光功率、服务器到交换机跳线长度。
- 再精简:移除串行设备,减少跳数,固定路由,走二层直连。
- 后调参:网卡中断合并关闭、队列绑定、CPU性能模式、内核旁路。
- 最后验抖动:用纳秒级时间戳打点,关注p99和p999延迟,而不是只看平均值。
高频交易专线延迟优化的本质,不是买更贵的线路,而是把数据包在每一台设备、每一段光纤、每一层协议栈里的停留时间一点点抠出来,能抠出多少,取决于你对链路细节的控制程度。
Q&A
高频交易专线上海到深圳延迟能做到多低?
上海到深圳直线距离约1400公里,光在光纤中传输的理论下限约7毫秒,加上设备转发、排队和服务器处理,实际多数在8到10毫秒区间,跨城专线无法突破物理下限,优化重点应放在减少抖动和尾部延迟,而不是追求不切实际的更低平均延迟。
高频交易专线和普通专线区别会影响下单速度吗?
会,普通专线可能因动态路由和深缓冲排队,在行情高峰时段产生额外抖动,下单包到达交易所主机的时间不稳定,高频交易专线通过固定路径、浅缓冲设备和减少串行节点,能显著降低尾部延迟,让下单到达时间更可控。
高频交易专线价格一般多少才合理?
没有统一报价,同城裸纤、跨城波长专线、交易所托管机柜费用差异很大,多数机构会把预算优先投入co-location和低延迟设备,而不是盲目追求更高带宽,跨城专线价格通常明显高于同城裸纤,但延迟优化空间有限,需要按实际策略容忍度评估。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/639401.html