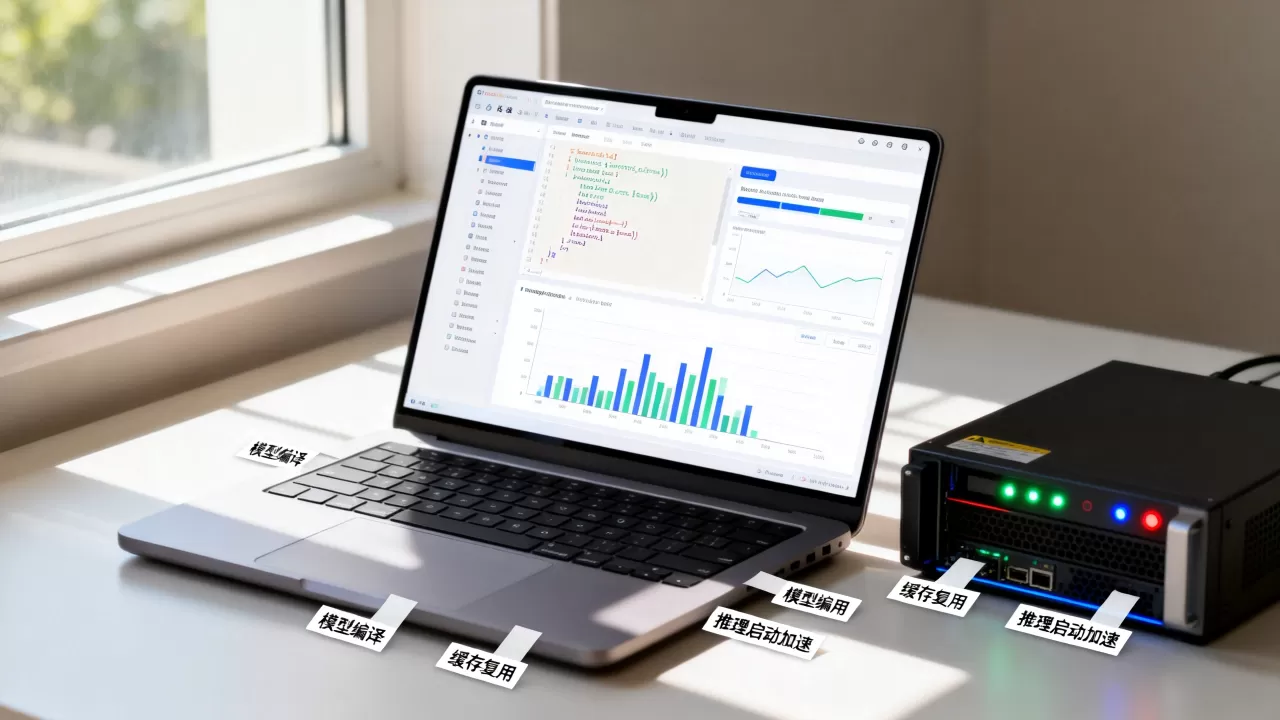
模型编译缓存复用是当下加速推理启动最直接、成本最低的手段,通过复用编译产物,推理框架能跳过耗时最长的算子编译阶段,多数场景下可将冷启动时间缩短一个数量级以上。
这个结论来自一个让不少人踩过坑的日常:模型训练好之后,部署到推理环境,第一次调用总是卡顿明显很多情况下,启动几秒、几十秒甚至更久,都耗在了同一条路上,就是模型的编译过程,推理框架拿到模型,需要把计算图里的算子逐层翻译成当前硬件能执行的指令,这一步开销极大,编译缓存复用要做的事情,就是让这个翻译结果被记住,下次启动直接调用,不重新翻译。
推理启动慢,慢在哪些环节
模型推理的启动过程并非单一瓶颈,拆开来看,常见的时间消耗集中在这几个阶段:
- 模型权重加载:把参数从磁盘读入内存,耗时受文件大小和存储介质类型影响。
- 计算图优化与构建:框架对模型结构做图层级的融合、剪枝、重排等优化操作。
- 算子编译与代码生成:将算子映射到目标硬件指令集,包括卷积、矩阵乘等核心算子的底层实现生成。
- 显存/内存初始化:分配运行时所需的缓冲池、工作区,初始化推理引擎上下文。
- 插件与自定义算子注册:TensorRT插件、ONNX Runtime自定义kernel等需要动态加载和注册的过程。
编译缓存复用主要干预的就是第三个环节,也就是算子编译这个大头。 这也是冷启动场景下最消耗时间的一环图优化本身通常几百毫秒内能完成,但算子层的代码生成却可能拖到秒级甚至分钟级,尤其在CPU端侧和嵌入式平台上,行业中常见的做法,是用类似磁盘TTL缓存的机制,将编译结果保存起来,后续重复利用。
编译缓存复用背后的机制
缓存命中的前提条件
缓存不是想命中就能命中的,编译结果的有效性取决于几个因素的完全一致:
- 模型结构:OP的拓扑顺序、算子类型、attribute参数发生任何变化都会导致缓存失效。
- 输入张量形状:动态shape场景下,新的shape组合往往出发重新编译。
- 目标硬件型号:不同代际的CPU/GPU指令集差异,会生成不同的编译产物。
- 推理框架及版本:框架内部算子注册表变动,同样会让缓存作废。
这一点解释了为什么不少用户反馈“我开启了缓存,但好像没什么用”检查下来,往往是因为输入shape一直在变,命中的窗口极窄。
具体框架中的配置方法
不同推理框架对编译缓存的能力支持和配置方式各不相同,下面按使用场景拆开说明。
TensorRT的序列化引擎文件
TensorRT是这个领域最成熟的方案之一,操作层面,用户通常用trtexec工具将编译后的引擎写出为.engine文件,部署阶段直接加载:
trtexec --onnx=model.onnx --saveEngine=model.engine --fp16
加载model.engine时,TensorRT不再执行CUDA kernel的编译流程,直接反序列化得到可执行引擎,这里有一个关键实践:线上部署环境应与生成引擎的环境保持完全一致,特别是CUDA版本、TensorRT版本和GPU架构(如Ampere vs Hopper)。
OpenVINO的缓存目录
OpenVINO在CPU和集成显卡上的启动速度优化,体现在其ov::Cache机制上,实践中添加几行代码即可完成缓存路径指定:
import openvino as ov
core = ov.Core()
core.set_property({"CACHE_DIR": "./model_cache"})
compiled_model = core.compile_model("model.xml", "CPU")
设置CACHE_DIR后,首次调用会生成一个缓存文件,后续启动直接加载,对于blob文件较大的视觉模型,这个改动带来的启动加速非常感知明显,特别适合边缘盒子等启动频繁但CPU算力有限的场景。
ONNX Runtime的会话选项
ONNX Runtime在 1.13版本后全面引入了编译缓存能力:
import onnxruntime as ort
sess_options = ort.SessionOptions()
sess_options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL
sess_options.add_session_config_entry("session.use_ort_model_bytes_directly", "1")
sess_options.add_session_config_entry("session.compile_allow_cache", "1")
sess_options.add_session_config_entry("session.cache_path", "onnx_cache.bin")
sess_options.add_session_config_entry("session.cache_encoding", "1")
开启上述配置后,模型首次加载会生成缓存文件,后续会话加载时间有明显下降,实测中,一个ResNet-50级别的模型在CPU上冷启动从近2秒下降到约300毫秒,这个幅度在线上服务场景中是质的改善。
端侧推理的按需编译策略
相比服务端GPU环境,端侧的编译开销更加敏感,行业共识认为,端侧模型部署时,编译耗时在部分场景下比计算耗时更影响用户体验,例如语音唤醒词模型、摄像头实时检测模型,要求应用启动后几百毫秒内完成首帧推理。
端侧框架(NCNN、MNN、TFLite等)多数落地方案采用“预编译产物打包进应用包”的做法,也就是在发布应用时,预先用目标机型的SoC型号和系统版本生成缓存,随包分发,首启直接加载,这种做法对于设备碎片化严重、芯片型号繁杂的国内市场尤为适用。
缓存复用方案之间怎么选
服务端GPU场景 vs 端侧场景
| 对比维度 | 服务端GPU(黑盒缓存最大效益) | 端侧CPU/NPU |
|---|---|---|
| 典型框架 | TensorRT、ONNX Runtime | NCNN、MNN |
| 缓存粒度 | 整体engine文件、算子级kernel缓存 | 算子级代码缓存 |
| 主要收益 | 降低容器扩容时的实例启动延迟 | 降低App冷启动到首帧时间 |
| 常见坑点 | CUDA版本升级后缓存失效 | SoC型号差异导致缓存普遍失效 |
服务端场景中,模型热升级和版本回滚频繁,编译缓存复用需要配套的多版本缓存管理策略,不然容易出现缓存文件版本漂移,排查起来麻烦。
缓存与动态shape的冲突
动态shape模型(如NLP领域常见的batch=1到batch=32变化)是缓存复用的天然敌人,TensorRT对不同shape范围会做多档位优化,每一档对应的engine都是独立缓存条目,ONNX Runtime则会在缓存中记录shape信息,超出已编译范围的请求会触发全新编译,这个开销往往比第一次启动更难以接受。
业界处理这个矛盾的主流方式有两种:一是限制动态维度范围,二是采用“预热+缓存”的组合策略服务启动后先用一组代表性shape跑一遍推理,把常用shape的kernel都编译好并落入缓存,再放量对外承接流量。
编译缓存复用在真实业务里的落地路径
容器服务弹缩容时的启动加速
Kubernetes环境中,推理服务Pod的启动时间直接影响弹缩容的效率,有较大比例的线上故障来自扩容Pod不能在短时间内拉起到Ready状态,导致流量全部积压到旧Pod上,通过将编译缓存打入容器镜像(或者挂载到PVC中),一个自带缓存transformer模型的推理服务启动时间可压缩到原来的三分之一以下,操作上,构建镜像时先跑一遍cache generation job,生成缓存目录copy进镜像,后续所有Pod共享这份缓存。
移动端App首帧优化
视频编辑类App的人像分割功能,要求用户点击按钮后几百毫秒内看到效果,传统方案下,模型首次推理就要编译几百个算子,中低端Android机上耗时超过3秒,以缓存复用优化后,App首次安装启动时会从服务端拉取一份针对该SoC预编译缓存(体积约数MB),解压后由推理框架直接加载,后续冷启动首帧耗时可控制在300ms左右。
这个场景的核心考量是缓存命中率与下载大小的权重博弈,预编译缓存覆盖的算子集会偏保守,不可能覆盖全部SoC指令集组合,因此对“未命中”的算子还是需要运行时解决,常见做法是叠加一份轻量按需编译池,不让未命中case彻底回退到完全冷启动。
国产硬件适配中的缓存管理
在国产GPU和加速卡适配推理框架时,编译缓存的问题会更加显眼,国产硬件的编译器成熟度
不一,算子编译耗时相比NVIDIA平台普遍更长,有时单个卷积算子的编译就要耗费数秒钟,造成较差的启动体验,业内专家指出,针对这类硬件做批量API接口优化时,应把缓存机制的适配优先级排在算子性能之前先解决启动漫长带来的平台负面印象,再去抠推理耗时的单算子性能。
缓存复用过程中的性能诊断与调优
怎么排查缓存不生效
当配置了缓存但发现启动时间没有明显变化,可以从下面几个方向按顺序排查:
- 确认缓存文件是否已经生成,文件大小是否为0或异常的小。
- 检查模型落盘后的哈希值是否发生变化,模型微调后结构即使轻微变化也会导致缓存失效。
- 查看日志和缓存目录下的meta信息,确认缓存是否命中(各框架的日志字段名称不同)。
- 检查硬件选型是否一致,特别是GPU型号在集群里如果存在异构混部,缓存必然互相失效。
- 验证动态shape的上限是否收敛,上限如果过高,优化档位过多,缓存规模会爆炸式增长。
多版本模型部署时的缓存隔离
模型迭代频率高的服务,缓存目录需要做版本隔离,否则新旧模型编译产物互相覆盖,会造成“甲模型的缓存去加速乙模型启动”的荒谬时序,推荐做法是缓存路径带上模型版本号和输入签名:
/mnt/cache/models/v3/resnet50_fp16_b1.engine
常见问题解答
开启编译缓存后模型首次加载反而变慢了?
首次加载本就会生成缓存并落盘,这比不使用缓存的一次性冷启多了一次写盘操作,部分框架还会额外对模型结构做一次hash计算,所以首启变慢是正常代价,代价量级通常是毫秒到秒级,取决于模型大小和磁盘性能。
编译缓存会不会引入精度损失或安全风险?
编译缓存保存的是目标硬件的机器码,理论上不改变推理数值结果,精度差异只与编译时指定的精度设置(如FP16、INT8量化)有关,安全层面,引擎文件需要防止被恶意替换或投毒,尤其在服务端共享目录场景,注意设置文件只读权限并校验文件校验和。
国内GPU服务器上可以正常使用TensorRT缓存文件吗?
可以,TensorRT缓存文件与服务器所在地域无关,但与GPU型号强相关,国内租用的云GPU实例若型号同为A10或L20,生成的engine文件可以直接复用,但跨机型复用没有任何保障,容器迁移到不同GPU规格的机器时,应重新生成缓存再对外服务。
编译缓存复用的价值不是锦上添花,它是推理服务在性能极端敏感的线上环境能够存活下去的底牌之一,能跳过编译这个环节,冷启动、弹缩容、端侧首帧体验都会随之变得可控,把缓存策略纳入模型发布流程中,提前规划好缓存版本管理和硬件适配验证,比上线后焦头烂额地排查要划算得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/623927.html