构建大模型的核心在于高质量语料清洗、分布式算力集群调度以及基于Transformer架构的迭代训练,这是一个融合数据工程、算法优化与基础设施管理的系统工程。
很多人以为大模型就是“喂”给电脑一堆书,它自己就会说话了,这更像是在培养一个天才学生,不仅要给他最好的教材,还要有顶级的导师引导,甚至需要专门的教室和实验设备,如果你只是把数据扔进服务器,得到的只是一堆乱码,而不是智能。

数据准备:大模型的“粮食”决定上限
业内专家指出,数据质量直接决定了模型智商的上限,没有好数据,再先进的算法也是空中楼阁。
多源数据采集与清洗
构建大模型的第一步不是写代码,而是找数据,你需要从互联网、书籍、学术论文、代码库等多个渠道抓取原始文本,但这只是开始,原始数据充满了噪音。
- 去重与过滤:剔除重复内容、低质量网页、广告和乱码。
- 隐私脱敏:移除个人信息、敏感数据,确保合规。
- 格式统一将PDF、HTML、Markdown等不同格式转换为统一的纯文本格式。
语料配比策略
不同种类的数据对模型能力的影响截然不同,行业共识认为,合理的配比能显著提升模型的综合表现。
| 数据类型 | 占比建议 | 核心作用 |
|---|---|---|
| 高质量网页文本 | 40%-50% | 提升通用知识储备与语言流畅度 |
| 代码数据 | 20%-30% | 增强逻辑推理与编程能力 |
| 数学与科学数据 | 10%-15% | 强化逻辑推导与事实准确性 |
| 对话与指令数据 | 10%-15% | 优化交互体验与指令遵循能力 |

具体操作路径
- 使用爬虫工具采集原始数据。
- 部署去重算法(如SimHash)去除重复样本。
- 利用小模型或规则引擎进行质量打分,筛选出高分语料。
- 将清洗后的数据分片,存入分布式存储系统。
算力基础设施:训练的“引擎”
训练大模型是一场算力的豪赌,你需要理解如何搭建和调度这些昂贵的资源。
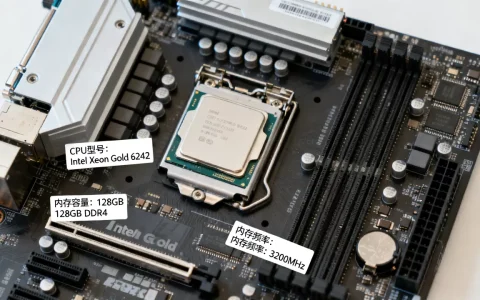
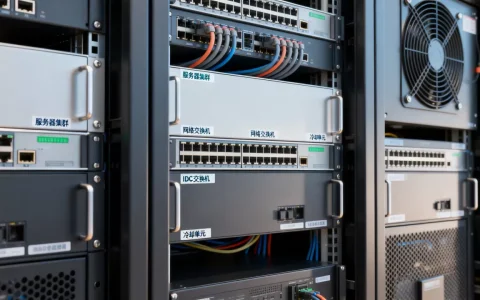
硬件选型与集群搭建
目前主流的选择是GPU集群,尤其是NVIDIA的高端显卡,对于初学者或中小企业,租用云端算力比自建机房更划算。
- GPU选择:A100或H100是训练大模型的标准配置,显存越大,能处理的批次越大,训练速度越快。
- 网络互联:节点间的高速互联至关重要,使用InfiniBand或RoCE网络,确保GPU间通信延迟极低。
- 存储系统:需要高吞吐量的并行文件系统,以支持海量数据的快速读取。
分布式训练策略
单张显卡无法容纳大模型参数,必须使用分布式训练技术。
- 数据并行:将数据切分,多张显卡同时处理不同部分的数据,最后同步梯度。
- 模型并行:将模型层切分,不同层分布在不同显卡上,适合超大规模模型。
- 张量并行:将矩阵运算切分,适合单层内部计算量巨大的场景。
实操建议
如果你正在寻找ai如何建大模型的入门方案,建议先从小规模模型开始,使用开源框架如DeepSpeed或Megatron-LM,它们内置了多种并行策略,能自动帮你管理分布式训练过程。

模型架构与训练流程:核心算法的实现
这是最核心的环节,决定了模型如何“思考”。
选择基础架构
目前Transformer架构是绝对的主流,它通过自注意力机制,让模型能够捕捉长距离依赖关系。
- Decoder-only:如LLaMA、ChatGLM,适合生成任务,是目前大语言模型的主流选择。
- Encoder-Decoder:如T5,适合翻译、摘要等需要理解后生成的任务。
预训练阶段
预训练是让模型学习世界知识的过程。
- 初始化参数:随机初始化模型权重。
- 前向传播:输入文本,计算预测结果。
- 计算损失:对比预测结果与真实标签,计算误差。
- 反向传播:根据误差调整模型参数。
- 迭代更新:重复上述步骤,直到损失收敛。
微调与对齐
预训练后的模型虽然博学,但可能不会听话,甚至胡言乱语,这时候需要微调。
- SFT(监督微调):使用高质量的人机对话数据,教模型如何按照人类意图回答。
- RLHF(人类反馈强化学习):通过人类打分,奖励模型生成更有帮助、更安全的回答。
常见误区
不要试图用少量数据训练大模型,微调需要数千到数万条高质量指令数据,否则会导致模型“过拟合”,失去泛化能力。
部署与优化:让模型落地应用
训练好的模型如果无法高效运行,就没有商业价值。
模型压缩技术
大模型参数量巨大,推理成本高。
- 量化:将32位浮点数转为8位整数,大幅降低显存占用,速度提升明显。
- 剪枝:去除模型中不重要的连接,减少计算量。
-

知识蒸馏
:用大模型教小模型,让小模型具备接近大模型的能力。

推理加速框架
使用vLLM、TensorRT-LLM等推理加速框架,可以显著提升吞吐量。
- PagedAttention:优化显存管理,提高并发处理能力。
- Continuous Batching:动态合并请求,减少等待时间。
成本与资源评估:你需要准备多少预算?
很多人问,搭建一个大模型需要多少钱?这取决于模型的规模和训练数据量。
- 小规模模型:几亿参数,可在单张高端显卡上微调,成本较低,适合垂直领域应用。
- 中等规模模型:几十亿参数,需要多卡集群,成本中等,适合通用对话场景。
- 大规模模型:千亿参数以上,需要千卡集群,成本高昂,通常由大厂主导。
据统计,训练一个千亿参数模型的成本可能在数百万到数千万人民币不等,包括算力租赁、数据采购和人力成本,对于大多数企业,基于开源模型进行微调是更经济的选择。
常见问题解答
ai如何建大模型需要编程基础吗?
需要一定的编程基础,特别是Python和深度学习框架(如PyTorch),如果你不懂代码,很难调试模型和解决训练中的问题,但你可以使用低代码平台或云服务,降低技术门槛。
自己训练大模型和调用API有什么区别?
调用API成本低、速度快,适合快速验证想法和应用开发,自己训练数据可控、隐私性好,适合对数据安全要求高或需要深度定制的场景,对于大多数中小企业,调用API是更务实的选择。
大模型训练失败常见原因有哪些?
数据质量差、学习率设置不当、显存溢出是常见原因,确保数据清洗彻底,使用梯度累积技术解决显存不足,并监控训练损失曲线,及时调整超参数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/ai%e5%a6%82%e4%bd%95%e6%9e%84%e5%bb%ba%e5%a4%a7%e6%a8%a1%e5%9e%8b%ef%bc%9f%e5%a4%a7%e6%a8%a1%e5%9e%8b%e8%ae%ad%e7%bb%83%e5%85%a8%e6%b5%81%e7%a8%8b%e8%af%a6%e8%a7%a3/