大模型为什么会答错?从业者揭秘背后真相

大模型“一本正经胡说八道”的现象,本质上并非单纯的“故障”,而是基于概率预测的技术原理与人类对“真理”的绝对追求之间存在天然鸿沟。核心结论是:大模型的错误是其生成机制决定的必然,而非偶然的Bug,解决之道在于构建“人机协同”的防御体系,而非单纯期待模型自我进化。作为行业从业者,关于大模型答错的问题,从业者说出大实话,这背后既有技术架构的局限,也有数据治理的难题,更有应用层面的认知偏差。

关于大模型答错的问题

技术原理层面:概率预测不等于逻辑推理

大模型之所以会犯错,首先要从其“大脑”构造说起,目前的通用大模型,其底层逻辑是“下一个词预测”,而非严谨的逻辑推演。

  1. 概率生成的必然随机性: 模型在生成内容时,是在巨大的词库中寻找概率最高的词语组合。这种机制决定了模型擅长“编造”通顺的句子,却不擅长验证事实的真伪。 当模型遇到知识盲区,为了满足“生成”的指令,它会基于概率拼接看似合理实则错误的信息,这就是著名的“幻觉”现象。
  2. 知识压缩的有损性: 大模型将海量互联网数据压缩在参数中,这个过程类似于将有损压缩的图片还原。细节的丢失和语义的模糊,导致模型在面对精细问题时,往往只能给出一个“大概齐”的答案,而非精确解。
  3. 对齐税与能力阉割: 为了让模型安全、合规,厂商会对模型进行RLHF(人类反馈强化学习)训练,这个过程虽然降低了有害内容的输出,但也可能导致模型在某些专业领域的知识被“阉割”或产生过度拒答,间接增加了答错或答非所问的概率。

数据治理层面:垃圾进,垃圾出

模型的表现上限由训练数据决定,从业者深知,即便模型架构再完美,低质量的数据也会导致灾难性的后果。

  1. 训练数据的时效性滞后: 大模型的知识截止日期是其硬伤。模型无法预知训练截止日期之后发生的事情, 如果用户询问最新的新闻或技术,模型只能基于旧知识进行推断,极易产生事实性错误。
  2. 互联网数据的噪声污染: 训练数据主要来源于公开互联网,其中充斥着偏见、谣言和低质内容。模型不具备分辨真伪的能力,它会平等地学习正确知识和网络谣言。 当用户提问时,模型可能复述了训练集中的错误信息。
  3. 专业领域数据的稀缺: 通用模型在金融、医疗、法律等垂直领域表现不佳,核心原因是高质量的专业数据往往封闭在机构内部,未进入训练集。缺乏专业数据的支撑,模型在专业领域的回答往往流于表面,甚至出现原则性错误。

应用落地层面:用户期待与能力的错位

关于大模型答错的问题

很多时候,模型答错并非模型“蠢”,而是用户用错了方法。

  1. 提示词工程的缺失: 同一个问题,不同的问法会得到截然不同的答案。用户往往期望模型像真人一样“懂我”,使用模糊、隐晦的指令,导致模型理解偏差。 简单问“写个方案”,模型可能输出泛泛而谈的内容;若加上角色设定、背景约束,效果会大幅提升。
  2. 过度依赖单次对话: 大模型具有强大的上下文学习能力,但很多用户习惯“一问一答”就结束。通过多轮对话纠正模型的错误,引导其逐步逼近真相,才是正确的使用姿势。 拒绝迭代修正,就等于放弃了模型自我纠错的机会。
  3. 盲目信任与缺乏验证: 许多用户将大模型视为搜索引擎的替代品,盲目采信其输出的数据。从业者的大实话是:大模型更像是“副驾驶”,而非“驾驶员”。 在关键决策上,必须引入人工审核机制,尤其是在代码生成、医疗建议等高风险场景。

解决方案:构建可信的AI应用闭环

面对大模型答错的问题,我们不能因噎废食,而应建立系统性的解决方案。

  1. 引入RAG(检索增强生成)技术: 这是目前解决幻觉问题最有效的手段。通过外挂知识库,让模型在回答前先检索相关事实,再基于事实生成答案。 这不仅解决了知识时效性问题,还大幅降低了胡说八道的概率,让回答有据可查。
  2. 建立人机协同(HITL)机制: 在关键业务流程中,必须保留人工审核环节。模型负责生成初稿或提供选项,人类负责最终把关。 这种模式既利用了AI的效率,又规避了其准确性风险。
  3. 优化提示词策略: 企业和个人用户都应掌握基本的提示词技巧。通过“思维链”引导模型展示推理过程,或要求模型“如果不知道请回答不知道”, 可以有效抑制模型的幻觉倾向,迫使其在不确定时保持诚实。
  4. 微调垂直领域模型: 针对特定行业,不应直接使用通用大模型。利用行业私有数据对模型进行微调,注入专业知识, 能够显著提升模型在特定场景下的准确率和专业度。

相关问答

为什么大模型有时候会非常自信地给出错误答案?

关于大模型答错的问题

这主要源于模型训练中的“过度自信”问题,在训练过程中,模型倾向于最大化预测概率,即便是在它不确定的情况下。由于缺乏对“不确定性”的显式建模,模型无法像人类一样表达“我猜”或“可能”。 训练数据中可能存在错误但表述流畅的内容,模型学习后便会产生自信的错误输出,解决这一问题需要引入不确定性量化技术,或在训练数据中增加更多反例和纠错数据。

大模型的“幻觉”问题未来能被彻底解决吗?

彻底解决“幻觉”在目前的技术路径下极难实现,因为生成式AI的本质就是创造而非检索。但随着RAG技术、事实核查模块以及更先进的推理架构的应用,幻觉的比例可以被控制在极低水平。 未来的大模型可能不再是单一的生成器,而是集成了检索、计算、逻辑验证的智能体系统,从而在实用层面“消除”幻觉的影响。

您在使用大模型的过程中遇到过哪些离谱的错误?欢迎在评论区分享您的经历和看法。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/119169.html

赞 (0)
安装公司管理软件哪个好?管理软件中心推荐高效工具
上一篇 2026年3月23日 19:55
大模型写综述框架难吗?大模型综述怎么写
下一篇 2026年3月23日 19:56

相关推荐

  • cdn分发时间是多少?CDN分发时间

    CDN分发时间并非固定值,而是受节点距离、网络拥塞及缓存命中率共同影响的动态指标,2026年主流场景下全球首字节响应时间(TTFB)已普遍优化至50ms以内,静态资源分发延迟稳定在20ms级别,在2026年的数字化基础设施中,内容分发网络(CDN)已不再是简单的“加速工具”,而是构成低延迟互联网体验的核心神经末……

    2026年6月6日
    4500
  • 虚拟机操作界面新手如何快速上手常用功能?有哪些实用技巧?

    虚拟机操作界面新手想快速上手,核心思路是先掌握“快照、共享文件夹、网络模式”这三个救命功能,再熟悉“新建、设置、克隆”三个高频按钮,整个学习过程不需要看任何厚重手册,体验虚拟机,最常见的场景是装一个Linux系统练手,或者测试来历不明的软件,初次打开VMware Workstation或VirtualBox,面……

    2026年10月13日
    300
  • 全站加速与静态加速动态接口差异在哪?,全站加速有什么用?

    全站加速和静态加速的核心差异不在静态资源缓存,而在动态接口请求是否被纳入优化链路——静态加速让图片、CSS离用户更近,全站加速则把动态API的每一跳都改造成低延迟通道,全站加速和静态加速的区别:动态接口为什么是分水岭静态加速做的事比较单纯,用户访问一张商品图、一个CSS文件、一段视频分片,CDN边缘节点如果已经……

    2026年9月11日
    300
  • CDN和IDC有什么区别,CDN加速原理

    CDN与IDC并非对立关系,而是互补协同的技术架构,选择根节点资源需根据业务对延迟敏感度、带宽成本及合规性要求综合决策,2026年主流趋势是“边缘计算+中心云”的混合部署模式,CDN与IDC的核心差异与协同逻辑在2026年的数字化基础设施格局中,单纯区分“用CDN还是用IDC”已显过时,真正的核心在于理解两者在……

    2026年6月16日
    3600
  • CDN防攻击怎么设置?,CDN防攻击方法有哪些

    在2026年,网站面临的安全威胁日益复杂,部署专业的CDN防攻击服务是抵御DDoS和CC攻击、保障业务连续性的最有效解决方案,能够过滤99%以上恶意流量并确保源站零中断,为什么CDN防攻击成为2026年网站标配1 攻击规模与频率呈指数级增长根据中国信通院《2026年网络安全态势报告》,当年DDoS攻击峰值带宽突……

    2026年7月21日
    3600
  • 域名解析到国外服务器会影响国内网站打开速度吗,怎么解决?

    域名解析到国外服务器,确实会影响国内用户的网站打开速度,但影响环节主要在服务器响应和跨境链路,而非“解析动作”本身,很多人把网站打开慢的原因,一股脑归结到“DNS解析”这个动作上,解析只是指路,服务器才是干活的地方,域名解析到国外节点,真正拖慢国内访问速度的,是服务器物理距离远、跨境网络拥堵、以及回源链路长这三……

    2026年10月11日
    000
  • 国内商业银行智能金融是什么,有哪些发展趋势?

    国内商业银行的智能金融转型已不再是单纯的技术升级,而是决定其未来生存与高质量发展的核心战略引擎,核心结论在于:智能金融通过深度重构数据资产、重塑业务流程和重建服务模式,能够有效解决商业银行面临的获客难、风控成本高及运营效率低等痛点,实现从“经验驱动”向“数据驱动”的根本性跨越, 深度客户洞察与精准营销:实现“千……

    2026年2月19日
    26600
  • 电信星辰大模型入口好用吗?星辰大模型怎么用详细教程

    经过半年的深度体验与高频使用,电信星辰大模型入口不仅好用,而且在国产大模型中属于“实用主义”的典型代表,它没有过度追求花哨的娱乐功能,而是将核心聚焦在办公提效、语义理解和安全合规上,对于追求稳定输出和数据处理效率的用户来说,这是一个被低估的生产力工具,其最大的优势在于依托中国电信的天翼云算力底座,响应速度极快且……

    2026年4月7日
    10700
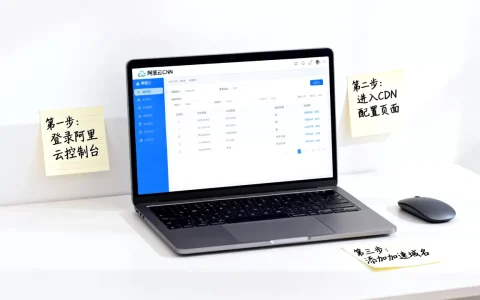
  • 阿里cdn怎么配置?阿里云cdn配置教程详解

    配置阿里云CDN的核心在于完成域名接入、CNAME解析替换以及HTTPS证书绑定,操作路径清晰,通常可在半小时内完成全站加速能力的部署,分发网络(CDN)的本质是将源站资源缓存到离用户最近的边缘节点,对于中小型企业或个人开发者而言,手动配置往往容易在DNS解析或证书链上踩坑,业内专家指出,正确的配置流程能显著降……

    2026年5月28日
    5200
  • 固件签名校验在边缘OTA节点如何落地?有哪些难点?

    固件签名校验在边缘OTA节点上的落地方式,不是把云端校验流程原样搬下来,而是做一次“分层裁剪”——设备端验证完整签名,节点端做轻量预检,云端负责密钥治理和审计,三者各管一段,这套思路背后的现实压力很直接:车联网路侧单元、智能网关、工业控制器这些边缘设备,带宽有限、算力吃紧、网络时断时续,如果每个固件包都要回云端……

    2026年10月9日
    200

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注