大模型异构集群训练怎么看?大模型异构训练难点解析

大模型异构集群训练已成为突破算力瓶颈、降低训练成本的必经之路,其核心在于通过软硬件协同优化,将不同架构、不同性能的计算单元整合为一个高效的计算整体,这不仅是技术层面的工程挑战,更是未来AI基础设施走向弹性与普惠的关键转折点。

关于大模型异构集群训练

异构集群训练是打破算力孤岛的必然选择

在当前大模型研发的浪潮中,算力资源稀缺成为最大拦路虎,传统的同构集群训练模式要求所有芯片型号、内存大小甚至网络带宽完全一致,这种严苛的条件极大限制了算力资源的扩展边界。

  1. 打破硬件壁垒,最大化资源利用率。
    企业在发展过程中往往采购了不同批次的GPU,甚至拥有不同品牌的加速卡,如果坚持同构训练,大量老旧或异构芯片将被迫闲置,异构训练允许将A100、H800甚至国产芯片混合使用,避免了算力浪费。

  2. 降低大模型入局门槛,实现成本最优。
    对于创业公司和研究机构而言,构建大规模同构集群的资金压力巨大,利用存量异构资源进行训练,能够以更低的边际成本完成模型迭代,加速科研创新。

技术挑战:通信墙与负载不均是最大痛点

虽然异构训练前景广阔,但在工程落地中面临着极其复杂的挑战,不同芯片之间的计算能力差异、显存大小差异以及通信带宽差异,直接导致了“木桶效应”。

  1. 通信带宽的不对称性。
    高端卡与低端卡之间的互联带宽往往存在数量级的差异,在分布式训练中,通信时间占比过高会严重拖慢整体迭代速度,如何掩盖通信延迟,是异构训练的首要难题。

  2. 计算能力与显存的碎片化。
    不同芯片的FP16、BF16算力不同,显存容量也参差不齐,如果采用简单的数据并行,算力强的卡需要等待算力弱的卡,导致整体集群效率低下。

    关于大模型异构集群训练

关于大模型异构集群训练,我的看法是这样的:这不仅仅是简单的硬件堆叠,而是一场对分布式并行策略的深度重构,我们不能照搬同构训练的代码逻辑,必须从底层通信和负载均衡上进行定制化开发。

解决方案:构建分层感知的动态调度系统

要解决上述问题,必须建立一套精细化的调度与优化机制,核心策略包括异构感知的并行策略、显存优化技术以及通信掩盖机制。

实施异构感知的流水线并行策略

流水线并行是将模型的不同层分配给不同的设备,天然适合异构场景,我们需要根据设备的计算能力和显存大小,动态调整每个Stage的层数分配。

  • 动态负载均衡: 对于计算能力强的设备,分配更多的层数;对于显存小的设备,分配较少的层数,通过精确测算前向与反向传播的时间,打破“等待时间”,让所有设备尽可能并行工作。
  • 微批次调度优化: 调整Micro-batch的数量和调度顺序,减少流水线气泡,最大化设备利用率。

采用非均匀张量并行与显存卸载技术

对于超大模型,单卡显存往往不足,需要结合张量并行(TP)和ZeRO优化技术。

  • 非均匀切分: 在进行张量并行时,不再平均切分权重矩阵,显存大的设备承载更多的参数切片,显存小的设备承载较少的参数,确保所有设备不会因为OOM(显存溢出)而崩溃。
  • 异构ZeRO优化: 借鉴DeepSpeed ZeRO技术,将优化器状态、梯度和参数根据设备的显存余量进行动态分配存储,极大降低单卡显存压力。

构建统一的通信抽象层与计算掩盖

关于大模型异构集群训练

异构芯片可能涉及不同的通信库(如NCCL、HCCL等),需要构建中间件屏蔽底层差异。

  • 通信掩盖: 在计算过程中预取参数,利用计算时间掩盖通信时间,对于通信带宽较弱的节点,减少其参与全量All-Reduce的频率,或采用分层通信策略。
  • 混合精度适配: 不同芯片对FP16、BF16甚至FP8的支持程度不同,训练框架需要具备动态精度转换能力,在保证模型收敛精度的前提下,适配不同硬件的算力特性。

未来展望:迈向标准化与弹性化

随着大模型技术的演进,异构集群训练将从“权宜之计”转变为“标准配置”。

  1. 训练框架的标准化。 未来的训练框架将原生支持异构硬件的自动发现与拓扑感知,自动生成最优的并行策略,无需人工干预。
  2. 算力生态的融合。 异构训练技术的成熟,将打破单一芯片厂商的垄断,促进国产芯片与主流生态的融合,构建更加健康、多元的算力生态。

大模型异构集群训练是一项高难度的系统工程,它要求算法工程师不仅要懂模型结构,更要懂系统架构,通过异构感知的流水线调度、非均匀参数切分以及通信掩盖技术,我们完全可以消除硬件差异带来的性能损耗。关于大模型异构集群训练,我的看法是这样的,谁能率先攻克异构训练的效率难题,谁就能在算力紧缺的时代掌握主动权,以更低的成本训练出更强大的模型。


相关问答

Q1:异构集群训练会影响模型的最终收敛精度吗?
A1:如果处理得当,不会影响精度,虽然不同芯片的数值精度和计算特性存在差异,但通过混合精度训练策略和梯度补偿机制,可以消除硬件差异带来的数值误差,关键在于训练框架需要对不同硬件的浮点数计算行为进行对齐和校准,确保梯度更新的数学一致性。

Q2:在异构集群中,如何解决老旧显卡拖慢整体训练速度的问题?
A2:核心策略是“负载隔离”与“动态分配”,不要让老旧显卡承担关键路径的计算任务,可以通过流水线并行,将计算量小、通信少的层分配给老旧显卡;或者将其作为纯粹的参数服务器节点,仅负责参数聚合,而不参与前向反向传播,从而避免木桶效应。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/120413.html

(0)
Apache虚拟主机设置怎么操作?Apache配置详细教程
上一篇 2026年3月24日 03:22
3140亿参数大模型值得关注吗?3140亿参数大模型怎么样
下一篇 2026年3月24日 03:25

相关推荐

  • 微服务拆分后容器如何独立发布与回滚?,容器怎么回滚版本

    微服务拆分后,用容器做独立发布与回滚的核心答案是:把每个服务打成不可变镜像,通过容器编排平台单独部署、单独回滚,一次发布只影响一个服务,回滚也只动那一个服务,为什么容器天生适合微服务独立发布镜像就是版本快照微服务拆分前,单体应用发布是一个大包,里面所有功能绑在一起,拆分后,每个服务需要独立版本,容器镜像恰好满足……

    2026年9月10日
    400
  • 根域名服务器负载过高怎么办,根域名服务器负载

    根域名服务器负载并非不可控的灾难,而是通过全球Anycast网络调度、本地递归解析优化及缓存策略调整即可有效缓解的系统性平衡过程,想象一下,根域名服务器就像全球互联网的“总机接线员”,每天,全球有数十亿台设备在询问:“example.com在哪里?”如果这些请求全部直接涌向那13个逻辑根服务器节点,网络瞬间就会……

    2026年5月24日
    4600
  • 数智大模型工作怎么样?揭秘数智大模型工作的真实内幕

    数智大模型在工作场景中的应用,绝非简单的“降本增效”工具,而是一场重塑生产力与生产关系的深度变革,其核心价值在于将人类从重复性劳动中解放出来,转向更高价值的创造性工作,但前提是企业与个人必须跨越技术幻觉、数据孤岛与思维惯性的三重障碍, 数智大模型工作的核心逻辑:从“工具”到“伙伴”的范式转移传统数字化工具本质上……

    2026年3月21日
    11600
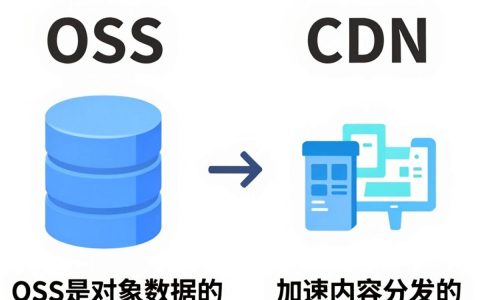
  • oss cdn差别是什么,oss和cdn的区别

    OSS与CDN的核心差别在于:OSS是存储对象数据的“仓库”,负责数据的持久化保存;而CDN是加速内容分发的“快递员”,负责将数据快速推送到离用户最近的边缘节点,两者通常配合使用以实现“存储+加速”的最佳效果,在2026年的云计算架构中,单纯讨论“选哪个”已不再具备实际意义,因为现代业务架构普遍采用“OSS存储……

    2026年6月9日
    4300
  • 中国最大的cdn公司是谁,中国最大的cdn公司

    截至2026年,中国最大的CDN(内容分发网络)公司依然是网宿科技(Wangsu Science & Technology),其在智能边缘计算节点规模、全球覆盖广度及政企定制化服务市场份额上保持行业领先地位,随着2026年AI大模型应用的全面爆发,CDN已不再仅仅是静态资源的加速工具,而是演变为支撑生成……

    2026年5月26日
    10800
  • 亚太cdn峰会2020什么时候举办?亚太cdn峰会2020议程

    亚太CDN峰会2020的核心结论是:全球网络基础设施正从单纯的“加速分发”向“智能边缘计算”转型,以应对后疫情时代激增的实时交互需求,那场在2020年举办的行业盛会,虽然时间上已过去数年,但其确立的技术演进路径,至今仍深刻影响着今天的互联网架构,当时,全球疫情迫使远程办公、在线教育及流媒体服务爆发式增长,传统中……

    2026年6月17日
    2600
  • cdn系统价格是多少,cdn系统价格

    2026年CDN系统价格已从单一的流量计费转向“基础带宽+智能调度+安全服务”的混合模式,中小企业年成本约在3000-8000元,而高并发场景下头部厂商通过阶梯定价可将边际成本降低40%以上,随着2026年AI大模型与边缘计算的深度融合,CDN(内容分发网络)不再仅仅是静态资源的加速器,而是演变为包含AI推理……

    云计算 2026年6月9日
    3800
  • CDN SSR是什么,CDN SSR加速原理

    CDN与SSR并非替代关系,而是互补架构;在2026年的内容分发场景中,最佳实践是将CDN作为边缘缓存层加速静态资源,将SSR(服务端渲染)作为核心业务逻辑层保障首屏加载速度与SEO权重,二者结合可实现毫秒级响应与高并发下的稳定性,技术架构演进:从单一加速到全链路协同在2026年的Web开发语境中,单纯依赖前端……

    2026年7月1日
    2200
  • 酷番云cdn没效果怎么办,酷番云cdn加速无效

    腾讯云CDN加速效果不佳并非技术失效,而是配置策略、源站架构或业务场景与当前网络环境不匹配导致的性能瓶颈,需通过精细化调优解决,在2026年的内容分发网络(CDN)市场中,单纯依赖“开启加速”已无法保证体验,许多用户反馈“没效果”,往往是因为忽视了底层链路中的关键变量,以下将从技术排查、场景适配及成本优化三个维……

    2026年5月25日
    4200
  • cdn分开储存怎么设置,cdn静态资源分离

    CDN分开储存(即动静分离架构)通过物理隔离静态资源与动态数据,能显著提升网站加载速度、降低源站负载并增强安全性,是2026年高并发场景下的标准解决方案,为什么2026年必须采用CDN分开储存策略?在2026年的数字生态中,用户对网页加载速度的容忍度已降至毫秒级,传统的“全栈混合”CDN模式在面对海量静态文件……

    2026年6月12日
    5710

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注