


服务器监控的核心对象是确保服务器硬件、操作系统、应用程序及网络服务的健康、性能、安全与可用性,具体而言,服务器监控涵盖以下关键维度:

硬件资源监控 (基石层)
- CPU 利用率: 持续追踪处理器核心的使用百分比(usr, sys, idle, wait, nice等),目标是识别CPU瓶颈(持续高负载)、调度问题或异常进程,需关注平均负载(Load Average),尤其1分钟、5分钟、15分钟值的对比,判断是瞬时尖峰还是持续压力。
- 内存使用: 监控物理内存(RAM)和交换空间(Swap)的使用量、空闲量、缓存(Cache)和缓冲(Buffer)情况,内存耗尽会导致进程被杀或系统变慢,交换空间频繁使用是严重性能警告信号,需关注可用内存(Available Memory)而非单纯的空闲内存(Free Memory),因为它包含了可回收的缓存/缓冲。
- 磁盘 I/O: 监控磁盘读写速率(吞吐量)、每秒读写操作次数(IOPS)、I/O等待时间(await)、队列长度(avgqu-sz)以及磁盘空间使用率,高延迟或长队列表明磁盘是瓶颈,磁盘空间不足是常见且影响严重的故障点,需设置提前预警。
- 磁盘空间: 实时监控所有挂载点(/, /var, /home, /tmp等)的已用和剩余空间百分比,不仅要关注总量,更要关注关键目录(如日志目录、数据库存储目录)的增长趋势。
- 网络 I/O: 监控每个网络接口的入站/出站流量(带宽)、数据包数量、错误包(errs)、丢弃包(drops)、冲突(collisions)等,流量异常可能预示攻击、配置错误或应用问题;错误和丢包则指向物理层或驱动层故障。
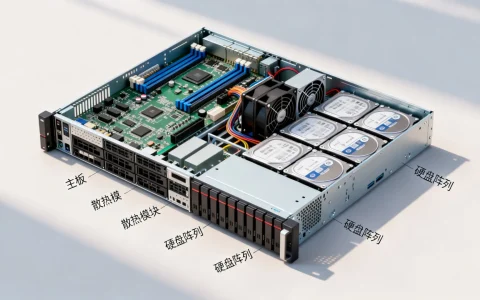
- 温度与风扇: 通过IPMI、BMC或硬件传感器监控CPU、主板、硬盘等关键组件的温度以及风扇转速,过热是硬件故障的前兆,需要立即干预。
- 电源状态: 监控冗余电源状态,确保供电稳定。
操作系统级监控 (运行环境层)
- 进程状态: 监控关键系统进程(如init/systemd, sshd, cron)和应用程序进程的数量、状态(运行、睡眠、僵尸)、CPU/内存占用,僵尸进程累积或关键进程意外退出都是严重问题。
- 系统负载: 结合CPU监控解读Load Average,它反映了等待CPU资源和等待磁盘I/O的进程总数,数值持续高于CPU核心数是系统过载的明确信号。
- 登录与会话: 监控用户登录(成功/失败)情况、当前活跃会话数,异常的登录尝试(尤其root/管理员账户)是安全入侵的重要线索。
- 文件描述符: 系统级和进程级打开的文件描述符数量,耗尽会导致应用无法打开新文件或网络连接。
- 内核参数与错误: 监控系统日志(syslog, dmesg)中的内核消息、错误、告警(OOM Killer事件、硬件错误、文件系统错误等)。
- 关键服务状态: 确保系统必需的后台服务(如NTP时间同步、日志服务rsyslog/syslog-ng/journald)正常运行。
应用程序与服务监控 (业务支撑层)
- 服务可用性: 最基本检查:关键服务(Web Server如Nginx/Apache, 数据库如MySQL/PostgreSQL, 中间件如Redis/RabbitMQ, 应用服务)的端口是否在监听?是否能建立TCP连接?
- 服务健康检查: 超越端口检查,执行应用层健康检查,对Web Server发起HTTP GET请求检查状态码和响应内容;对数据库执行简单查询(
SELECT 1);对API调用特定健康检查端点,返回结果需符合预期。 - 应用性能指标 (APM):
- 响应时间: 端到端处理请求的时间(如HTTP请求响应时间、数据库查询执行时间)。
- 吞吐量: 单位时间内处理的请求数/事务数(如RPS – Requests Per Second, TPS – Transactions Per Second)。
- 错误率: HTTP 5xx/4xx错误率、应用抛出的异常数量/频率、事务失败率。
- 资源消耗: 应用程序进程占用的CPU、内存、线程数、句柄数等。
- 队列深度: 应用内部队列(如消息队列、线程池任务队列)的长度,过长的队列意味着处理能力不足。
- 垃圾回收 (GC – 针对JVM/.NET等): GC频率、持续时间、类型(Minor/Major GC),长时间的Full GC会严重暂停应用。
- 日志监控: 集中采集、解析和分析应用程序日志,利用日志级别(ERROR, WARN)、特定错误关键字、异常堆栈跟踪、业务关键日志条目来快速定位问题根源,结构化日志(如JSON格式)更利于分析。
网络连接与安全监控 (连通与防护层)

- 网络连通性: 监控服务器与关键网关、DNS服务器、上游/下游依赖服务、其他数据中心节点之间的延迟(Ping)和可达性,网络分区是分布式系统的灾难。
- 防火墙状态与规则: 确保防火墙服务运行正常,规则按预期生效,无异常开放端口。
- 入侵检测与可疑活动: 结合系统日志、安全日志(如auth.log)、网络流量分析(NetFlow/sFlow)和专用IDS/IPS工具,检测端口扫描、暴力破解、异常连接模式、已知漏洞利用尝试、恶意软件活动迹象等。
- SSL/TLS 证书: 监控托管在服务器上的网站或服务的SSL/TLS证书有效期,避免证书过期导致服务中断。
业务指标监控 (价值体现层)
- 核心业务交易: 监控关键业务流程的成功率、处理时长、数量(如用户注册、订单提交、支付完成)。
- 关键性能指标 (KPI): 与业务目标直接相关的指标(如网站活跃用户数、API调用量、每秒订单量、实时在线人数)。
- 数据一致性/延迟: 对于涉及数据同步或复制的系统(如数据库主从、缓存与数据库),监控复制延迟、数据一致性校验结果。
构建有效的服务器监控策略:专业见解
仅仅收集数据远远不够,关键在于洞察、预警与行动:
- 定义清晰的基线与阈值: 基于历史数据和业务需求,为每个关键指标设定合理的正常范围(基线)和告警阈值(Warning, Critical),避免“狼来了”的无效告警。
- 分层告警与通知: 区分告警级别(信息、警告、严重、灾难),并配置不同的通知渠道(邮件、短信、IM、电话)和接收人(值班、运维、开发、管理层),确保告警能准确送达责任人。
- 关联分析与根因定位: 当告警触发时,监控系统应能展示相关联的指标变化(如CPU高时,内存、磁盘IO、网络、相关进程情况),帮助快速缩小问题范围,定位根因。
- 可视化与仪表盘: 使用Grafana等工具构建直观的仪表盘,实时展示核心指标状态和趋势,历史数据分析(如PromQL)对于容量规划和性能优化至关重要。
- 自动化与自愈: 对于已知的、可预测的故障模式(如磁盘空间不足触发日志清理脚本、进程僵死触发自动重启),在确保安全的前提下实施自动化响应,缩短故障恢复时间(MTTR)。
- 选择合适的工具栈:
- 指标采集与存储: Prometheus, Zabbix, Nagios, Datadog, InfluxDB + Telegraf
- 日志管理: ELK Stack (Elasticsearch, Logstash, Kibana), Loki, Splunk, Graylog
- 分布式追踪: Jaeger, Zipkin, OpenTelemetry
- APM: New Relic, AppDynamics, Dynatrace, SkyWalking, OpenTelemetry-based solutions
- 可视化: Grafana, Kibana
- 基础设施即代码监控: 结合Terraform, Ansible等配置管理工具,确保监控覆盖新部署的资源。
- 持续优化: 定期审视监控覆盖范围、告警规则的有效性、仪表板的价值,根据业务变化和技术演进调整监控策略。
服务器监控绝非简单的数据收集,而是一个覆盖硬件、系统、应用、网络、安全及业务核心的综合性保障体系,它要求运维团队不仅掌握技术细节,更需要具备业务视角,将海量数据转化为可操作的洞察,通过构建分层、关联、智能化的监控平台,并辅以清晰的告警策略和响应流程,企业方能实现服务器的稳定、高效、安全运行,为业务连续性提供坚实基础。

您的监控实践如何? 在您的环境中,监控服务器时遇到的最大挑战是什么?是告警噪音、根因定位困难、工具整合复杂,还是业务指标难以定义?欢迎在评论区分享您的经验和见解,共同探讨提升服务器可靠性的最佳路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/16434.html




评论列表(3条)
哈,看到这篇讲服务器监控指标的文章,真的忍不住要说一句:太真实了!作为一个掉进无数服务器坑里的老运维,这些指标真是血泪换来的经验啊。 文章里提到的CPU、内存、磁盘I/O、网络这些基础项,绝对是重中之重。我太有体会了!以前就吃过亏,光盯着CPU高不高,结果忽略了内存泄漏,半夜被内存爆满的告警叫起来救火,那感觉简直了。还有磁盘空间,平时看着增长慢不在意,结果日志突然暴涨或者数据库表空间没回收,直接塞满宕机,那种抓狂和后悔… 经历过的人都懂。 另外文章里强调的历史趋势分析也特别同意。只看当前值,你根本不知道是突发高峰还是缓慢恶化。我就试过服务器CPU偶尔冲高一点觉得没事,结果后来才发现是某个进程在偷偷累积资源,最后拖垮整个系统。有历史曲线对比,问题一目了然。 说实话,新手容易犯的错就是要么监控点太少(比如只看能不能Ping通),要么配置了一堆花里胡哨的指标但不会看、没告警。文章总结的这些核心维度确实抓住了要害。监控不是摆设,这些关键指标抓稳了,服务器稳定性才能有保障。踩过坑的人真心觉得,把这几个基础打牢,能少熬很多夜!
作为API开发者,我觉得这些指标太关键了!搞清楚服务器CPU、内存这些状态,才能真正优化API的性能和响应时间,没它不行
@lucky930love:确实,监控CPU和内存是基础!不过,作为细节控,我觉得磁盘I/O和网络延迟也常被忽略,它们直接影响API的响应流畅度,得