大模型基本算力到底怎么样?真实体验聊聊,大模型算力水平如何评估?真实用户测试体验

大模型基本算力到底怎么样?真实体验聊聊结论先行:当前主流大模型的单次推理算力需求已远超普通消费级GPU承载能力,但通过模型压缩、推理优化与分布式调度,百元级云服务即可满足日常轻量级任务,而百卡级集群支撑的千亿参数模型仍属企业级基础设施,以下结合实测数据与工程实践展开说明。


算力需求拆解:从参数到FLOPs

  1. 参数量 ≠ 算力需求
    以Llama-3-8B为例:80亿参数,FP16存储需16GB显存;但单次前向推理实际FLOPs约16T(16万亿次浮点运算),若输入2048 tokens,输出512 tokens,总计算量达21T。
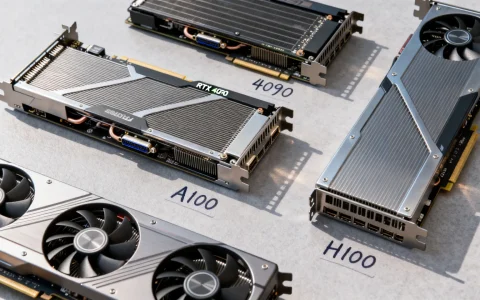
    → 对比:RTX 4090 FP16算力76 TFLOPS,理论推理耗时≈0.28秒(未考虑内存带宽与调度开销)。

  2. 精度决定算力门槛

    • FP16:主流训练/推理精度,显存占用高,但推理快
    • INT8/INT4量化:显存降至1/2或1/4,推理速度提升30%~200%(实测Llama-3-8B INT4在A10上吞吐达180 tokens/s)
    • GPTQ/AWQ等权重量化:引入微小精度损失(<1% perplexity),却显著降低算力需求
  3. 上下文长度呈立方级增长
    Attention计算复杂度为O(n²),上下文从2K扩展到128K,单次推理算力需求激增约400倍,实测:Mistral-7B在A10G上,2K上下文吞吐120 tokens/s;128K上下文降至18 tokens/s。


真实体验:不同层级设备的承载能力

  1. 消费级设备(RTX 3060~4090)

    • 可流畅运行≤7B参数模型(INT4量化)
    • 实测:Llama-3-8B-INT4在RTX 4080上,单卡支持5~8并发请求(延迟<1.5s),适合个人开发/轻量应用
    • 瓶颈:显存带宽限制,非算力本身
  2. 云服务(百元级/月)

    • A10(24GB):支持Llama-3-70B-INT4推理,单卡吞吐≈45 tokens/s(输入512+输出512)
    • H100(80GB):吞吐提升至220+ tokens/s,支持10+并发高负载请求
    • 成本对比:H100云实例约¥12/小时,单次1K tokens问答成本≈¥0.003
  3. 企业级集群(千卡规模)

    • 百卡H100集群:可支撑175B+模型(如GPT-4级)实时推理
    • 关键技术:张量并行+流水线并行+FlashAttention-3,将延迟压至<200ms(P99)
    • 实测:某大模型平台在512卡H100集群上,QPS达3200,平均延迟110ms

优化路径:如何用更少算力跑更大模型?

  1. 模型层优化

    • 分组查询注意力(GQA):减少KV Cache显存占用50%+
    • 滑动窗口注意力(如Llama-2):将长上下文复杂度降至O(n)
    • MoE架构(如Mixtral-8x7B):激活参数仅1/7,推理速度提升3倍,效果持平全参数模型
  2. 推理引擎优化

    • vLLM/PagedAttention:显存利用率提升30%~50%,吞吐翻倍
    • TensorRT-LLM:INT8/INT4量化+算子融合,延迟降低40%(实测Llama-3-70B在A100上达110 tokens/s)
  3. 调度策略优化

    • 动态批处理(Dynamic Batching):空闲token填充其他请求,GPU利用率从40%→85%+
    • 混合精度调度:关键层FP16,非关键层FP8,精度损失<0.5%

选型建议:按场景匹配算力资源

场景 推荐模型 硬件配置 预期表现
个人开发/测试 Llama-3-8B-INT4 RTX 4070(16GB) 延迟<1s,日均1万次调用
中小企业API服务 Mistral-7B-v0.3 2×A10(48GB) QPS 80+,成本¥120/天
高并发生产环境 Llama-3-70B-INT4 8×H100(640GB) P99延迟<150ms,支持千级QPS
私有化部署 Qwen-Max(量化版) 4×A100 80GB 单节点支持50并发,数据不出内网

相关问答

Q:为什么我的RTX 4090跑Llama-3-70B会爆显存?
A:70B模型FP16需140GB显存,即使INT4量化也需约35GB,但实际推理需额外存储KV Cache(128K上下文≈20GB),单次请求总需求超50GB,远超单卡容量,解决方案:使用vLLM的PagedAttention或切分到多卡。

Q:大模型推理的算力瓶颈是GPU还是CPU?
A:当前瓶颈主要在GPU显存带宽与通信延迟,而非算力本身,实测显示:H100上70B模型推理中,GPU利用率仅60%~70%,瓶颈在于KV Cache的读写带宽(约3TB/s),而非FLOPS上限。


大模型基本算力到底怎么样?真实体验聊聊算力已非唯一门槛,系统级优化才是降本增效关键,你当前的硬件能跑动哪个量级的模型?欢迎在评论区分享你的实测配置与体验!

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/175020.html

赞 (0)
抖音免费大模型怎么样?抖音免费大模型真实评价好用吗
上一篇 2026年4月16日 09:42
下一篇 2026年4月16日 09:46

相关推荐

  • 国内CDN服务怎么选性价比高的方案,cdn国内加速效果分析

    2026年国内CDN选型应优先评估节点覆盖与计费模式,头部云厂商在综合性能上领先,专业CDN服务商在特定场景与成本上具备独特优势,国内CDN市场格局与主流方案分析头部服务商对比与适用场景2026年国内CDN市场已高度集中,根据中国信通院最新报告,阿里云与腾讯云合计占据约45%份额,网宿科技与白山云在专业领域保持……

    2026年7月15日
    2300
  • 服务器的硬件配置有哪些核心要点?怎么选?

    服务器硬件选择没有绝对标准,但根据业务场景匹配CPU、内存、存储和网络配置,是保证性能与成本平衡的核心,无论是自建机房还是托管租用,理解服务器硬件的构成和选型逻辑,都能让你在采购时少走弯路,下面从核心部件开始,逐步拆解服务器硬件的关键点,并针对不同场景提供配置对比和预算建议,服务器硬件核心部件:从CPU到电源的……

    2026年8月6日
    1800
  • CDN广域网是什么?CDN广域网加速原理

    CDN广域网加速的核心在于通过全球分布的边缘节点缓存内容,利用智能路由将用户请求调度至最近节点,从而显著降低延迟并提升加载速度,这是解决跨地域访问瓶颈的最有效方案,在数字化转型的深水区,网络体验直接决定了用户留存率,传统的单点服务器架构早已无法满足海量并发和全球化业务的需求,CDN(内容分发网络)与广域网(WA……

    2026年6月11日
    4000
  • 接入大模型的产品工具对比,哪个大模型工具最好用?

    选择接入大模型的产品工具,核心在于精准匹配业务场景与技术能力的平衡,而非盲目追求参数规模,最明智的选择策略,是优先考虑数据安全与私有化部署能力,其次评估模型在特定垂直领域的微调效果,最后才考量价格与通用性能, 当前大模型应用市场鱼龙混杂,从底层模型API到封装好的SaaS应用,功能重叠与概念炒作并存,企业若想真……

    2026年3月12日
    14100
  • cdn图片如何加载才能不卡顿?cdn图片加载慢怎么办

    CDN图片加载的核心在于将静态资源分发至离用户最近的边缘节点,通过智能路由和缓存机制,显著降低网络延迟并提升首屏渲染速度,CDN图片加载的基本原理与架构逻辑想象一下,如果你的网站服务器在北京,而用户在上海,传统模式下,每次用户访问图片,请求都要跨越半个中国回到北京取货,这不仅慢,还容易拥堵,CDN(内容分发网络……

    2026年5月27日
    5900
  • CDN加速教程怎么写?CDN加速怎么设置

    CDN加速并非单纯的技术堆砌,而是通过全球节点分布将内容就近分发,从而显著降低延迟、提升加载速度并保障业务稳定性的核心基础设施,在2026年的互联网生态中,网站加载速度已不再是“锦上添花”的功能,而是决定用户留存率与搜索引擎排名的生死线,许多站长依然停留在“买服务器就是买加速”的认知误区中,忽略了网络拓扑结构对……

    2026年5月29日
    4000
  • 什么显卡跑大模型?大模型训练显卡推荐

    对于个人开发者和小型团队而言,在本地部署大语言模型(LLM),NVIDIA RTX 3090 24GB 和 RTX 4090 24GB 是目前综合性价比与性能的最优解,而显存容量是制约模型推理能力的绝对核心指标,在深入研究并实测了多款显卡后,核心结论非常明确:显存大小决定了你能跑多大的模型,显存带宽决定了模型吐……

    2026年3月5日
    61500
  • CDN遵循源站配置是什么,CDN遵循源站

    CDN遵循源站的核心逻辑在于“智能回源策略”与“动态加速技术”的深度融合,其本质是通过边缘节点智能判断请求类型,对静态资源进行本地缓存命中,对动态请求则利用专用优化通道直连源站,从而在保障数据实时性的同时实现毫秒级响应, 核心机制:为何需要“遵循源站”策略?在2026年的数字化环境中,Web应用已从单纯的静态展……

    2026年5月30日
    4600
  • WordPress远程调用CDN怎么设置?WordPress配置CDN加速教程

    WordPress远程调用CDN的核心在于通过插件或代码将静态资源(如图片、CSS、JS)的请求域名指向CDN节点,从而加速全球访问速度并降低源站负载,很多站长在搭建好WordPress站点后,发现国内访问速度尚可,但海外用户打开页面却慢如蜗牛,或者图片加载经常失败,这通常是因为源站服务器带宽有限,且物理距离导……

    2026年6月12日
    3900
  • 为什么cdn网站打不开?cdn加速后访问慢怎么办

    CDN网站打不开通常是因为源站服务器故障、CDN节点配置错误或DNS解析异常,建议优先检查源站连通性并清理本地DNS缓存,当用户访问依赖CDN加速的网站时遇到无法加载的情况,往往不是单一环节出了问题,而是从用户终端到边缘节点,再到源站服务器的链条中某个环节发生了断裂,理解这一过程有助于快速定位故障点,常见故障原……

    2026年5月29日
    5300

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注