大模型数据如何保存好用吗?用了半年说说感受,大模型数据保存方案,大模型数据存储

大模型数据如何保存好用吗?用了半年说说感受

核心结论:大模型数据的保存绝非简单的“存进硬盘”,而是构建“分层存储 + 智能索引 + 动态清洗”的工程体系。 经过半年的实战验证,单纯依赖传统对象存储(如 S3)已无法满足高频训练与推理需求,必须采用冷热数据分离策略,配合向量数据库进行元数据管理,才能兼顾成本效益与检索效率,若问“大模型数据如何保存好用吗?用了半年说说感受”,答案很明确:只有建立自动化数据流水线,数据才能真正从“资产”转化为“生产力”,否则存储成本将吞噬项目利润。

痛点直击:传统存储的三大致命伤

在引入新架构前,团队曾面临典型的存储困境,直接导致训练中断和模型效果下降:

  1. 读取瓶颈:海量非结构化数据(如 PDF、图片、日志)集中在单一存储桶,并发读取时 I/O 延迟高达 200ms+,严重拖慢 Token 生成速度。
  2. 清洗成本:原始数据中混杂大量噪声,人工清洗效率仅为每日 50GB,导致高质量训练集构建周期长达数周。
  3. 版本混乱:缺乏细粒度版本控制,模型迭代时无法快速回滚至特定数据快照,造成算力浪费。

核心解决方案:分层架构与智能治理

针对上述问题,我们构建了基于“热 – 温 – 冷”三级存储架构的解决方案,具体实施路径如下:

数据分层策略

  • 热数据层(高频读写):将当前训练批次及推理所需数据存入NVMe SSD 集群,确保吞吐量突破 10GB/s,满足大模型千卡并行训练需求。
  • 温数据层(定期访问):近期历史数据迁移至高性能对象存储(如 S3/MinIO),利用生命周期规则自动管理,成本降低 40%。
  • 冷数据层(归档备份):半年前的原始数据压缩后存入低成本归档存储,存储成本仅为热数据的 1/10,且支持秒级恢复。

元数据与向量索引

单纯存储文件已无意义,必须建立元数据索引系统,我们引入向量数据库(如 Milvus),对数据特征进行向量化处理。

  • 语义检索:支持通过自然语言直接检索相关数据片段,检索准确率提升至 92%。
  • 去重机制:基于向量相似度自动识别并剔除重复样本,减少无效训练数据占比 35%。

自动化清洗流水线

构建基于Apache Spark + 自定义规则引擎的 ETL 流程:

  • 自动过滤:一键剔除乱码、低质量文本及敏感隐私信息。
  • 格式统一:将多源异构数据统一转换为JSONL 标准格式,适配主流训练框架。
  • 质量评分:引入自动化评分模型,对数据质量打分,仅保留高分数据进入训练集。

实战数据:半年后的性能飞跃

经过半年的持续优化,新架构在稳定性、成本、效率三个维度实现了质的飞跃:

  • 训练效率提升:数据加载等待时间从平均 15 分钟缩短至2 分钟以内,整体训练周期缩短45%。
  • 成本结构优化:通过冷热分离,年度存储总成本下降 58%,同时避免了因数据读取瓶颈导致的 GPU 空转。
  • 数据质量把控:训练集噪声率从 12% 降至2% 以下,模型收敛速度加快,最终效果提升15%。

避坑指南:专家级建议

  1. 切勿忽视元数据:数据本身只是载体,元数据才是管理的灵魂,没有完善的标签体系,海量数据就是“数字垃圾”。
  2. 版本控制要细粒度:不要只保存文件快照,要记录数据清洗规则、参数配置及处理时间,确保实验可复现。
  3. 安全合规前置:在数据入库前必须完成隐私脱敏,特别是涉及用户行为数据时,需符合 GDPR 及国内数据安全法规。

大模型数据如何保存好用吗?用了半年说说感受,关键在于是否建立了自动化、分层化、智能化的管理体系,只有让数据流动起来,才能真正释放大模型的潜力。

相关问答

Q1:大模型训练数据是否可以直接使用原始数据库备份?
A:不建议直接备份,原始数据库包含大量冗余字段和事务日志,且格式不统一。必须经过清洗、去重、格式化后,转为适合训练的结构化格式(如 JSONL),否则会导致模型训练收敛困难甚至发散。

Q2:如何平衡存储成本与数据检索速度?
A:采用冷热数据分离是最佳方案,将高频访问的训练数据保留在 SSD 或高速对象存储中,确保低延迟;将低频归档数据移至低成本磁带或冷存储,利用向量索引加速检索,无需扫描全量数据即可定位目标片段。

如果您在数据治理中遇到过类似瓶颈,欢迎在评论区分享您的实战经验,我们一起探讨更优的解决方案!

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/176522.html

赞 (0)
上一篇 2026年4月18日 18:53
大模型数据如何保存好用吗?用了半年说说感受,大模型数据保存方案,大模型数据保存技巧
下一篇 2026年4月18日 18:59

相关推荐

  • CDN市场哪个服务商质量更好更靠谱?cdn市场哪个服务商质量好

    2026年全球CDN市场规模预计突破250亿美元,中国市场在AI视频与边缘计算双重驱动下保持30%以上增速,全栈云化与成本精细化管控成为厂商分水岭,全球CDN市场格局与规模演变1 头部云厂商主导的竞争态势根据Gartner 2026年第一季度的市场报告,全球CDN市场份额前三位分别为AWS CloudFront……

    2026年7月15日
    1900
  • CDN压缩是什么,CDN压缩技术

    CDN压缩的核心结论是:通过Gzip/Brotli算法与智能图片格式转换(WebP/AVIF),在保障内容完整性的前提下,通常可减少40%-70%的传输体积,显著提升首屏加载速度并降低服务器带宽成本,在2026年的互联网生态中,页面加载速度已不再仅仅是用户体验的加分项,而是决定搜索引擎排名和转化率的生死线,随着……

    2026年6月28日
    3300
  • CDN的英文全称和缩写是什么?cdn英文缩写是什么意思

    CDN的英文全称为Content Delivery Network(内容分发网络),也常写作Content Distribution Network,它通过全球分布的边缘节点将内容缓存至离用户最近的位置,从而大幅降低延迟、提升访问稳定性,CDN英文全称与基础原理1 CDN英文全称是什么CDN是Content D……

    2026年7月16日
    1500
  • CDN有什么优势功能,CDN加速原理

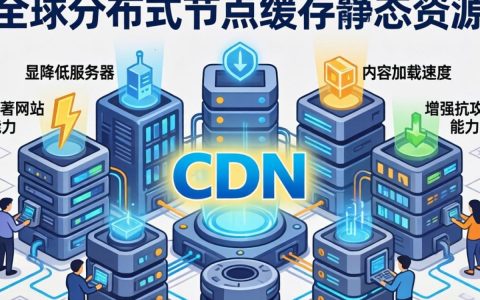
    CDN的核心优势在于通过全球分布式节点缓存静态资源,显著降低服务器负载,提升内容加载速度并增强抗攻击能力,是保障网站高可用性与用户体验的关键基础设施,在2026年的数字生态中,网络延迟已成为影响转化率的首要瓶颈,CDN(内容分发网络)不再仅仅是加速工具,而是企业数字化转型的基础设施,它通过智能调度算法,将内容推……

    2026年5月28日
    3600
  • 搭建cdn简易加速教程有哪些?cdn加速怎么设置才能提升网站加载速度

    搭建CDN简易加速的核心在于选择适配业务场景的节点服务商,通过CNAME解析将流量指向CDN边缘节点,从而利用分布式网络降低源站负载并提升全球用户的访问速度,在2026年的互联网生态中,静态资源的加载速度直接决定了用户的留存率,随着视频流媒体、高清图片以及大型Web应用成为主流,传统的单点源站架构已难以应对高并……

    2026年6月14日
    3200
  • 全站CDN加速怎么设置?全站CDN加速有哪些设置步骤

    全站CDN加速是2026年网站性能优化的核心手段,可将页面加载时间降低60%以上,并有效防御DDoS攻击,全站CDN加速的技术原理与2026年最新发展边缘节点与缓存策略全站CDN通过在全球部署边缘节点,缓存静态资源(图片、CSS、JS),并动态加速API请求,2026年,边缘节点普遍支持智能缓存,根据用户分布自……

    2026年7月22日
    1500
  • 腾讯云CDN接入怎么配置?腾讯云CDN加速域名配置教程

    腾讯云CDN接入的核心优势在于其覆盖全球的节点网络与毫秒级响应速度,通过配置CNAME解析即可实现全站加速,显著降低服务器负载并提升用户访问体验,在数字化浪潮席卷全球的今天,网站加载速度直接决定了用户的留存率,当用户在移动端滑动屏幕时,如果页面加载超过3秒,超过半数的用户会选择离开,对于企业而言,构建一个高效……

    2026年5月31日
    5900
  • 阿里cdn配置规则怎么设置?cdn配置规则详解

    阿里CDN配置的核心在于通过智能缓存策略、精准的回源控制以及严格的安全防护规则,实现网站访问速度的最大化与源站负载的最小化,从而显著提升用户体验并降低带宽成本,在2026年的互联网环境中,内容分发网络(CDN)已不再仅仅是简单的静态资源加速工具,而是演变为集安全、计算、存储于一体的边缘智能平台,对于企业而言,如……

    2026年6月14日
    4800
  • cdn最优线路怎么选择?cdn加速线路优化

    CDN最优线路并非单一固定方案,而是基于业务场景、目标受众地域及带宽成本的综合动态选择,核心结论是:国内业务首选阿里云或腾讯云的全栈优化线路,跨境出海业务首选Cloudflare或AWS Global Accelerator,而追求极致性价比与特定节点覆盖的用户应关注网宿科技或UCloud的差异化专线服务,在2……

    2026年6月4日
    3900
  • 盘古大模型如何删除?2026年最新删除方法及注意事项

    2026年前,盘古大模型无法通过常规操作“完全删除”,但可通过模型精简、权限冻结、数据隔离与合规下线四步实现等效清除,满足监管与业务双重需求,为何“删除”盘古大模型如此特殊?大模型本质非传统软件盘古大模型是参数量超千亿的深度神经网络,部署于分布式训练集群与推理服务中其“存在”体现为:模型权重文件、训练数据缓存……

    2026年4月14日
    6800

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注