


服务器监测源码是企业IT基础设施稳定运行的神经中枢,是运维团队洞察系统健康、预防故障、保障业务连续性的核心利器,它超越了简单的状态检查,通过定制化、源码级的监控能力,赋予运维人员对服务器环境最深层次的可见性和控制力。

核心价值:源码级监控的不可替代性
为什么选择源码而非单纯依赖现成的监控工具?关键在于深度、灵活性与所有权。
- 深度定制,精准匹配业务需求: 现成工具往往提供通用指标(CPU、内存、磁盘、网络),源码监测允许你:
- 监控特定应用进程: 精确追踪关键业务应用的资源消耗、线程状态、队列深度等。
- 采集自定义业务指标: 例如订单处理速率、特定API响应时间、缓存命中率、队列积压量等直接影响用户体验和业务收入的指标。
- 集成特有系统或设备: 对接内部开发的中间件、老旧系统或专用硬件设备,提取其特有的状态信息。
- 完全掌控,安全自主:
- 数据主权: 所有监控数据完全掌握在自己手中,规避第三方SaaS服务的数据隐私和合规风险。
- 无供应商锁定: 避免因服务商变更、功能限制或费用调整带来的被动。
- 安全审计: 源码可审计,确保监控逻辑本身无后门或安全隐患,符合严格的安全合规要求。
- 极致优化,资源高效:
- 按需采集: 只采集真正需要的指标,避免冗余数据带来的存储和网络开销。
- 轻量级部署: 精心编写的源码监测代理可以非常轻量,对生产服务器性能影响极小。
- 高效传输与存储: 可自定义数据压缩、聚合策略,优化数据传输效率和存储成本。
关键技术实现:构建源码监测的核心骨架
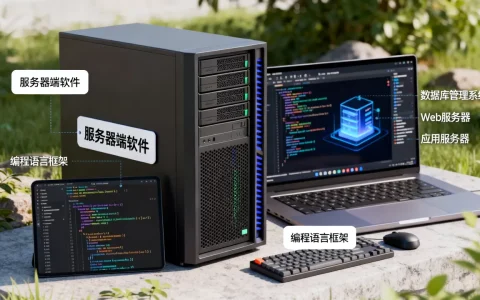
一个健壮的服务器监测源码通常包含以下关键组件和技术栈:
- 数据采集层 (Agent):
- 语言选择: Python (psutil, requests 等库丰富)、Go (高并发、部署简单)、Bash (快速脚本)、C/C++ (极致性能),选择取决于对性能、资源消耗和开发效率的要求。
- 核心能力:
- 系统指标: 利用操作系统API (如
/proc,sysctl, WMI, Performance Counters) 获取CPU、内存、磁盘I/O、网络流量、进程列表等。 - 应用指标: 通过应用暴露的JMX端点、HTTP API (如
/metrics)、日志文件解析、TCP/UDP端口探测、甚至直接连接应用内部队列/缓存来获取数据。 - 自定义脚本执行: 执行特定脚本获取返回值作为指标。
- 系统指标: 利用操作系统API (如
- 示例 (Python snippet – 获取进程CPU/Mem):
import psutil
def get_process_stats(process_name):
    for proc in psutil.process_iter(['name', 'cpu_percent', 'memory_info']):
        if proc.info['name'] == process_name:
            return {
                'cpu_percent': proc.info['cpu_percent'],
                'rss_mb': proc.info['memory_info'].rss / (1024  1024)  # RSS in MB
            }
    return None  # Process not found
- 数据传输层:
- 协议: 常用高效协议包括:
- Prometheus Pull: 监测目标暴露HTTP端点 (
/metrics),由中心服务器定时拉取,简单,但需目标可达。 - Pushgateway (瞬时任务): 适合生命周期短的作业将指标推送到网关,Prometheus再从网关拉取。
- StatsD: UDP协议,轻量级,适合高频指标推送,接收端需聚合 (如Telegraf + InfluxDB)。
- 直接写入TSDB: Agent直接将数据写入时序数据库 (如 InfluxDB, TimescaleDB, OpenTSDB) 的HTTP API。
- 消息队列 (Kafka, RabbitMQ): 高吞吐、解耦、缓冲,Agent推送数据到队列,消费者处理入库。
- Prometheus Pull: 监测目标暴露HTTP端点 (
- 序列化格式: Prometheus text format, InfluxDB line protocol, JSON 等,需与后端存储兼容。
- 协议: 常用高效协议包括:
- 数据存储与处理层:
- 时序数据库 (TSDB): 专门为处理时间序列数据优化,是监控数据的天然归宿。
- 主流选择: Prometheus (生态强大,查询语言PromQL灵活), InfluxDB (高性能,功能丰富), TimescaleDB (基于PostgreSQL的TSDB扩展)。
- 数据处理 (可选但重要):
- 聚合: 在Agent端或流处理层 (如 Flink, Spark Streaming) 进行初步聚合,减少存储压力。
- 规则引擎: 实时计算衍生指标或进行初步判断 (如计算5分钟负载平均值)。
- 时序数据库 (TSDB): 专门为处理时间序列数据优化,是监控数据的天然归宿。
- 告警引擎:
- 核心逻辑: 持续查询TSDB或监听数据流,根据预定义的规则 (阈值、波动率、持续时间、组合条件) 判断是否触发告警。
- 关键能力:
- 分级告警: 根据严重性 (Warning, Critical) 通知不同人员/渠道。
- 告警收敛/降噪: 避免告警风暴 (如分组、抑制、静默)。
- 多通知渠道: 集成邮件、短信、电话、Slack、钉钉、Webhook等。
- 常用工具: Prometheus Alertmanager (与Prometheus天然集成), Grafana Alerting (可视化强), 或自研基于规则引擎的告警模块。
- 可视化与分析层:
- 仪表盘: Grafana 是事实标准,支持多种数据源 (Prometheus, InfluxDB, Graphite 等),提供强大的图表和面板定制能力。
- 日志关联 (Optional): 将指标异常与同一时间段的日志信息关联分析 (如 ELK Stack, Loki),加速根因定位。
- 趋势分析: 利用TSDB的历史数据进行容量规划、性能瓶颈分析。
专业级解决方案:从源码到可靠系统

构建源码监测系统不仅是写代码,更是系统工程:
- 设计原则:
- 高可用: Agent、传输链路、存储、告警引擎均需冗余设计,避免单点故障导致监控失效。
- 可扩展性: 架构设计应能轻松应对服务器数量和监控指标的增长。
- 安全性: Agent与Server通信加密 (TLS),访问控制 (认证/授权),最小权限原则。
- 资源隔离: 监控系统自身资源消耗可控,不影响生产业务。
- 部署与配置管理:
- Agent部署: 使用配置管理工具 (Ansible, SaltStack, Puppet, Chef) 或容器化 (Docker) 批量部署、升级Agent。
- 配置即代码: Agent配置、告警规则、仪表盘定义等应使用代码 (YAML, JSON) 管理,纳入版本控制 (Git),实现自动化部署和审计。
- 性能调优:
- 采集频率: 平衡实时性与资源消耗,关键指标高频率,辅助指标可降低。
- 指标基数控制: 避免使用高基数的标签 (如用户ID、请求ID) 作为指标标签,防止TSDB爆炸。
- 数据保留策略: 根据业务需求和存储成本设置合理的数据保留周期。
- 开源生态整合:
- Prometheus + Grafana + Alertmanager: 黄金组合,覆盖采集、存储、告警、可视化全栈,社区活跃,插件丰富,源码Agent主要实现暴露
/metrics端点。 - Telegraf (采集) + InfluxDB (存储) + Grafana (展示) + Kapacitor (处理/告警): 另一个强大且高性能的组合。
- 利用 Exporter: Prometheus 生态有大量现成的 Exporter (如 node_exporter 用于主机监控, mysql_exporter, redis_exporter),可以快速集成,源码监测常用于补充Exporter无法覆盖的自定义指标。
- Prometheus + Grafana + Alertmanager: 黄金组合,覆盖采集、存储、告警、可视化全栈,社区活跃,插件丰富,源码Agent主要实现暴露
安全与最佳实践:让源码监测坚如磐石
- 最小权限原则: Agent运行账户仅拥有采集必要信息的最小权限。
- 传输加密: 所有组件间通信强制使用 TLS/SSL。
- 输入验证与过滤: 对Agent接收的配置指令或写入的数据进行严格校验,防止注入攻击。
- 定期审计与更新: 审计监控系统自身的日志和配置,及时更新依赖库和组件修补安全漏洞。
- 监控“监控系统”自身: 对监控系统的各个组件(数据库、告警服务、可视化服务)进行监控,确保其健康运行。
- 文档与知识沉淀: 详细记录监控指标含义、告警规则逻辑、系统架构和运维手册,这是专业性和可信度的体现。
超越监控:洞察与价值
优秀的服务器监测源码不仅是故障的“灭火器”,更是优化和决策的“导航仪”:
- 性能优化: 通过历史趋势分析,识别资源瓶颈,指导容量规划和性能调优。
- 成本控制: 精确监控资源利用率,发现闲置或低效资源,优化云资源或硬件投入。
- 提升用户体验: 将后端服务器性能指标(如API延迟、错误率)与前端用户体验关联,快速定位影响用户的问题。
- 驱动DevOps文化: 监控数据透明化,促进开发、运维、测试团队对系统行为的共同理解,加速反馈循环。
掌握源码,掌握主动权

服务器监测源码的构建是一项需要专业知识和工程化思维的任务,但其带来的深度洞察力、灵活控制权和数据自主性,对于追求稳定性、安全性和业务连续性的现代企业至关重要,它不是对开源或商业监控方案的替代,而是一种强大的补充和深化,当您拥有源码级监控能力,意味着您真正拥有了洞察服务器“心跳”的钥匙,能够在复杂多变的IT环境中主动出击,防患于未然。
您目前在服务器监控方面面临的最大挑战是什么?是海量指标的管理、精准告警的设置,还是对特定业务场景的深度监控需求?欢迎分享您的实践经验或遇到的难题,共同探讨更优的解决方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/18587.html




评论列表(3条)
这篇文章把服务器监控源码比作运维的“神经中枢”,挺贴切的。不过作为产业链视角的关注者,我觉得源码获取和监控实现背后,其实牵动着整个上下游的一串环节。 说说我的观察吧: 1. 上游选择决定源码获取路径:企业想“获取源码”,首先得看选型。用开源方案(比如Prometheus生态)?源码就在那儿,但二次开发和运维成本得自己扛。选商业方案(如Zabbix企业版、云厂商的监控服务)?核心源码一般不开放,但能享受稳定支持和服务。这本质上是用“控制权”换“便利性”的选择题。 2. 中游集成商是落地关键:很多企业不是直接拿源码就用,尤其传统行业。系统集成商(SI)或者运维服务商在这里作用巨大。他们把监控工具“翻译”成客户能用的方案,源码级定制(比如加个特定硬件驱动监控、对接老业务系统)往往靠他们来实现。这活是真功夫,也体现了服务附加值。 3. 下游催生新需求,推动工具进化:现在业务对高可用的要求越来越高(想想电商大促、在线支付),倒逼监控工具变得更“聪明”。光看CPU内存不够了,得能关联日志、追踪链路、甚至预测故障。这种需求传导到上游,让开源社区和商业公司都在往AIOps、可观测性方向迭代,源码的能力边界也在拓宽。 个人觉得,文章强调源码“深层掌控”的价值没错,但对大多数企业来说,比源码更重要的是监控数据的“消费能力”。运维团队能否从海量指标中快速定位问题?开发能否利用性能数据优化代码?业务能否感知系统波动?这涉及到数据整合、告警策略、可视化、团队协作等一整条“消费链”。源码只是工具,用好数据才是目的。 另外提一句,现在云原生和容器化流行,监控的颗粒度和维度变了(比如K8s Pod监控),搞传统物理机/虚拟机监控的团队也得跟着变,源码层面的技能树也得更新,不然容易吃老本。
这篇文章写得真透彻!作为公关人,我深知服务器故障常引发业务危机,源码监控就像预警雷达,能提前掐灭隐患火苗,非常实用。
虽然作为萌新看不懂源码细节,但这篇文章把服务器监控原理讲得超清晰,对运维小白太有用了,点赞支持!