构建Hive数据仓库的核心在于将分散的业务数据通过ETL流程标准化入库,利用Hive SQL进行离线分析,最终为BI报表和机器学习提供高质量的数据底座。
在2026年的数据治理环境下,企业不再单纯追求存储量的扩张,而是转向数据资产的精细化运营,Hive作为基于Hadoop的数据仓库工具,依然承担着连接底层分布式存储与上层应用的关键角色,许多团队在初期搭建时,常因表结构设计不当导致查询缓慢,或因权限管理混乱引发数据泄露,一套规范化的构建流程至关重要。
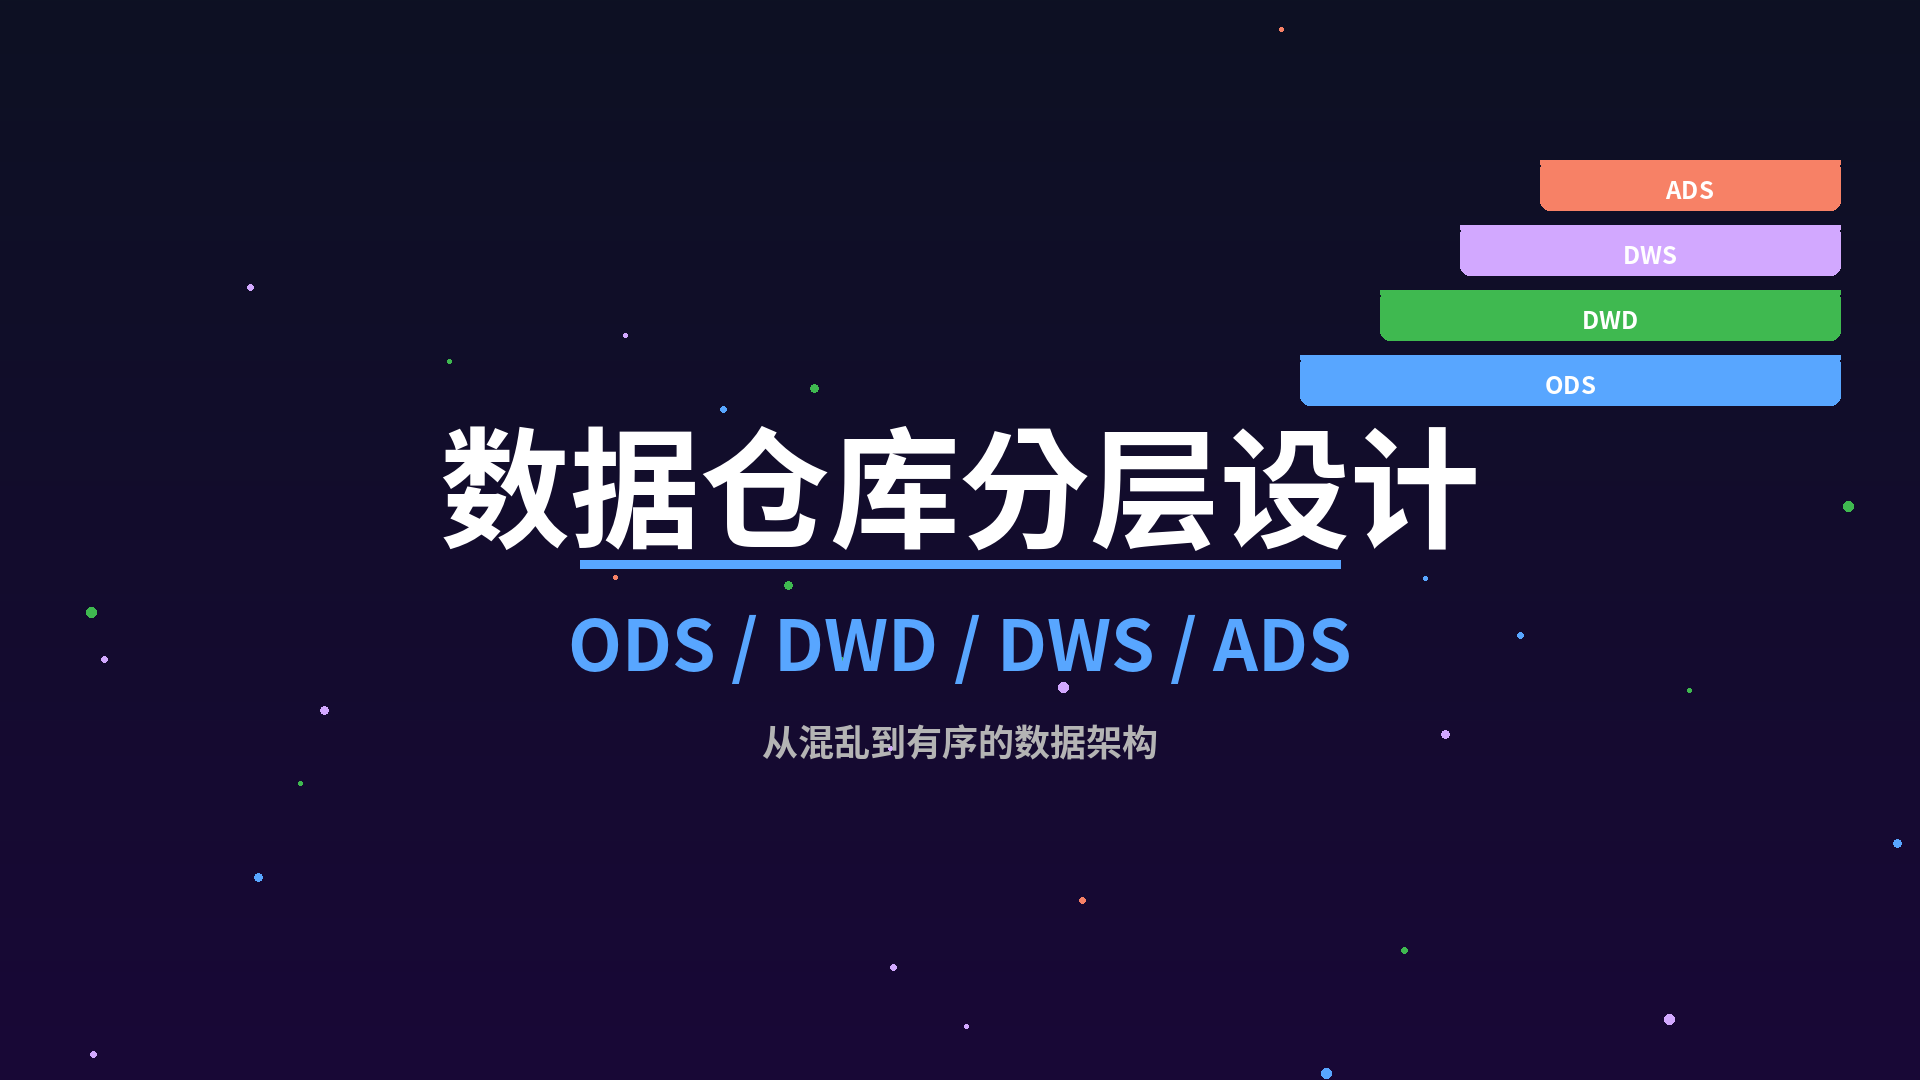

Hive数据仓库分层架构设计详解
业内专家指出,合理的分层架构是解决数据混乱的根本方案,通常采用ODS、DWD、DWS、ADS四层架构,每一层都有明确的职责边界。
ODS层:原始数据接入与清洗
ODS层(Operational Data Store)直接对接业务数据库或日志文件,这一层的核心任务是保持数据的原始面貌,仅做轻微的格式转换。
- 数据源对接:使用Sqoop或Flume将MySQL、Oracle中的增量数据同步至HDFS。
- 分区策略:必须按天或小时进行分区,例如
dt=20260101,以便后续快速过滤数据。 - 文件存储:推荐使用ORC或Parquet格式,相比CSV或TextFile,列式存储能显著减少I/O开销。
DWD层:明细数据标准化
DWD层(Data Warehouse Detail)是数据仓库的核心,这里需要进行数据清洗、脱敏和标准化。
- 数据清洗:去除重复记录、空值填充、异常值过滤。
- 维度退化:将常用的维度字段(如用户姓名、城市)冗余到事实表中,避免关联查询。
- 统一编码:确保所有业务实体ID在全局范围内唯一且一致。
DWS层:轻度汇总与聚合
DWS层(Data Warehouse Summary)面向主题域进行轻度汇总,按用户维度汇总每日行为日志,按商品维度汇总销售数据。

- 宽表构建:将多个事实表关联,形成大宽表,提升查询效率。
- 指标计算:预计算常用指标,如UV、PV、转化率等,减少实时计算压力。
ADS层:应用数据服务
ADS层(Application Data Service)直接面向应用层,这里的数据通常经过高度聚合,直接服务于报表或API接口。
- 数据导出:将结果数据同步至MySQL、Elasticsearch或HBase,供前端展示。
- 权限控制:实施严格的行列级权限管理,确保敏感数据不被越权访问。
Hive性能优化实战技巧
在实际操作中,Hive大数据处理性能优化是运维人员最常遇到的痛点,查询慢往往不是因为数据量大,而是执行计划不合理。
小文件合并与分区裁剪
HDFS对小文件支持不佳,大量小文件会导致NameNode内存压力巨大。
- 合并策略:在ETL任务结束后,执行
ALTER TABLE ... CONCATENATE命令合并小文件。 - 分区裁剪:查询时必须带上分区字段,避免全表扫描。
SELECT FROM user_log WHERE dt='20260101'。
Join优化与倾斜处理
数据倾斜是Hive查询慢的主要原因之一,当某个Key的数据量远大于其他Key时,会导致单个Reduce任务处理时间过长。
- MapJoin:对于小表关联大表的情况,开启
hive.auto.convert.join=true,让Hive自动选择MapJoin,避免Shuffle。 - 倾斜Key处理:对倾斜Key加随机前缀,打散数据后再聚合,最后去除前缀进行二次聚合。
并行执行与内存调优
- 并行执行:设置
hive.exec.parallel=true
,允许同一SQL中相互独立的Stage并行执行。
- 内存分配:根据集群资源调整
hive.exec.reducers.bytes.per.reducer,通常设置为256MB或512MB,避免产生过多或过少的Reduce任务。

常见Hive数据仓库搭建误区对比
许多团队在构建Hive数据仓库搭建误区时,容易陷入以下陷阱,导致后期维护成本极高。
| 误区类型 | 错误做法 | 正确做法 | 影响分析 |
|---|---|---|---|
| 表结构设计 | 所有数据存入一张大宽表 | 按主题域分层建模 | 大宽表导致查询慢、存储浪费 |
| 数据更新 | 频繁使用INSERT OVERWRITE全量覆盖 | 采用增量合并或ACID事务 | 全量覆盖导致历史数据丢失或计算冗余 |
| 权限管理 | 使用默认public权限 | 实施基于角色的访问控制(RBAC) | 数据泄露风险高,审计困难 |
| 监控告警 | 无监控,依赖用户反馈 | 建立任务运行监控与数据质量校验 | 问题发现滞后,影响业务决策 |
Hive数据仓库维护与治理规范
构建只是开始,维护才是长久之计,数据治理需要贯穿数据生命周期的始终。

元数据管理
- 数据字典:维护完整的表结构说明、字段含义、负责人信息。
- 血缘分析:利用工具追踪数据从源头到应用的流转路径,便于问题排查。
数据质量监控
- 完整性检查:监控关键表的数据量波动,异常波动触发告警。
- 一致性校验:定期比对源系统与数仓数据,确保数据一致。
成本优化
- 冷热数据分离:将近期数据存储在高性能存储介质,历史数据归档至低成本存储。
- 生命周期管理:设置数据保留策略,自动清理过期数据,降低存储成本。
Q&A:Hive数据仓库常见问题解答
如何选择合适的Hive存储格式?
业内共识认为,ORC和Parquet是Hive数据仓库的主流选择,ORC在Hive生态中兼容性更好,支持更丰富的压缩算法;Parquet在跨平台兼容性上更优,适合与Spark、Presto等引擎配合使用,若追求极致查询性能且数据量巨大,Parquet是更佳选择;若主要使用Hive SQL且注重压缩比,ORC更为合适。
Hive与Spark SQL在数据仓库中的定位有何不同?
Hive擅长离线批处理,适合T+1的报表生成和数据挖掘,其MapReduce引擎虽然较慢,但稳定性高,Spark SQL则基于内存计算,适合交互式查询和实时性要求较高的场景,在实际架构中,通常将Hive作为底层数据仓库存储,Spark SQL作为上层计算引擎,两者互补。
如何解决Hive查询中的数据倾斜问题?
解决数据倾斜的核心思路是打散热点Key,具体操作包括:开启MapJoin减少Shuffle数据量;对倾斜Key添加随机前缀,将数据分散到多个Reduce节点;调整Reduce任务数量,增加并行度,检查数据源是否存在脏数据,如大量空值或默认值,也应一并处理。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/234343.html