HTML网站整站抓取工具的核心价值在于通过自动化脚本批量获取网页源码,从而为SEO审计、竞品分析及离线归档提供结构化数据,建议优先选择支持深度配置与反爬策略的开源或商业软件。
在数字化营销与技术开发领域,快速获取网站结构信息已成为基础需求,无论是SEO专员需要分析竞争对手的TDK设置,还是开发者需要调试前端代码,手动复制粘贴不仅效率低下,且容易遗漏深层页面,整站抓取工具便成为了连接互联网数据与本地分析环境的桥梁,这类工具并非简单的下载器,而是能够模拟浏览器行为、解析动态内容并建立本地文件索引的智能爬虫。

主流HTML网站整站抓取工具对比与选型
市面上工具种类繁多,从命令行工具到图形界面软件,从开源免费到商业付费,选择哪一款取决于具体的使用场景和技术背景,业内专家指出,没有绝对完美的工具,只有最适合当前任务需求的方案。
命令行工具:适合开发者与自动化流程
对于熟悉Linux命令行的技术人员来说,HTTrack 和 wget 是绕不开的经典选择,HTTrack是一款老牌且强大的开源离线浏览器,它不仅能抓取HTML页面,还能递归地下载图片、CSS和JavaScript文件,保持原有的目录结构,其优势在于完全免费、跨平台,且支持复杂的过滤规则,例如只抓取特定后缀的文件或排除特定域名。
相比之下,wget 更加轻量级,常用于服务器端的批量下载任务,虽然它默认不处理复杂的JavaScript渲染,但配合参数如 -r(递归)和 -l(深度限制),可以高效地抓取静态资源,对于需要集成到CI/CD流程中的团队,wget的脚本友好性使其成为首选。
图形界面工具:适合SEO专家与非技术人员
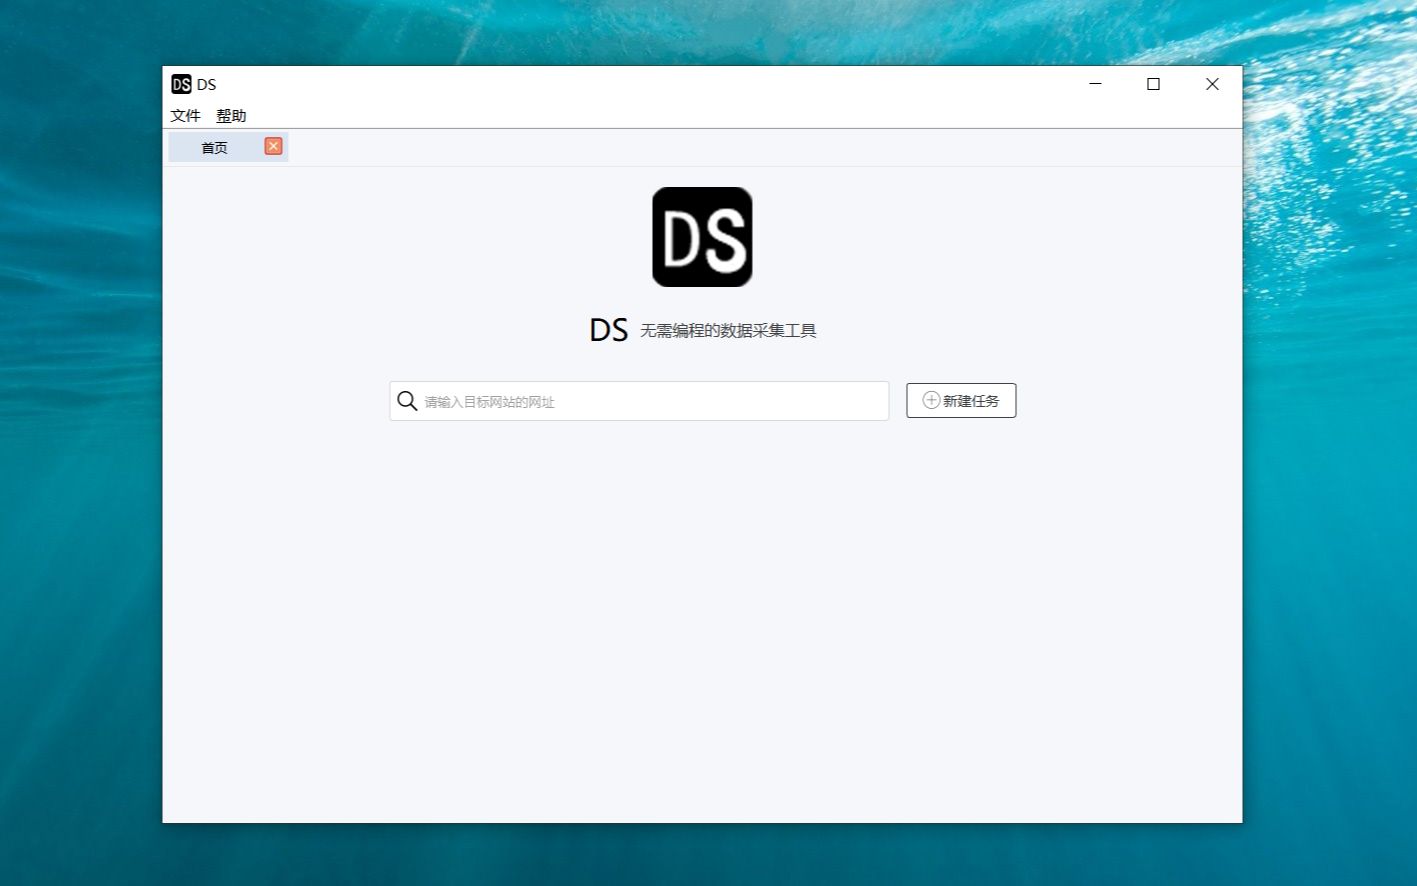
如果用户更倾向于可视化操作,Teleport Pro 或 SiteSucker 等商业软件提供了更友好的体验,这类工具通常具备“预览”功能,用户可以在抓取前预览网站结构,实时调整抓取深度和范围,对于SEO从业者而言,这类工具往往内置了简单的分析报告,能直接生成HTML文件列表,方便后续使用正则表达式或Python脚本进行二次分析。
值得注意的是,商业软件通常提供更好的技术支持和更新频率,尤其在应对现代网站的反爬机制时,其内置的代理轮换和User-Agent池功能往往比开源工具更稳定。
如何选择合适的HTML整站抓取工具进行SEO分析
在进行SEO竞品分析时,抓取的目标不仅仅是HTML源码,更包括页面结构、内部链接关系以及元数据,选型时需重点考察工具对动态内容的处理能力。
静态与动态内容的抓取差异
传统的抓取工具基于HTTP请求,只能获取服务器返回的初始HTML,现代网站大量使用JavaScript框架(如React、Vue)渲染内容,如果工具不支持无头浏览器(Headless Browser)技术,抓取到的页面将是空的或仅有骨架结构。
选择建议:
- 若目标网站为纯静态HTML或PHP生成,HTTrack或wget即可满足需求。
- 若目标网站依赖前端框架动态加载内容,需选择支持Selenium、Puppeteer或Playwright集成的工具,或具备内置无头浏览器功能的商业软件。
反爬策略与稳定性考量
许多大型网站部署了WAF(Web应用防火墙)或复杂的验证码机制,在抓取过程中,频繁的请求可能导致IP被封禁。
- 代理支持:优质工具应支持配置HTTP/HTTPS代理池,分散请求来源。
- 请求间隔控制:允许设置随机延迟,模拟人类浏览行为,降低被检测风险。
- 断点续传:对于大型网站,抓取过程可能耗时数小时,断点续传功能能避免因网络波动导致的前功尽弃。
实操指南:使用HTTrack进行整站抓取的步骤
HTTrack因其开源特性和强大功能,成为许多SEO分析师的首选,以下是基于HTTrack的标准操作流程,帮助用户快速构建本地镜像站点。
第一步:项目配置与范围设定
启动HTTrack后,首先创建新项目,在此阶段,需明确抓取范围:
- 起始URL:输入目标网站的根域名。
- 目录结构:建议勾选“保持原始目录结构”,以便后续分析链接关系。
- 抓取深度:根据需求设置递归深度,一般SEO分析建议设置为3-5层,过深可能导致抓取到大量无关的后台页面或分页内容。
第二步:高级选项与过滤规则
在“高级”选项卡中,进行精细化控制:
- 文件类型过滤:在“允许的文件类型”中,仅保留
.html,.htm,.css,.js,.jpg,.png等必要资源,排除.pdf,.doc等无关文件,以节省存储空间和带宽。 - 排除规则:在“排除的文件类型”或“排除的URL”中,加入
admin,login,wp-admin等关键词,避免抓取后台管理系统。
第三步:执行抓取与结果验证
点击“开始”后,工具将自动运行,抓取过程中,建议观察日志输出,检查是否有大量403(禁止访问)或404(未找到)错误,若出现大量错误,需检查代理设置或调整User-Agent。
抓取完成后,本地将生成一个与网站结构完全一致的文件夹,可使用本地服务器(如Nginx或Python的SimpleHTTPServer)在本地启动该镜像,通过浏览器访问,验证动态链接是否可用,以及图片、样式是否完整加载。
HTML网站整站抓取工具的价格与授权模式解析
在预算有限的情况下,许多用户关注HTML整站抓取工具的价格问题,市场呈现出明显的两极分化。
开源免费工具的局限性与优势
HTTrack、wget等开源工具完全免费,且代码透明,安全性较高,其劣势在于缺乏图形界面,配置复杂,且对动态网页的支持较弱,对于预算为零的个人开发者或小型团队,这是最佳起点。
商业软件的价值主张
商业软件如Teleport Pro、SiteSucker等,通常采用一次性买断或订阅制,其价格范围从几十美元到几百美元不等,高价软件的优势在于:
- 技术支持:提供官方文档和客服响应。
- 功能增强:支持更复杂的反爬绕过、API集成及批量任务管理。
- 稳定性:经过大量用户测试,崩溃率极低。
对于企业级用户,若需高频次、大规模抓取,购买商业授权或定制开发爬虫系统可能是更经济的选择,因为时间成本远高于软件授权费。
常见问题解答
HTML网站整站抓取工具能抓取需要登录才能访问的内容吗?
部分高级工具支持模拟登录,用户需先在工具中配置Cookie或表单提交数据,模拟用户登录状态,然后启动抓取,HTTrack支持通过代理或脚本注入Cookie,但需要注意的是,这种操作可能违反网站的服务条款,且技术门槛较高,需谨慎使用。
抓取下来的HTML文件如何分析SEO问题?
抓取完成后,可将HTML文件导入SEO分析工具(如Screaming Frog SEO Spider),Screaming Frog支持直接导入本地HTML文件夹,从而分析内部链接、重定向链、Meta标签缺失等问题,这种方式无需在线爬取,数据隐私性更好,且能避免触发目标网站的反爬机制。
抓取工具抓取的页面与浏览器看到的一致吗?
若网站大量使用JavaScript渲染,传统抓取工具抓取的HTML可能缺失关键内容,需使用支持无头浏览器的工具,或手动在浏览器中查看“页面源代码”与“网络请求”中的API返回数据,对于SEO分析而言,若核心内容在源码中不可见,则搜索引擎也无法索引,抓取此类数据对SEO优化意义有限。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/362865.html