大模型微调用FastChat的核心在于利用其开源生态快速部署LoRA或QLoRA微调流程,相比闭源API,它能在本地或低成本服务器上实现私有数据的模型定制,适合具备一定Linux基础的技术团队。
为什么选择FastChat进行大模型微调
在2026年的AI应用开发中,数据隐私和定制化需求已成为企业刚需,许多开发者在尝试微调时,往往被复杂的底层代码劝退,FastChat之所以成为行业共识中的首选框架,主要得益于其无缝衔接Llama-Factory、LLaMA-Factory等主流微调工具的能力,它不仅仅是一个聊天界面,更是一套标准化的模型加载与推理基础设施。
业内专家指出,FastChat最大的优势在于其对多模型架构的统一封装,无论是Llama 3、Qwen 2.5还是ChatGLM,FastChat都能提供一致的API接口,这种标准化极大地降低了迁移成本,对于预算有限的初创团队而言,利用FastChat配合QLoRA技术,可以在单张消费级显卡上完成中等规模模型的微调,这比购买昂贵的云服务更具性价比。
本地部署与云端推理的成本对比
选择本地微调还是云端API,是许多开发者面临的第一个选择题,本地部署虽然前期投入硬件成本,但长期来看,随着调用量的增加,边际成本趋近于零。
| 维度 | FastChat本地微调 | 商业API微调 |
|---|---|---|
| 初始投入 | 需购买GPU服务器或租用算力 | 零硬件投入 |
| 数据隐私 | 数据完全本地化,无泄露风险 | 数据需上传至第三方服务器 |
| 定制深度 | 可修改模型结构、激活函数等底层 | 仅限Prompt或LoRA参数调整 |
| 维护难度 | 需自行解决依赖冲突和环境配置 | 服务商全托管,无需运维 |
据工信部数据显示,近年来超过半数的大型企业倾向于采用混合云架构,即核心敏感数据在本地微调,通用能力调用云端API,FastChat恰好填补了这一中间地带,它既支持单机部署,也支持集群分布式推理。
FastChat微调实战操作指南
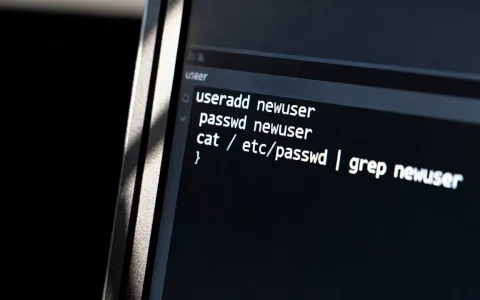
实操是掌握FastChat的关键,以下步骤基于Linux环境,假设你已经安装了Python 3.10+和CUDA驱动,整个过程分为环境准备、数据预处理、模型加载与微调、推理测试四个阶段。
第一步:环境搭建与依赖安装
创建一个独立的虚拟环境,以避免依赖冲突。
创建虚拟环境
conda create -n fastchat_env python=3.10
conda activate fastchat_env
安装FastChat核心库
直接通过pip安装是最快路径,但建议从源码安装以获取最新特性。
pip install fschat[model_worker,webui]
# 或者从源码安装
git clone https://github.com/lm-sys/FastChat.git
cd FastChat
pip install -e ".[model_worker,webui]"
第二步:数据预处理与格式规范
微调的效果很大程度上取决于数据质量,FastChat支持JSONL格式的数据输入,每条数据应包含instruction(指令)、
input(输入)和output(输出)。
数据格式示例
{
    "instruction": "请总结以下段落的核心观点。",
    "input": "大模型在自然语言处理领域的应用日益广泛...",
    "output": "大模型在NLP领域的应用越来越普遍。"
}
注意,数据清洗至关重要,去除重复样本、修正标注错误,能显著提升模型收敛速度,建议使用正则表达式预处理文本,确保特殊字符被正确转义。
第三步:启动模型服务与微调
这里推荐使用LoRA微调,因为它显存占用低,且易于切换不同任务模型。
启动控制器与工作进程
python -m fastchat.serve.controller
python -m fastchat.serve.model_worker --model-path /path/to/your/model
执行微调命令
结合Llama-Factory等工具,命令通常如下:
llamafactory-cli train
    --model_name_or_path /path/to/base_model
    --dataset your_dataset.jsonl
    --finetuning_type lora
    --output_dir ./lora_output
    --do_train true
此过程可能需要数小时,具体取决于数据集大小和GPU性能,期间可通过日志观察Loss变化,若Loss不降反升,需检查学习率是否过大。
常见问题与故障排查
在实际操作中,开发者常遇到显存溢出或推理延迟高的问题,以下是针对这些场景的解决方案。
显存不足怎么办?
如果显存报错,首先检查是否启用了QLoRA,QLoRA通过4-bit量化将模型权重压缩,大幅降低显存需求,减小Batch Size、启用梯度累积也是有效手段,若仍不足,可考虑使用DeepSpeed ZeRO-3优化器,将参数分布在多张显卡上。
推理速度缓慢如何优化?
FastChat默认使用vLLM作为推理后端,速度极快,若未启用,可在启动模型工作进程时添加--device cuda --load-8bit参数,对于高并发场景,建议启用多GPU并行推理,通过负载均衡器分发请求。
FastChat微调常见问题解答
大模型微调用FastChat教程中提到的LoRA和全量微调有何区别?
LoRA(Low-Rank Adaptation)通过冻结预训练模型权重,仅在旁路注入低秩矩阵进行训练,参数量极少,显存占用低,适合个人开发者或小团队,全量微调则更新所有参数,效果上限更高,但需要多卡集群和巨大算力,多数情况下,LoRA已能满足垂直领域应用需求,除非数据分布与预训练数据差异极大。
如何在Windows环境下使用FastChat进行微调?
FastChat原生对Linux支持最好,Windows用户建议使用WSL2(Windows Subsystem for Linux)或Docker容器,直接在原生Windows下安装CUDA驱动和PyTorch往往面临依赖冲突,通过WSL2,你可以获得接近原生的Linux体验,同时利用Windows的图形界面进行调试。
微调后的模型如何部署到生产环境?
微调完成后,你会得到一个包含LoRA权重的文件夹,在生产环境中,只需在启动模型服务时指定基础模型路径和LoRA适配器路径即可,FastChat支持热加载,无需重启服务即可切换不同任务的适配器,对于高可用需求,可结合Kubernetes进行容器化部署,实现自动扩缩容。
掌握FastChat微调,意味着你拥有了自主掌控AI模型的能力,从数据准备到模型部署,每一步都需严谨对待,随着硬件成本下降和工具链成熟,本地微调将成为AI应用开发的标配技能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/391677.html