vLLM部署大模型显存占用过高怎么办?如何优化显存占用

vLLM通过PagedAttention技术将显存碎片化问题降至最低,配合连续批处理,能在同等硬件下实现2-3倍的吞吐量提升,是降低大模型部署成本的最优解。

在2026年的今天,大模型落地早已过了“能跑就行”的阶段,企业更关注的是如何在有限的GPU资源下跑出更高的性价比,很多团队在部署LLM时,常遇到显存溢出(OOM)或吞吐量上不去的瓶颈,这往往不是硬件不够强,而是显存管理机制没理顺,vLLM之所以成为主流选择,核心在于它重新设计了内存管理逻辑,让显存利用效率发生了质变。
【2026最新版】这绝对是B站唯一将vLLM推理优化从入门到精通讲明白的教程,一个视频学懂VLLM内部原理,KV Cache,PageAttention
加载中
【2026最新版】这绝对是B站唯一将vLLM推理优化从入门到精通讲明白的教程,一个视频学懂VLLM内部原理,KV Cache,PageAttention

vLLM显存优化的核心机制解析

要理解如何优化,首先得知道vLLM到底做了什么,传统的Transformer推理引擎通常采用静态内存分配,即预先分配好所有可能的最大显存,这导致大量显存被闲置,形成严重的碎片化,vLLM引入了PagedAttention算法,借鉴了操作系统中虚拟内存管理的分页思想。

分页注意力机制的工作原理

在PagedAttention中,KV Cache(键值缓存)不再是一块连续的显存块,而是被划分为多个物理块,每个请求的序列被映射到这些不连续的物理块上,这种设计带来了两个直接好处:

  • 消除内部碎片:每个块的大小固定,不再因为序列长度微小差异而浪费空间。
  • 支持动态分配:随着序列生成,新的块按需分配,用完后立即释放,显存利用率显著提升。
  • vLLM部署大模型显存占用过高怎么办?如何优化显存占用

业内专家指出,这种机制使得vLLM在长文本场景下的显存占用比传统引擎降低约30%-50%,具体数值取决于序列长度和并发请求数。

连续批处理(Continuous Batching)

传统的批处理需要等待一批请求全部完成才能开始下一批,这造成了GPU的空闲等待时间,vLLM实现了连续批处理,允许在推理过程中动态加入新请求,并在旧请求结束时立即释放其资源,这种细粒度的调度方式,让GPU始终处于高负载状态,避免了“等米下锅”的尴尬。

实战部署中的显存调优策略

理论再好,落地才是关键,在实际生产环境中,如何配置参数以最大化显存效率?以下是经过验证的操作路径。

量化技术的正确应用

量化是降低显存占用的最直接手段,对于2026年的主流模型,INT8甚至INT4量化已经非常成熟,且对精度影响极小。

INT8量化部署步骤

  1. 模型转换:使用vLLM支持的量化后端(如AWQ或GPTQ),将FP16模型转换为INT8格式。
  2. 启动参数配置:在启动vLLM服务时,添加--quantization awq--quantization gptq参数。
  3. 验证精度:使用标准测试集验证量化后的模型输出质量,确保业务指标无显著下降。

据统计,INT8量化可将模型权重显存占用减半,同时保持较高的推理速度,对于显存紧张的场景,这是首选方案。

vLLM部署大模型显存占用过高怎么办?如何优化显存占用

KV Cache内存池配置

vLLM允许用户手动控制KV Cache的最大大小,如果配置不当,可能导致OOM或资源浪费。

  • --gpu-memory-utilization参数:该参数控制vLLM占用的GPU显存比例,默认值为0.9,建议设置为0.85-0.9,预留少量显存给系统和其他进程。
  • --max-num-batched-tokens参数:限制单次批处理的最大token数,对于长文本场景,适当调低此值可增加并发请求数,避免单个长请求独占显存。

显存监控与动态调整

部署后,需实时监控显存使用情况,可使用nvidia-smi命令或Prometheus+Grafana监控面板,观察显存峰值和波动情况,若发现显存频繁波动,可尝试调整--max-num-seqs参数,限制最大并发序列数。

不同场景下的显存优化对比

不同的业务场景对显存的需求差异巨大,以下是几种典型场景的优化建议及效果对比。

高并发短文本场景

此类场景(如客服问答、即时翻译)特点是请求量大、序列短,优化重点在于提高吞吐量。

  • 策略:启用连续批处理,适当增加--max-num-batched-tokens
  • 效果:吞吐量可提升2-3倍,显存利用率接近饱和。

长文本分析场景

vLLM部署大模型显存占用过高怎么办?如何优化显存占用

此类场景(如文档摘要、代码生成)特点是序列长、KV Cache占用大,优化重点在于减少KV Cache碎片。

  • 策略:使用PagedAttention,启用INT8量化,限制单序列最大长度。
  • 效果:显存占用降低40%以上,支持更长的上下文窗口。

多模态场景的特殊处理

对于多模态大模型,除了文本KV Cache,还需考虑图像编码器的显存占用,建议将图像编码与文本生成解耦,先预计算图像特征,再复用,避免重复计算带来的显存峰值。

常见问题与解答

vLLM部署大模型显存占用优化有哪些具体参数推荐?

推荐核心参数组合:--gpu-memory-utilization 0.85--quantization awq(若支持),--max-num-batched-tokens 4096,具体数值需根据硬件规模和业务负载微调。

vLLM相比传统推理引擎在显存管理上有何优势?

vLLM通过PagedAttention消除显存碎片,通过连续批处理提高GPU利用率,传统引擎因静态分配导致大量显存闲置,而vLLM实现动态按需分配,显存效率提升显著。

如何判断当前vLLM部署是否已达到显存优化极限?

--gpu-memory-utilization设置为0.9时,若吞吐量不再随并发增加而线性提升,且显存使用率稳定在高位,说明已接近优化极限,此时可考虑增加GPU数量或优化模型架构。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/401085.html

(0)
Magento主题模板安装失败怎么办?详细图文安装教程
上一篇 2026年6月19日 14:46
DigiCert SSL证书类型有哪些?DigiCert证书值得购买吗
下一篇 2026年6月19日 14:49

相关推荐

  • 大模型部署容灾备份方案

    大模型部署容灾备份的核心在于构建“本地高可用+异地冷备+实时同步”的三层架构,确保在单点故障或灾难发生时,业务中断时间控制在分钟级,数据丢失率为零,当企业将大模型从实验阶段推向生产环境,稳定性就不再是加分项,而是生存底线,想象一下,你的核心业务逻辑完全依赖一个千亿参数的大模型,突然服务器宕机,或者机房遭遇火灾……

    2026年6月18日
    2500
  • in_array函数到底怎么用,有哪些常见问题及注意事项

    在PHP开发中,in_array函数是检查数组中是否存在某个值的最常用方法,但它的性能在大数组中会显著下降,合理使用严格模式或选择替代方案如isset能够有效提升代码效率,in_array基础用法与常见误区基本语法和参数in_array用法非常直观,只需要三个参数:要搜索的值(needle)、被搜索的数组(ha……

    2026年8月18日
    600
  • 服务器和客户端接口怎么测?接口测试工具和方法有哪些

    服务器和客户端接口的测试核心在于构建独立的Mock服务模拟后端,通过自动化脚本模拟真实请求并校验响应数据,从而在开发早期发现逻辑缺陷,接口测试是连接前端交互与后端逻辑的桥梁,也是保障系统稳定性的关键环节,很多团队容易陷入“只测前端页面”或“等到上线前才联调”的误区,导致问题堆积,高效的接口测试能显著降低修复成本……

    2026年7月5日
    20100
  • llama.cpp编译安装失败怎么办?llama.cpp编译安装教程

    llama.cpp 的核心优势在于无需 GPU 即可通过 CPU 高效运行大语言模型,其编译安装过程虽涉及 CMake 工具链配置,但掌握正确参数后,普通开发者也能在本地快速构建出高性能推理环境,在本地部署大模型已成为许多开发者和爱好者的刚需,尤其是当云端 API 成本过高或数据隐私成为顾虑时,llama.cp……

    2026年6月18日
    2700
  • 大模型AI底层逻辑是什么?大模型AI底层逻辑详解

    大模型AI的底层逻辑本质上是基于海量数据训练的统计概率预测,通过Transformer架构中的注意力机制捕捉上下文关联,将自然语言转化为高维向量进行数学运算,最终输出最可能的下一个字符或 token,很多人误以为AI拥有像人类一样的“意识”或“理解力”,实际上它更像是一个超级复杂的“文本接龙”高手,它并不真正知……

    2026年6月13日
    3900
  • FreeSCALE是什么品牌?FreeSCALE芯片型号大全及价格

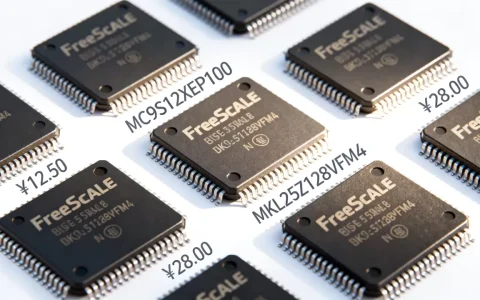
    “FreeScale” 通常指的是 Freescale Semiconductor(飞思卡尔半导体),这是一家知名的半导体公司,专注于微控制器(MCU)、传感器、处理器和其他半导体解决方案,Freescale 以其在汽车电子、工业应用、消费电子和通信设备领域的创新技术而闻名,Freescale Semicond……

    2026年7月12日
    14100
  • 服务器连接磁盘阵列柜失败怎么办?服务器连接磁盘阵列柜教程

    服务器连接磁盘阵列柜的核心在于通过HBA卡或RAID控制器建立物理链路,并配合正确的驱动配置与多路径软件实现高可用性与性能优化,这是构建企业级存储架构的基础环节,在数据中心或企业机房中,服务器与存储设备之间的连接往往被视为“黑盒”操作,许多运维人员习惯于点击几个按钮就完成挂载,却对底层的连接逻辑缺乏深入理解,当……

    2026年7月8日
    18800
  • 为什么不能定义包含多个字段的RECORD类型常量,怎么解决?

    is_null()_U0100035错误的核心原因是Oracle PL/SQL中不允许定义包含多个字段的RECORD类型常量,你需要改用变量或使用单字段RECORD来绕过这一限制,is_null()_U0100035错误怎么解决:RECORD常量多字段问题这个错误通常出现在使用is_null函数检查RECORD……

    2026年8月5日
    900
  • IT行业数据分析怎么做,分析数据的方法有哪些?

    IT行业数据分析的核心是理解业务逻辑,并围绕数据采集、清洗、建模到可视化这一完整链路,选择匹配的工具与方法来驱动决策,而非单纯追求技术复杂性,IT行业数据分析怎么做?从业务需求到数据洞察很多刚入行的朋友会问,IT行业数据分析到底从哪下手,其实不管你是分析服务器日志、用户行为还是产品运营数据,都绕不开下面几个环节……

    2026年8月16日
    900
  • IIS默认网站停止怎么办,IIS服务启动不了是什么原因?

    当IIS默认网站停止或IIS服务无法启动时,最直接的解决路径是:先确认World Wide Web Publishing服务状态,再检查默认站点的绑定和应用程序池,最后通过iisreset命令或服务管理器重启IIS,IIS默认网站停止怎么恢复?从诊断到修复先确认服务本身是否“活着”打开服务管理器(service……

    2026年8月13日
    800

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注