大模型的精确率与召回率并非越高越好,而是需要在业务场景中寻找平衡点:追求高精确率意味着结果更准但可能漏掉信息,追求高召回率则意味着抓得全但噪音更多,核心在于根据具体需求设定阈值。
在人工智能落地应用的深水区,我们不再单纯迷信“智商”高低,而是开始审视大模型在具体任务中的表现稳定性,精确率(Precision)和召回率(Recall)是衡量这种稳定性的两把尺子,很多开发者在调试模型时,容易陷入“既要又要”的误区,试图同时拉高这两个指标,却忽略了它们之间天然的博弈关系,理解这一对概念,是构建可靠AI应用的第一步。
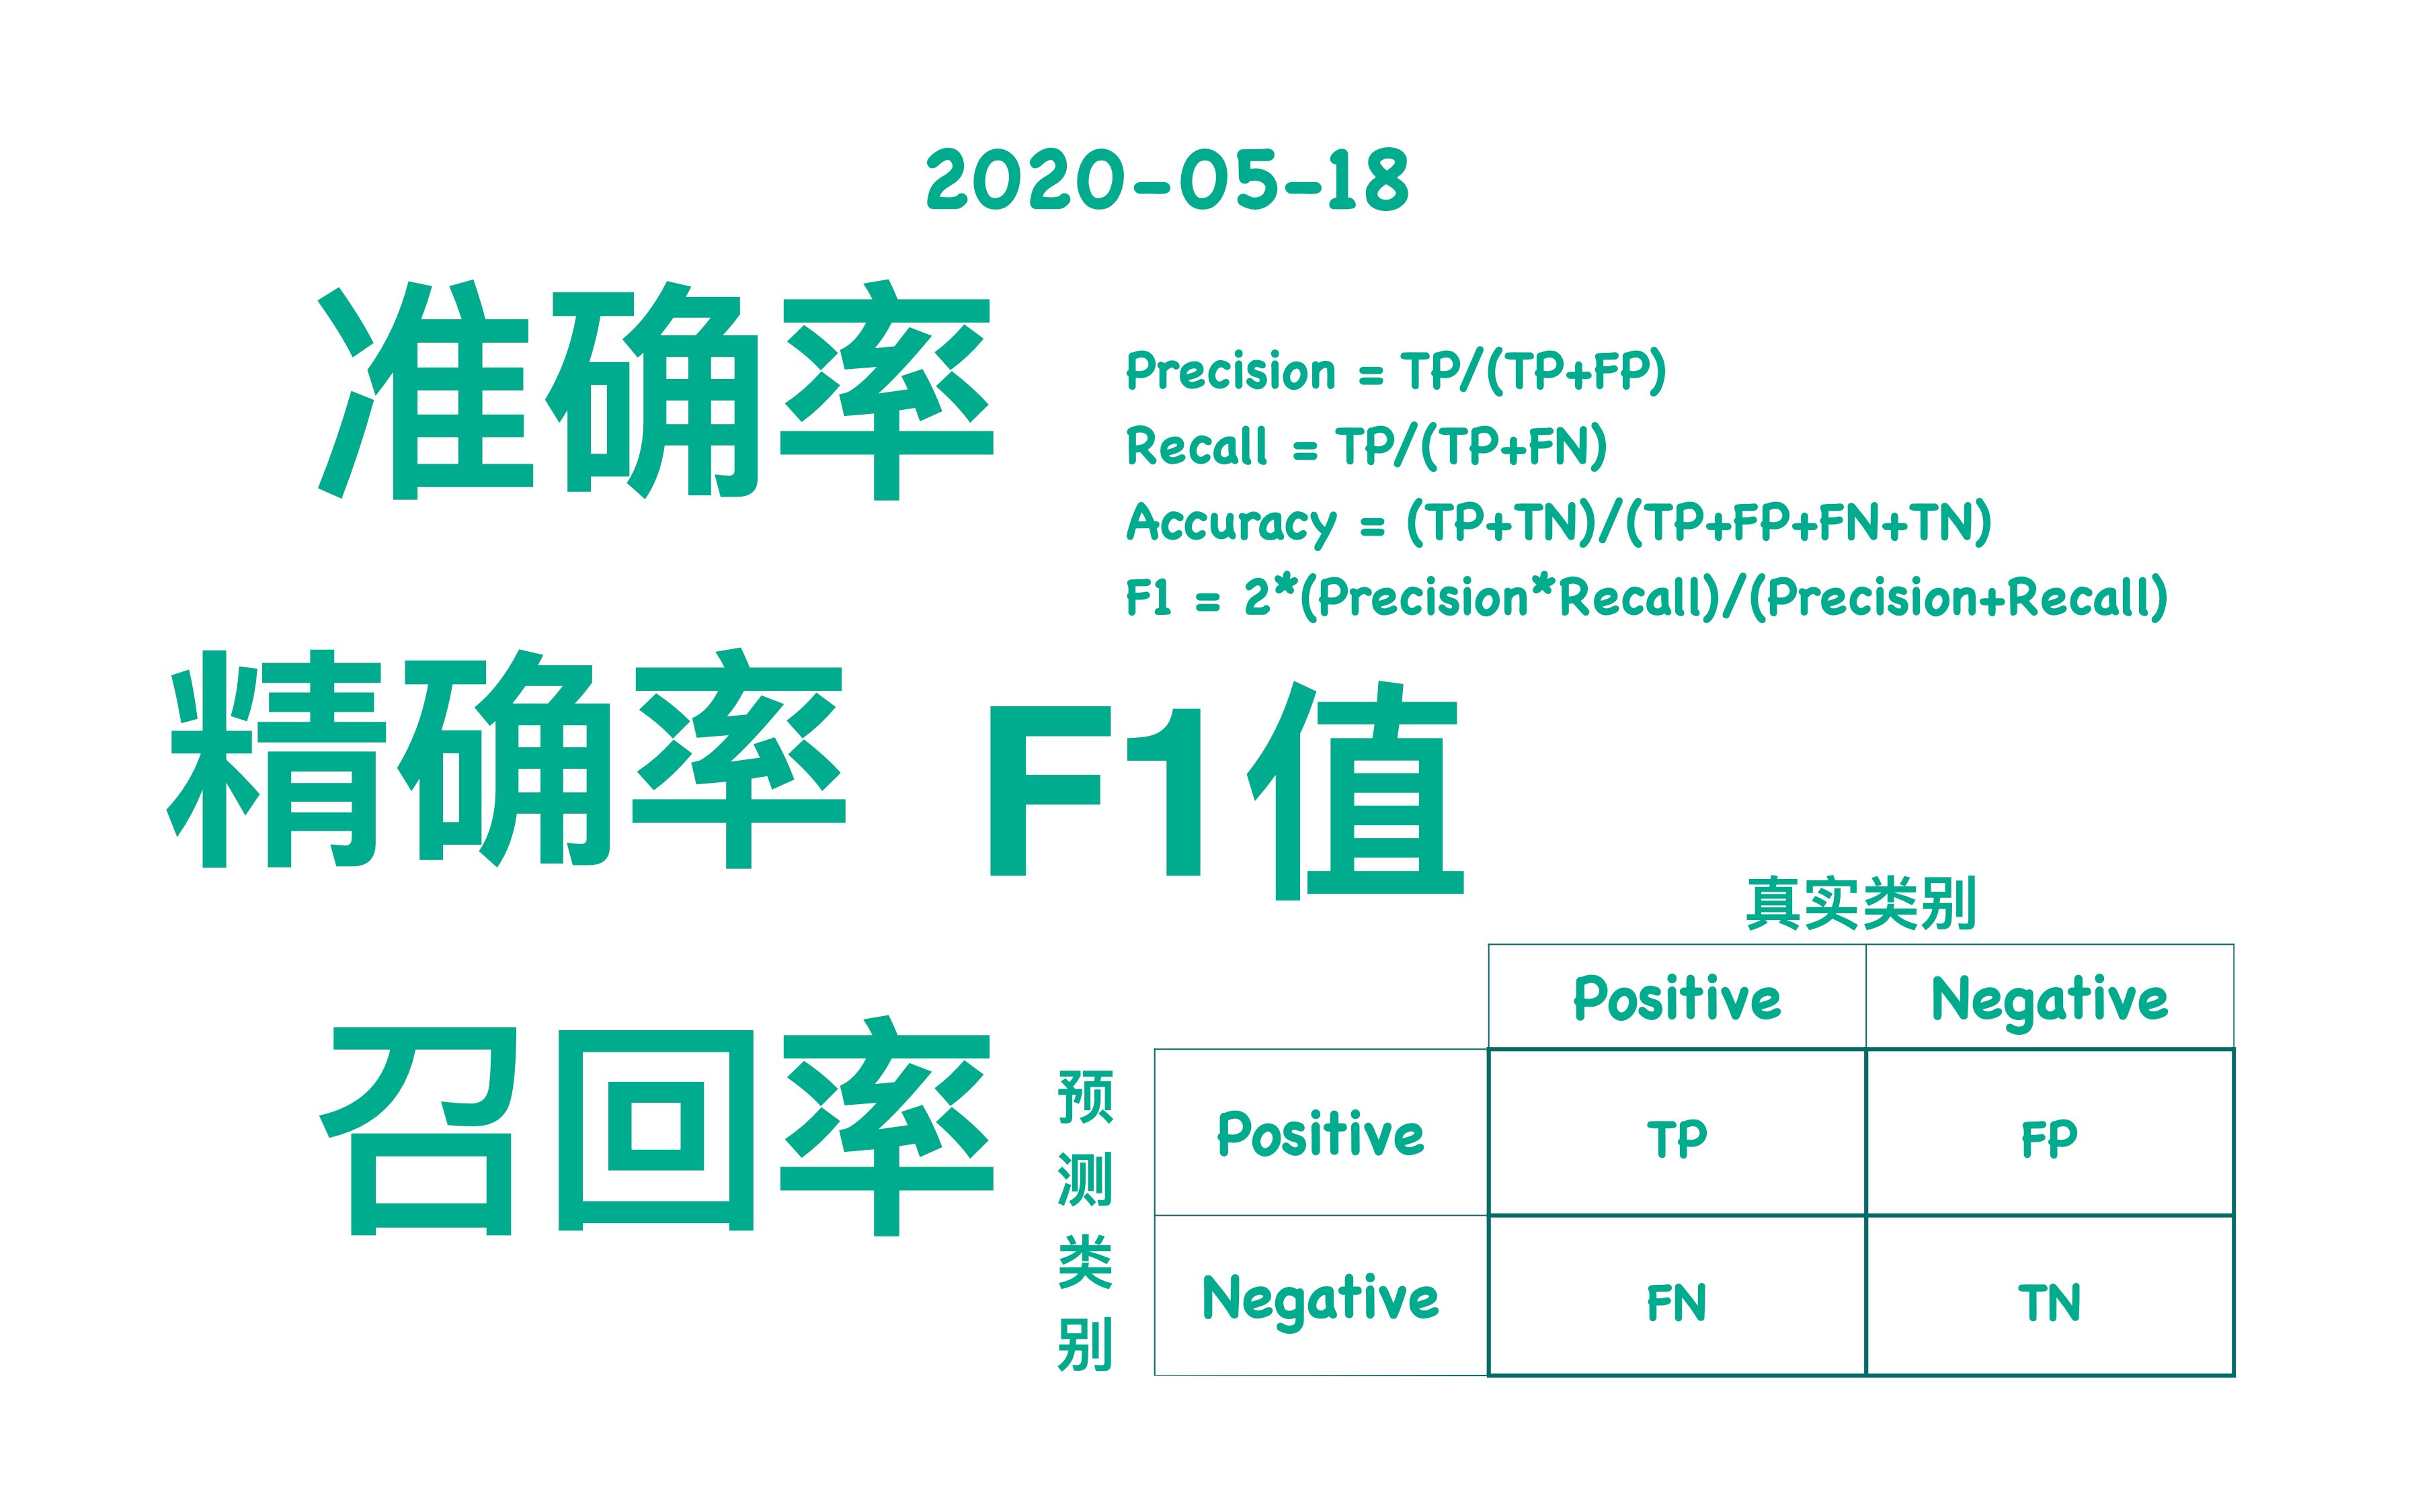

精确率与召回率的底层逻辑拆解
要理解这两个指标,必须回到分类问题的基本语境中,想象你在做医疗诊断,或者在搜索引擎中检索文档。
精确率:宁缺毋滥的准确性
精确率关注的是“预测为正类的样本中,真正为正类的比例”,用通俗的话说,你挑出来的东西里,有多少是对的”。
- 场景示例:垃圾邮件过滤系统。
- 高精确率表现:系统标记为垃圾邮件的邮件中,99%确实是垃圾邮件。
- 代价:可能会漏掉一些伪装成正常邮件的恶意攻击,或者把一些重要的促销邮件误判为垃圾邮件。
- 适用场景:金融风控、医疗诊断、法律合规审查,在这些领域,误报(False Positive)的成本极高,一旦误判可能导致巨额损失或法律纠纷。
召回率:宁可错杀不可放过的覆盖面
召回率关注的是“所有真实正类样本中,被正确预测为正类的比例”,换句话说,真正有用的东西里,你抓住了多少”。
- 场景示例:搜索引擎的关键词匹配。
- 高召回率表现:用户搜索“苹果”,系统尽可能多地返回与“苹果”相关的结果,包括水果、科技公司、新闻等。
- 代价:返回的结果中可能包含大量不相关的噪音,用户需要花费大量时间去筛选。
- 适用场景:搜索引擎、推荐系统、安防监控、早期疾病筛查,在这些领域,漏报(False Negative)的成本极高,错过一个关键信息可能导致严重后果。

大模型应用中的权衡策略与优化路径
在实际的大模型应用中,精确率和召回率往往呈现负相关,提高其中一个,另一个往往会下降,业内专家指出,解决这一矛盾的关键不在于盲目调整模型参数,而在于优化数据处理流程和提示工程策略。
通过阈值调整实现动态平衡
大模型通常输出的是概率值或置信度分数,通过调整分类阈值,可以灵活切换精确率和召回率的侧重。
- 降低阈值:更容易将样本判为正类,召回率提升,但精确率下降,适合需要全面覆盖的场景。
- 提高阈值:只有高置信度样本才被判定为正类,精确率提升,但召回率下降,适合需要高准确性的场景。
利用RAG架构提升综合表现
检索增强生成(RAG)技术为平衡精确率和召回率提供了新的思路。
- 检索阶段侧重召回率:使用向量数据库或混合搜索策略,尽可能多地召回相关文档片段,此时允许一定的噪音,确保不遗漏关键信息。
- 生成阶段侧重精确率:大模型基于召回的文档进行总结或回答,通过指令优化,要求模型只依据给定文档作答,剔除幻觉,从而提升最终输出的精确率。
实操步骤:构建高召回RAG系统
- 步骤一:选择支持多路召回的检索器,结合关键词匹配和向量相似度搜索。
- 步骤二:设置较高的Top-K值,例如召回前20个相关文档片段,而非默认的5个。
- 步骤三:在Prompt中明确指示模型:“请仅基于提供的参考文档回答问题,若文档中无相关信息,请明确说明。”
- 步骤四:引入重排序(Re-ranking)模型,对召回的文档片段进行二次排序,剔除明显无关的内容,提升输入给大模型的信息质量。

不同业务场景下的指标选择指南
不同的业务场景对精确率和召回率的容忍度截然不同,盲目追求单一指标的高分,往往会导致系统在实际应用中失效。
高精确率优先的场景
- 金融交易风控:误报会导致正常交易被拦截,影响用户体验和资金流转;漏报则可能导致资损,通常倾向于高精确率,确保拦截的交易确实是欺诈行为。
- 内容安全审核:对于违规内容的识别,高精确率至关重要,避免误删用户正常创作的内容,引发舆情风险。
高召回率优先的场景
- 搜索引擎优化:用户希望尽可能多地看到与查询意图相关的内容,即使其中夹杂少量不相关结果,用户也可以通过点击行为反馈来优化后续结果。
- 医疗早期筛查:在癌症早期筛查中,宁可假阳性(误报),也不能假阴性(漏报),因为假阳性可以通过进一步检查排除,而假阴性则可能延误治疗时机。
平衡型场景
- 电商推荐系统:既希望推荐的商品用户喜欢(精确率),又希望覆盖用户可能感兴趣但未明确表达的需求(召回率),通常使用F1-Score或F-beta分数来综合评估。
常见误区与避坑指南
在评估大模型性能时,许多团队容易陷入一些认知误区,导致优化方向错误。
平均准确率等于高精确率和高召回率
在类别不平衡的数据集中,准确率(Accuracy)具有误导性,在欺诈检测中,99%的交易是合法的,如果模型将所有交易都预测为合法,准确率高达99%,但召回率为0,完全无法检测欺诈,必须关注精确率和召回率,而非单纯看准确率。
认为大模型天生具备高精确率
大模型基于概率生成文本,容易产生“幻觉”,在没有外部知识约束的情况下,其输出的精确率往往不可控,通过RAG、思维链(CoT)等技巧,可以显著提升输出的事实准确性。

忽视业务反馈闭环
精确率和召回率是静态指标,而业务需求是动态变化的,建立用户反馈机制,收集误报和漏报的案例,持续微调模型或优化检索策略,才是提升长期性能的关键。
Q&A:关于精确率与召回率的常见疑问
大模型精确率和召回率如何量化评估?
评估大模型的精确率和召回率需要构建标注良好的测试集,对于生成式任务,通常将生成结果与标准答案进行比对,计算命中的关键词或语义相似度,精确率计算为“模型正确生成的片段数”除以“模型生成的总片段数”;召回率计算为“模型正确生成的片段数”除以“标准答案中的总片段数”,业内共识认为,使用自动化评估指标如ROUGE、BLEU或基于大模型的评估器(如LLM-as-a-Judge)可以提高评估效率,但人工抽检仍是验证金标准。
如何在大模型微调中提升召回率?
提升大模型微调中的召回率,关键在于数据增强和损失函数优化,扩充正样本数据,特别是覆盖长尾场景和边缘案例,确保模型见过足够多的正类样本,在训练过程中,可以调整类别权重,增加正样本的权重,迫使模型更关注正类的识别,使用对比学习(Contrastive Learning)技术,拉近正样本对的距离,推远负样本对的距离,也能有效增强模型对正类特征的捕捉能力。
精确率和召回率冲突时,该优先优化哪一个?
这完全取决于业务场景的成本结构,如果误报成本远高于漏报成本(如垃圾邮件过滤、欺诈检测),应优先优化精确率,宁可漏掉一些可疑对象,也要确保标记为问题的对象确实是问题,反之,如果漏报成本更高(如安防监控、疾病筛查),则应优先优化召回率,宁可产生一些误报,也要确保不放过任何潜在风险,在无法确定具体成本时,通常采用F1-Score作为平衡指标,但在实际工程落地中,结合业务专家的意见设定动态阈值是更优解。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/406502.html