GSM8K是衡量大模型基础数学推理能力的标准化基准测试,通过评估模型解决小学至初中水平应用题的能力,直观反映其逻辑拆解与计算准确性,是判断AI是否具备“思考”能力的关键指标。
在人工智能领域,当我们谈论大模型的智力水平时,往往会被那些花哨的创意写作或代码生成能力所吸引,真正决定一个模型是否靠谱的“硬骨头”,往往是那些看似简单却极易出错的基础数学题,GSM8K(Grade School Math 8K)正是这样一个专门为此设计的评测基准,它不仅仅是一个分数,更是大模型逻辑推理能力的试金石。

GSM8K评测的核心定义与背景
什么是GSM8K数据集
GSM8K是由OpenAI发布的一个高质量数学问题数据集,它包含了8500多道经过人工验证的小学水平数学应用题,这些题目并非复杂的微积分或高等代数,而是侧重于多步推理的应用题。“如果一家商店有50个苹果,卖出了10个,剩下的苹果每2个装一盒,可以装多少盒?”这类问题看似简单,但要求模型必须理解语境、提取关键数字、确定运算顺序,并执行准确的计算。
业内专家指出,选择“小学水平”题目并非因为大模型只能处理简单问题,而是为了剥离复杂的领域知识干扰,纯粹测试模型的逻辑链条构建能力,如果模型连基础的多步推理都无法正确完成,那么它在处理更复杂的商业分析或科学计算时,出现幻觉的概率将呈指数级上升。
评测标准与评分机制
GSM8K的评测核心在于“最终答案的准确性”以及“推理过程的合理性”,传统的准确率计算只看最后得出的数字是否正确,但近年来,随着思维链(Chain-of-Thought, CoT)技术的普及,评测方式变得更加精细。
目前主流的评测流程通常包含以下步骤:
- 提示工程:向模型输入问题,并附带特定的思维链提示,引导模型逐步思考。
- 生成推理过程:模型输出解题步骤,如“首先计算总数,然后减去损耗”。
- 答案提取:从生成的文本中提取最终数值。
- 比对验证:将提取的数值与标准答案进行比对。

为什么GSM8K成为主流评测基准
对比其他数学评测的优势
在GSM8K出现之前,许多评测集如MATH或AIME,题目难度极高,偏向于竞赛级别,这对于评估通用大模型的日常辅助能力来说,门槛过高且缺乏代表性,GSM8K填补了这一空白,它代表了大多数人类用户在日常工作和生活中遇到的数学问题复杂度。
与AIME(美国数学邀请赛)相比,GSM8K更贴近实际应用,AIME考察的是极致的逻辑深度和技巧,而GSM8K考察的是逻辑的稳定性和泛化能力,据行业共识认为,GSM8K的高分往往与模型在代码生成、自然语言理解等其他任务上的表现呈正相关,这意味着它具有良好的“代理指标”价值。
反映模型的真实推理能力
大模型本质上是一个概率预测引擎,它擅长模仿语言模式,但不擅长精确计算,GSM8K的存在,就是为了戳破这种“模仿”的泡沫,如果模型在GSM8K上得分较低,通常意味着它在处理需要严格逻辑约束的任务时,容易受到语言噪声的干扰,产生“幻觉”。
一个模型可能非常擅长写一首关于数学的诗,但在解决简单的加减乘除混合运算时却频频出错,GSM8K评测能够清晰地揭示这种“偏科”现象,帮助用户判断模型是否适合用于需要高准确率的场景,如财务初步核算或数据清洗。
如何解读GSM8K的得分数据
不同阶段模型的得分表现
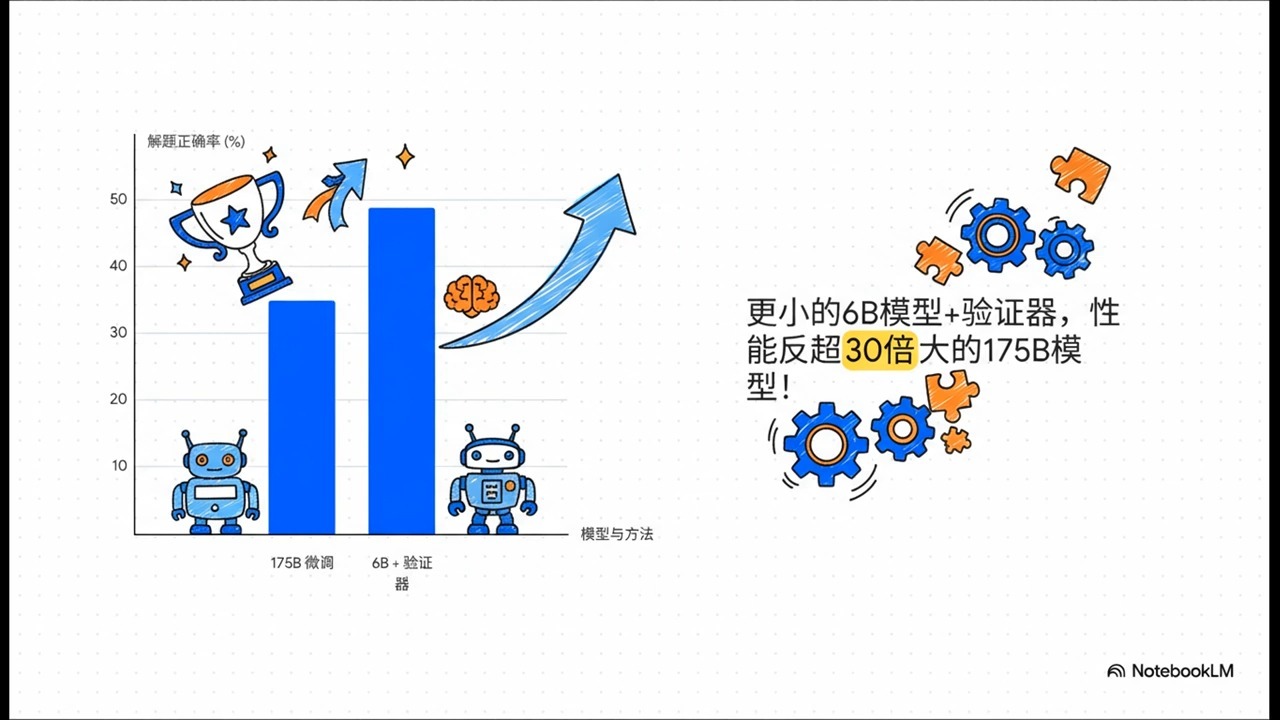
随着大模型技术的迭代,GSM8K的得分也在不断刷新,早期的大模型在未经过专门训练的情况下,得分可能仅在10%-20%左右,经过思维链微调后的模型,得分可提升至50%-70%,而目前顶尖的闭源模型,在开启思维链模式后,得分已普遍突破90%大关。
为了更直观地理解这一进展,我们可以参考以下典型表现区间:

- 基础阶段:得分低于40%,模型往往只能解决单步运算,多步推理容易断裂。
- 进阶阶段:得分在60%-80%之间,模型能够处理大部分标准应用题,但在复杂语境下仍易出错。
- 顶尖阶段:得分超过90%,模型展现出接近人类的解题稳定性,能够处理绝大多数小学至初中水平的复杂逻辑题。
影响得分的关键因素
除了模型本身的架构,评测得分还受到多种因素的影响,首先是思维链的长度,过短的推理过程可能导致逻辑跳跃,而过长的过程可能引入噪声,其次是提示词的质量,精心设计的提示词可以显著激发模型的潜在能力,最后是训练数据的质量,高质量、多样化的数学数据训练,比单纯增加数据量更为重要。
GSM8K评测的实际应用场景
企业选型与模型评估
对于企业而言,在选择大模型供应商时,GSM8K是一个不可忽视的参考指标,特别是在金融、教育、法律等对准确性要求极高的行业,企业需要确保所选模型具备可靠的逻辑推理能力,通过对比不同模型在GSM8K上的表现,企业可以初步筛选出技术实力较强的合作伙伴。
一些第三方评测平台会定期发布GSM8K排行榜,为市场提供透明的参考数据,用户在查询“大模型数学能力排名”或“GSM8K得分对比”时,往往能通过这些公开数据找到适合自己的模型。
开发者优化与调试
对于开发者来说,GSM8K不仅是评测工具,更是调试指南,当模型在特定任务上表现不佳时,开发者可以通过分析模型在GSM8K上的错误案例,找出逻辑断点,如果模型在涉及“百分比变化”的题目上频繁出错,开发者可以针对性地优化相关的提示词模板或微调数据。
实操中,开发者常采用以下步骤进行优化:
- 错误分析:收集模型在GSM8K测试集上的错题。
- 模式识别:分析错误类型,是计算错误、理解错误还是逻辑错误。
- 针对性优化:调整提示词结构或增加特定类型的训练数据。
- 回归测试:重新运行GSM8K评测,验证优化效果。

教育与研究辅助
在教育领域,GSM8K的数据集被广泛用于研究人类学习过程与机器学习的异同,研究人员通过对比模型与人类学生在解题步骤上的差异,探索更有效的教学策略,一些智能辅导系统利用GSM8K级别的题目,为学生提供个性化的数学练习和即时反馈。
GSM8K评测的局限性与未来展望
尽管GSM8K具有重要价值,但它并非完美无缺,它仅涵盖基础数学,无法反映模型在处理高等数学或专业领域问题时的能力,随着模型能力的提升,GSM8K的题目可能逐渐变得过于简单,导致“天花板效应”。
近年来,业界开始探索更复杂的数学评测基准,如MATH和AIME,以弥补GSM8K的不足,评测体系将更加多元化,不仅关注答案的准确性,还将关注推理过程的效率、可解释性以及跨学科的整合能力。
关于GSM8K数学评测的常见问题
GSM8K评测主要考察大模型的哪些能力?
GSM8K主要考察大模型的多步逻辑推理能力、数字敏感度以及语境理解能力,它通过解决小学至初中水平的应用题,测试模型能否将自然语言问题转化为数学表达式,并执行准确的计算步骤,从而反映其基础认知水平。
为什么有些模型在GSM8K上得分高但在实际应用中出错?
这通常是因为GSM8K题目相对标准化,而实际应用场景中存在大量噪声、歧义和非结构化信息,模型可能在测试时使用了特定的思维链提示,而在实际部署中未采用相同策略,导致推理能力未能充分激发。
GSM8K的满分是多少?
GSM8K数据集包含8500道题目,满分即为8500分,但在实际评测中,通常使用准确率百分比来衡量模型表现,满分对应100%的正确率,目前顶尖模型在开启思维链模式后,准确率已接近或超过90%。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/407431.html