


大模型推理吞吐量(Throughput)的核心计算公式为:单位时间内成功处理的请求总数或生成的Token总数,通常以每秒请求数(RPS)或每秒Token数(TPS)来衡量,其本质是系统资源利用率与延迟之间的平衡结果。
在2026年的AI落地场景中,单纯追求低延迟或高并发已不再足够,企业更关注的是如何在有限的GPU算力下,实现成本效益的最大化,理解吞吐量的计算逻辑,不仅是技术团队的必修课,更是决策者评估模型部署方案的关键指标。
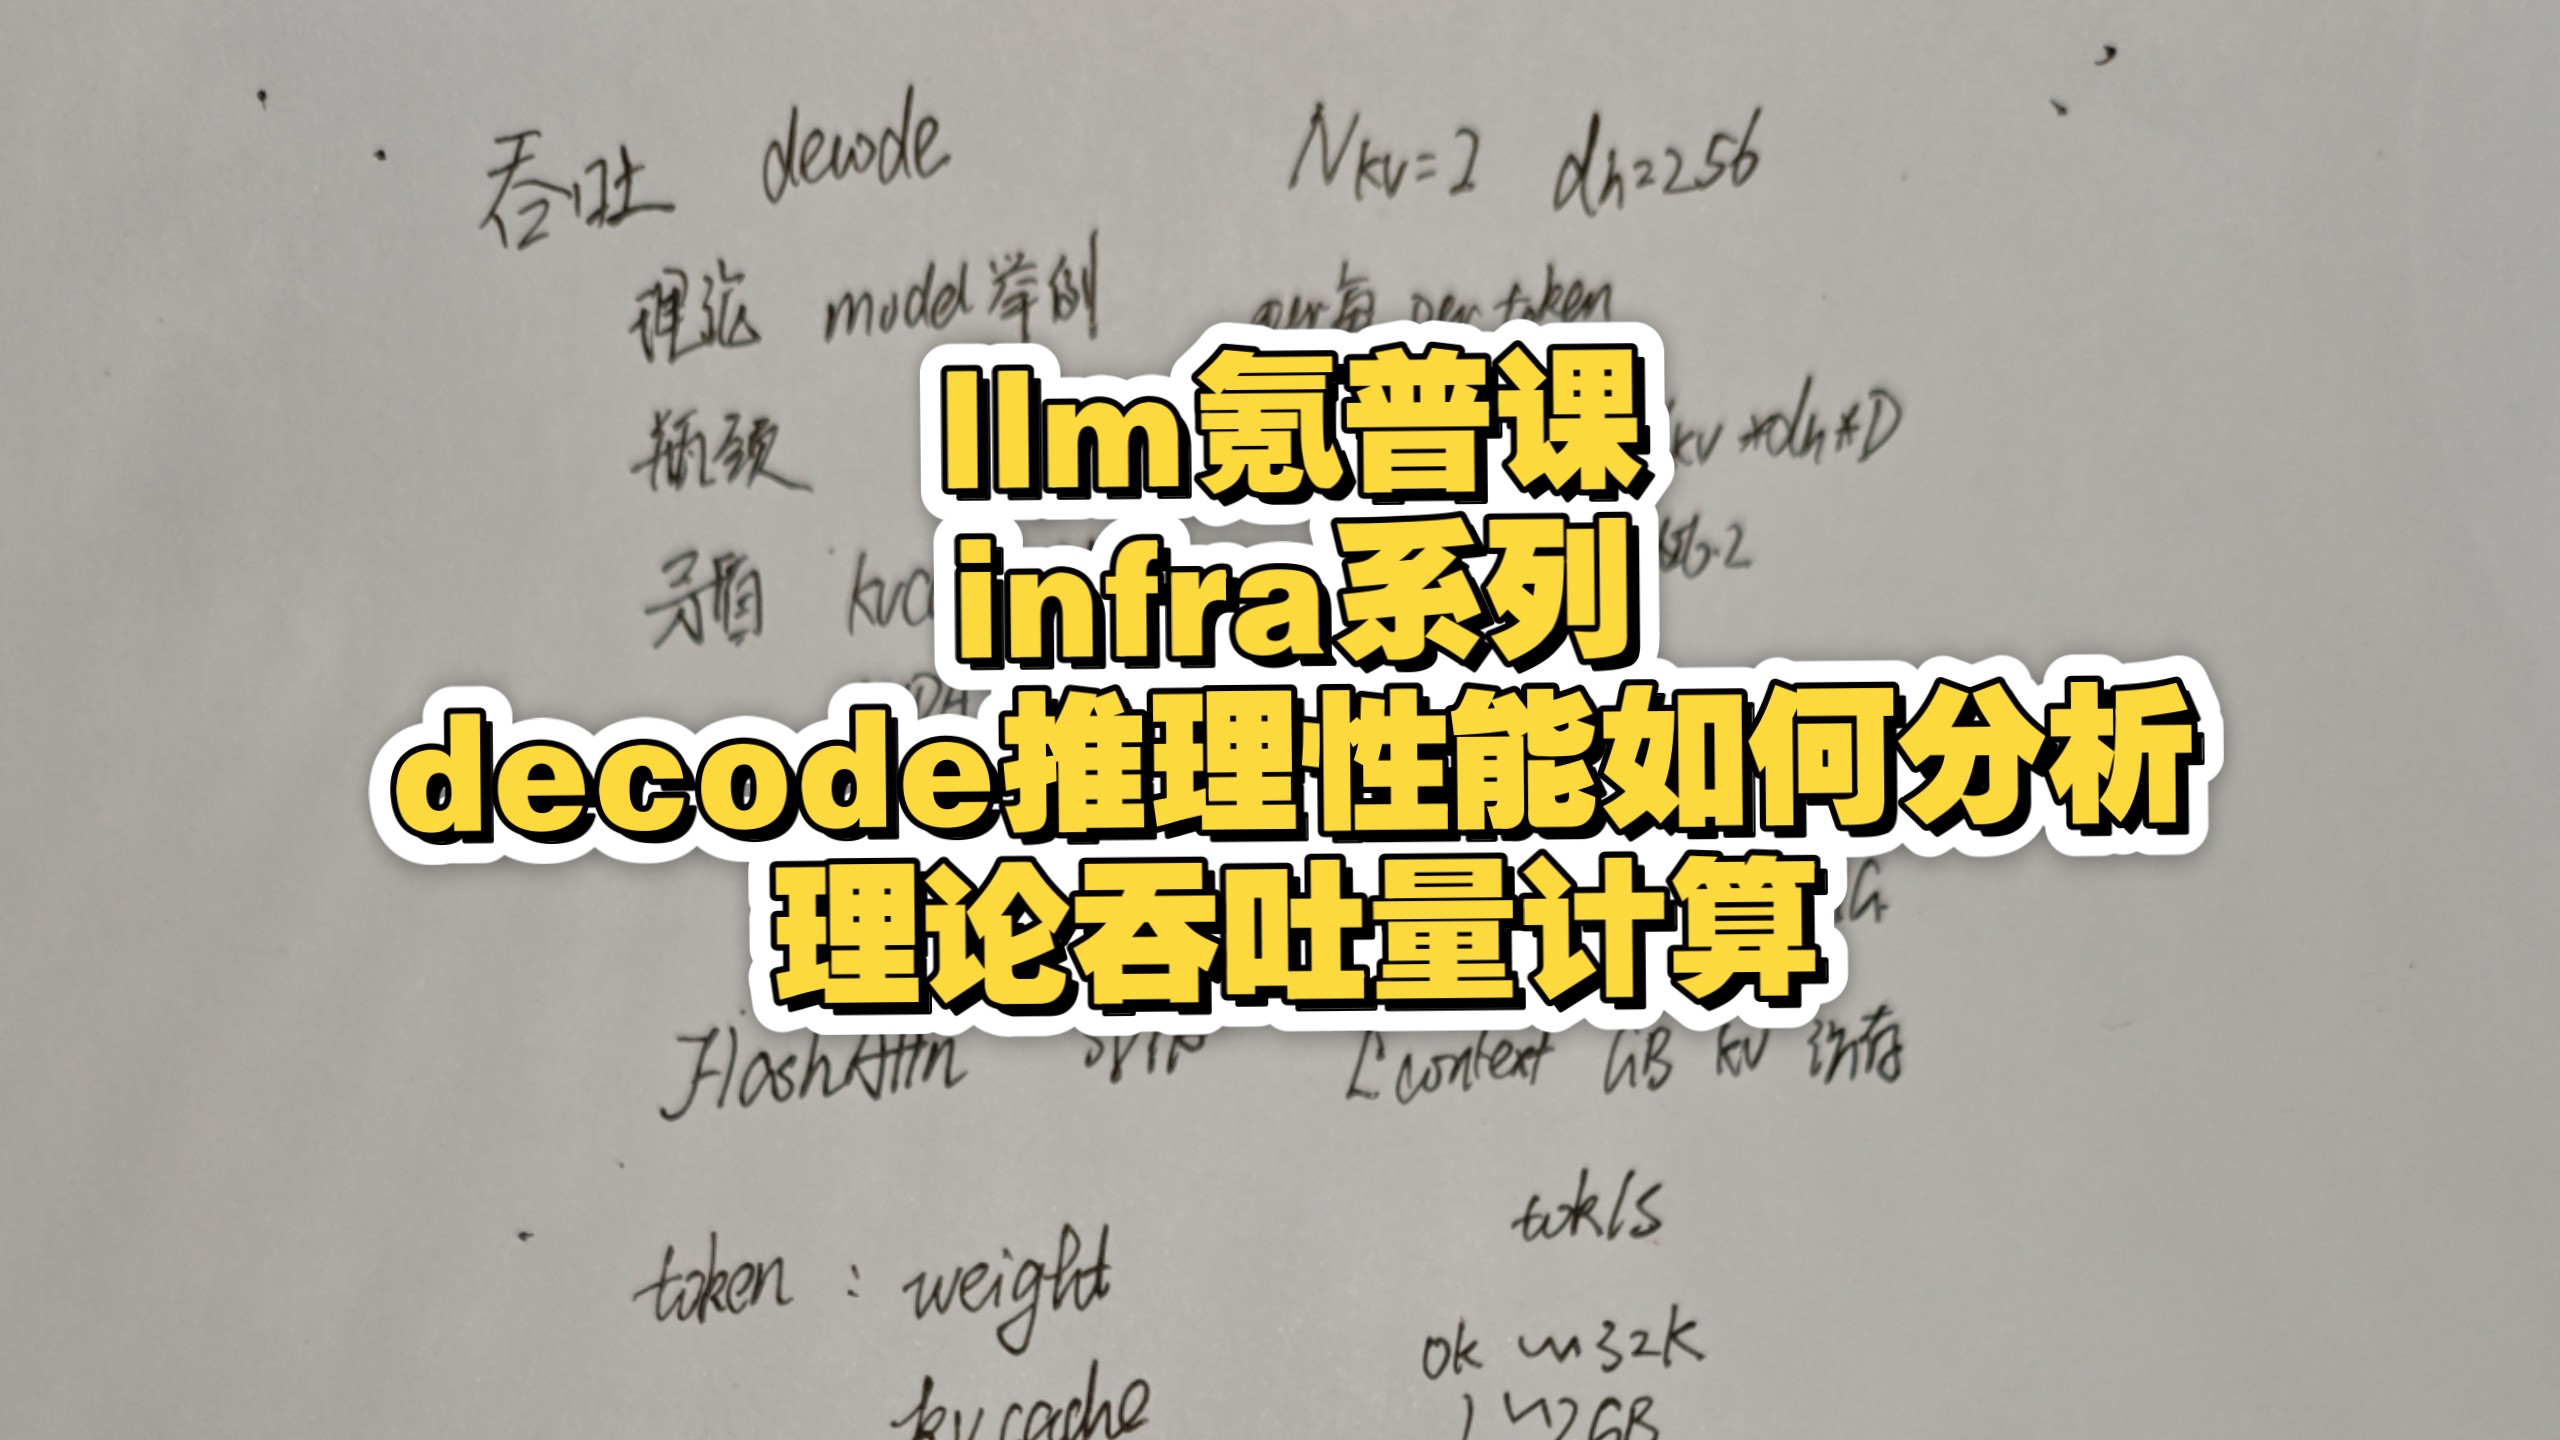

吞吐量核心定义与计算维度
吞吐量并非单一数值,而是一个多维度的性能指标,在评估大模型推理服务时,业内专家指出,必须区分“请求级”和“Token级”两种不同的计量方式,因为不同应用场景对这两者的敏感度截然不同。
每秒请求数 RPS 的计算逻辑
RPS(Requests Per Second)是最直观的指标,适用于对话机器人、客服系统等对交互频率敏感的场景。
基础计算公式
RPS = 成功处理的请求总数 / 总耗时(秒)
这里的“成功处理”通常指从接收用户输入到返回完整响应(包括思考过程和最终答案)的全过程,如果系统采用流式输出(Streaming),通常以最后一个Token生成完毕作为请求结束的标记。
并发与排队的影响
在实际生产中,RPS受限于系统的并发处理能力,当请求量超过系统承载上限时,新请求会被放入队列,虽然瞬时RPS可能很高,但平均延迟会急剧上升,导致用户体验下降,有效吞吐量应当是在可接受的延迟阈值内,系统能持续稳定处理的最大请求数。
每秒Token数 TPS 的计算逻辑
TPS(Tokens Per Second)更侧重于模型本身的生成能力,适用于内容创作、代码生成、长文本摘要等对生成长度敏感的场景。
基础计算公式
TPS = 生成的总Token数 / 总耗时(秒)
需要注意的是,这里的总Token数通常仅指模型输出的Token,不包含输入的Prompt Token,但在某些评估标准中,也会将输入和输出合并计算,称为总吞吐量。

为什么TPS比RPS更重要?
对于长文本生成任务,一个请求可能包含数千个输出Token,如果仅看RPS,可能会低估系统的实际负载,两个系统都能处理10 RPS,但系统A每个请求平均输出100 Token,系统B每个请求平均输出1000 Token,显然系统B的TPS是系统A的10倍,其算力消耗和实际价值也远高于A。
影响吞吐量的关键变量分析
吞吐量不是孤立存在的,它受到硬件、模型架构、推理引擎以及业务负载特征的多重制约,理解这些变量,才能找到提升吞吐量的突破口。
硬件资源与显存带宽
GPU的显存带宽往往是推理吞吐量的瓶颈,尤其是在大模型时代。
- 计算密集型 vs 内存密集型:对于小模型,计算单元(CUDA Core)是瓶颈;对于大模型(如70B以上参数),数据搬运速度成为关键,显存带宽越高,单位时间内能加载的参数越多,推理速度越快。
- 多卡并行策略:张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)能显著提升吞吐量,但也会增加通信开销,合理配置并行度,才能在显存利用率和通信延迟之间取得平衡。
模型量化与精度选择
精度对吞吐量有着决定性的影响,近年来,随着推理引擎的优化,低精度推理已成为主流趋势。
- FP16/BF16 vs INT8/INT4:将模型从FP16量化为INT4,显存占用可减少约75%,带宽需求大幅降低,这意味着在相同硬件下,可以部署更大的模型或支持更高的并发数,从而显著提升吞吐量。
- 精度损失可控性:对于大多数应用场景,INT4量化带来的精度损失在可接受范围内,但在医疗、法律等专业领域,需通过量化感知训练(QAT)来最小化误差。
批处理策略与动态调度
静态批处理(Static Batching)和连续批处理(Continuous Batching)是两种截然不同的调度策略,直接决定了吞吐量的上限。

静态批处理的局限
传统方法将所有请求打包成一个Batch,等待Batch中所有请求都完成才返回结果,这会导致“短板效应”:短请求必须等待长请求,造成GPU空闲,吞吐量低下。
连续批处理的优势
连续批处理允许在生成过程中动态添加新请求,移除已完成请求,这样GPU可以始终处于满载状态,显著提升了资源利用率,业内共识认为,采用连续批处理技术的推理引擎,其吞吐量通常比传统静态批处理高出3-5倍。
不同场景下的吞吐量优化实战
理论计算只是基础,实际部署中需要根据具体场景进行针对性优化,以下是几种典型场景的优化路径。
高并发短文本场景
适用于问答机器人、意图识别等场景,输入短,输出也短。
- 优化重点:降低首字延迟(TTFT),提高请求处理速度。
- 操作建议:使用较小的Batch Size,启用连续批处理,优先优化KV Cache的管理效率,避免不必要的模型加载和解压开销。
长文本生成场景
适用于报告生成、代码编写、视频脚本创作等场景,输入长,输出更长。
- 优化重点:最大化Token生成速度,优化显存带宽利用率。
- 操作建议:采用INT4量化,使用FlashAttention等高效注意力机制算法,优化KV Cache的内存布局,确保GPU计算单元不被内存访问阻塞。
混合负载场景
实际生产环境中,往往同时存在短请求和长请求。
- 优化重点:公平性与效率的平衡。
- 操作建议:实施优先级调度策略,将短请求优先处理,避免长请求阻塞系统,监控系统负载,动态调整Batch Size,防止OOM(显存溢出)。
吞吐量与延迟的权衡艺术
吞吐量与延迟往往呈反比关系,提高吞吐量通常意味着增加Batch Size,但这会增加单个请求的等待时间,从而提升延迟。

寻找最佳平衡点
企业需要根据业务SLA(服务等级协议)来确定最佳平衡点。
- 实时性要求高:如客服对话,应优先保证低延迟,接受较低的吞吐量。
- 批量处理要求高:如数据分析、内容批量生成,应优先保证高吞吐量,容忍较高的延迟。
监控与调优闭环
建立完善的监控体系是持续优化的关键。
- 关键指标监控:实时监控RPS、TPS、平均延迟、P99延迟、GPU利用率、显存占用率。
- 动态调整:根据监控数据,自动调整Batch Size、并发连接数等参数,实现自适应负载均衡。
常见问题解答
大模型推理吞吐量Throughput怎么算最准确?
最准确的计算方式是结合业务场景,分别计算RPS和TPS,对于对话系统,以RPS为主,关注首字延迟;对于生成系统,以TPS为主,关注生成速度,建议采用端到端测试,统计一定时间窗口内的成功请求数和生成Token总数,除以总耗时,得出综合吞吐量,需剔除系统预热和异常请求的影响,确保数据的有效性。
提升大模型推理吞吐量有哪些具体技术手段?
主要技术手段包括:1. 模型量化,如使用INT8或INT4精度,减少显存带宽压力;2. 推理引擎优化,如启用Continuous Batching,动态管理KV Cache;3. 硬件加速,使用支持高带宽内存的GPU,或采用专用AI加速芯片;4. 算法优化,如使用FlashAttention减少注意力计算的内存访问;5. 服务层优化,如实施请求排队和优先级调度,避免资源争抢。
吞吐量高是否意味着用户体验一定好?
不一定,吞吐量高仅代表系统处理能力强,但用户体验更依赖于延迟(Latency)和稳定性,如果为了追求高吞吐量而大幅增加Batch Size,导致用户等待时间过长,体验反而会下降,高吞吐量下若出现请求失败或响应错误,用户体验也会大打折扣,应在保证低延迟和高可用性的前提下,尽可能提升吞吐量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/410596.html



评论列表(1条)
卧槽刚升职看到这太应景了!2026年还死磕低延迟?世界真美好啊,咱们现在就是要平衡!