


将DMP数据导入MySQL并同步本地Git仓库到企业级Repo,核心在于解决数据格式兼容性与版本控制权限管理的衔接问题,通常通过ETL清洗脚本配合Git-SVN或Git-Repo工具链实现自动化流转。
在数据驱动的业务场景中,离线分析(DMP)与代码资产(Git)往往处于割裂状态,DMP产生的海量用户标签数据需要进入MySQL进行结构化存储,而开发团队的代码迭代则需要通过Repo进行集中管理,将这两者打通,不仅能提升数据交付效率,还能确保代码与数据版本的一致性,业内专家指出,构建这种混合数据管道是中型以上互联网企业数据中台建设的必经之路。
DMP数据清洗与MySQL导入实战路径
DMP(Data Management Platform)导出的数据通常是非结构化的JSON、CSV或Parquet格式,且包含大量脏数据,直接导入MySQL会导致字段类型不匹配或主键冲突,预处理是第一步。
数据格式标准化处理
在导入前,必须对原始数据进行清洗,假设你从DMP平台导出了一个包含用户ID、行为时间、标签值的CSV文件。
字段类型映射规则
MySQL对数据类型敏感,DMP中的时间戳通常是毫秒级整数,而MySQL的DATETIME或TIMESTAMP需要特定格式。
- 时间字段:使用Python的`pandas`库将毫秒时间戳转换为`YYYY-MM-DD HH:MM:SS`格式。
- 标签字段:DMP中的标签可能是字符串数组,需转换为JSON字符串存入`TEXT`或`JSON`类型字段,避免多表关联的性能损耗。
- 空值处理:将空字符串统一替换为`NULL`,避免MySQL索引失效。

批量导入工具选择
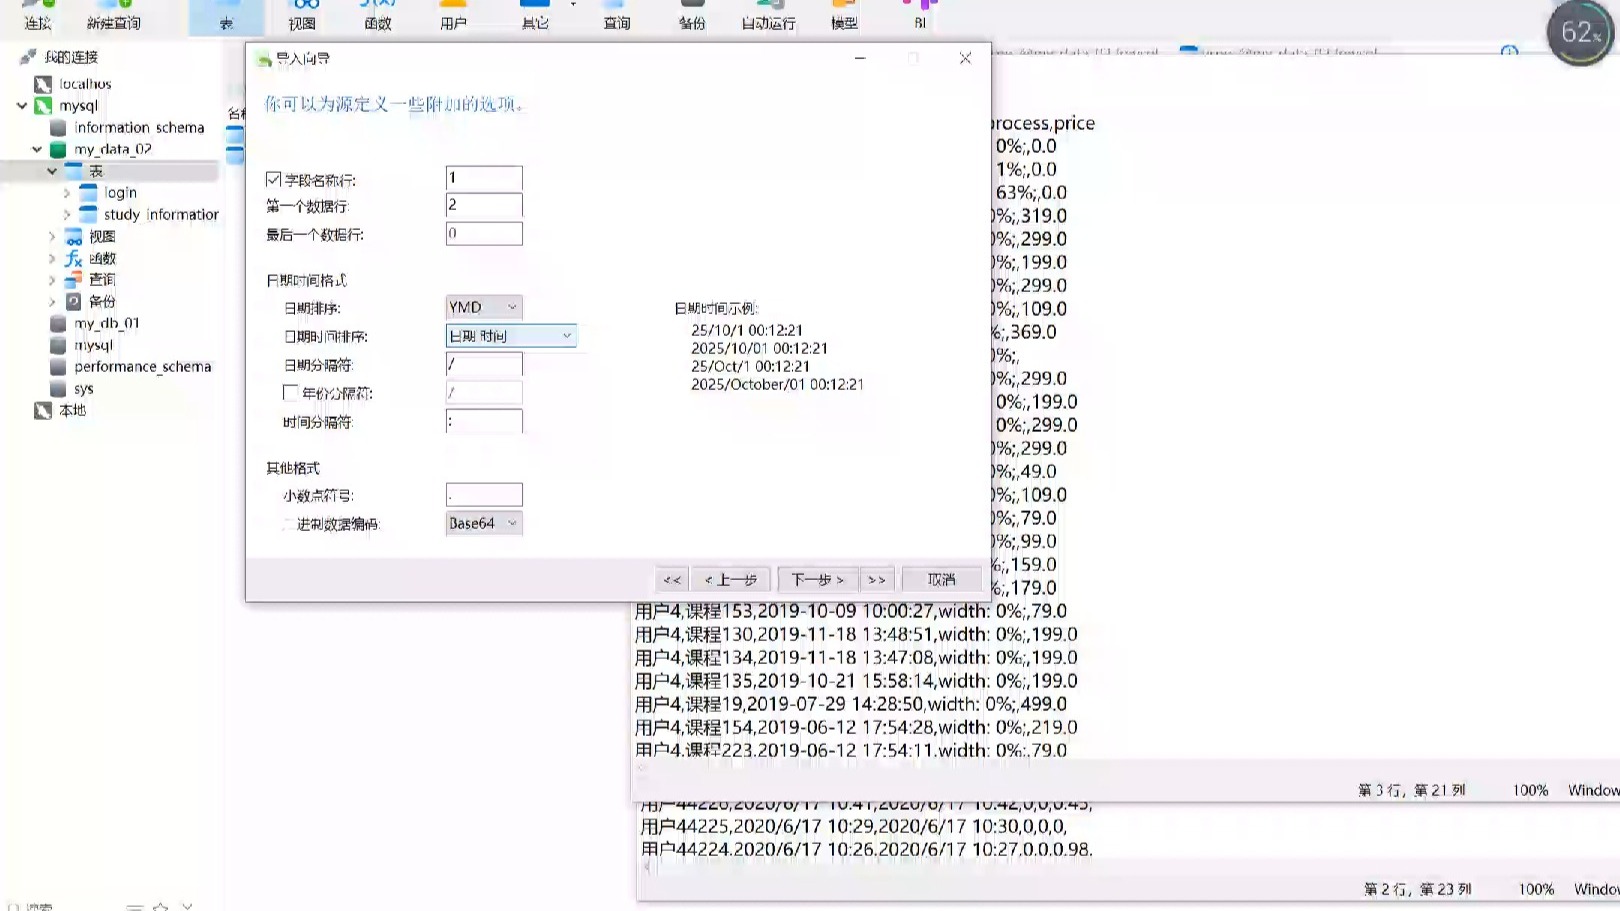
对于百万级数据,INSERT语句效率极低,推荐使用LOAD DATA INFILE或mysqlimport。
- 准备SQL文件:生成`LOAD DATA LOCAL INFILE ‘data.csv’ INTO TABLE user_tags FIELDS TERMINATED BY ‘,’ ENCLOSED BY ‘”‘ LINES TERMINATED BY ‘n’;`
- 配置MySQL权限:确保MySQL用户拥有`FILE`权限,并设置`local_infile=1`。
- 执行导入:在命令行运行`mysql -u username -p database_name < load_script.sql`。
本地Git仓与Repo的同步机制
很多团队混淆了Git仓库(Git Repository)和企业级代码托管平台(如GitLab、Gerrit或特定的Repo服务)。”把本地Git仓导入Repo”通常指将本地版本库推送到远程服务器,或从远程同步到本地。
Git-Repo工具链配置
如果是指Android或大型项目的repo工具(基于Git的多仓库管理),操作逻辑略有不同。
初始化与同步
- 安装Repo工具:确保系统已安装Python和Git。
- 获取清单文件:从企业Repo服务器获取
manifest.xml。 - 初始化仓库:运行
repo init -u <remote_url> -b <branch_name>。 - 同步代码:运行
repo sync,这会将所有子仓库克隆到本地。
本地仓推送到远程
若需将本地修改后的Git仓推送到企业Repo:
- 添加远程地址:`git remote add origin
`。 - 推送分支:`git push origin master`。
- 处理冲突:若远程已有更新,需先`git pull –rebase`再推送。

数据与代码的联动场景分析
在实际生产环境中,DMP数据和Git代码往往需要协同工作,当数据模型变更时,对应的ETL脚本也需要更新。
版本控制与数据版本一致性
数据 schema 的变更必须与代码版本绑定,建议在Git仓库中建立schema/目录,存放SQL建表语句和数据迁移脚本。
自动化部署流程
- 开发者修改ETL脚本并更新
schema/下的SQL文件。 - 提交代码到Git,触发CI/CD流水线。
- 流水线检查SQL语法,并自动在测试环境执行数据迁移。
- 验证通过后,合并到主分支,并在生产环境执行。
常见误区与解决方案
- 误区:直接在Git中存储大型DMP数据文件。
- 后果:仓库体积膨胀,克隆速度极慢。
- 方案:使用Git LFS(Large File Storage)存储二进制文件,或在数据库中存储数据,Git仅存储元数据和脚本。
性能优化与安全合规考量
在处理大规模DMP数据时,性能和合规性是两大瓶颈。
MySQL导入性能调优
索引策略
在导入数据前,建议暂时禁用唯一索引和二级索引,导入完成后再重建,这可将导入速度提升3-5倍。
事务控制
对于大文件导入,关闭自动提交(SET autocommit=0;),每导入10万条数据手动提交一次事务,减少日志写入压力。

数据安全与权限管理
DMP数据包含用户隐私,必须严格管控。
数据脱敏
在导入MySQL前,对手机号、身份证等敏感字段进行哈希处理或掩码处理。
Repo访问控制
企业级Repo应实施基于角色的访问控制(RBAC),只有经过审批的开发人员才能推送代码到主分支,据工信部相关数据安全规范建议,代码仓库应定期审计提交记录,防止恶意代码注入。
Q&A:常见问题解答
DMP数据导入MySQL报错1040怎么办?
错误1040表示”Too many connections”,这通常是因为并发连接数超过MySQL配置上限,解决方法包括:增加max_connections参数,或优化ETL脚本,使用分批导入而非全量并发导入,建议检查应用层的连接池配置,确保连接及时释放。
本地Git仓如何快速同步到远程Repo?
若本地仓库较大,同步耗时较长,可使用git clone --mirror创建裸仓库镜像,或使用git push --force强制覆盖远程分支(需谨慎操作),对于Repo工具,使用repo sync -c仅同步当前分支,可减少网络流量。
如何确保DMP数据与Git代码版本匹配?
最佳实践是在Git提交信息(Commit Message)中记录数据版本号,或在数据库中建立版本表,每次数据模型变更时,生成唯一的版本号,并在ETL脚本中硬编码该版本,这样在排查数据问题时,可通过版本号快速定位对应的代码逻辑。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/458713.html






评论列表(1条)
卧槽,这标题把我整不会了,DMP往MySQL里灌?硬是要得!上次我搞这个,脚本跑得比我家狗还快,巴适~