Hive数据仓库的核心价值在于将海量结构化日志数据映射为表结构,通过SQL语言实现高效的大规模数据查询与分析,是构建企业级离线数仓的基石。
在大数据生态系统中,Hive扮演着“翻译官”的角色,它让不懂Java或MapReduce底层逻辑的数据分析师,也能用熟悉的SQL语法操作PB级数据,这种架构设计极大地降低了大数据处理的门槛,使得数据仓库的建设从“代码驱动”转向“SQL驱动”。
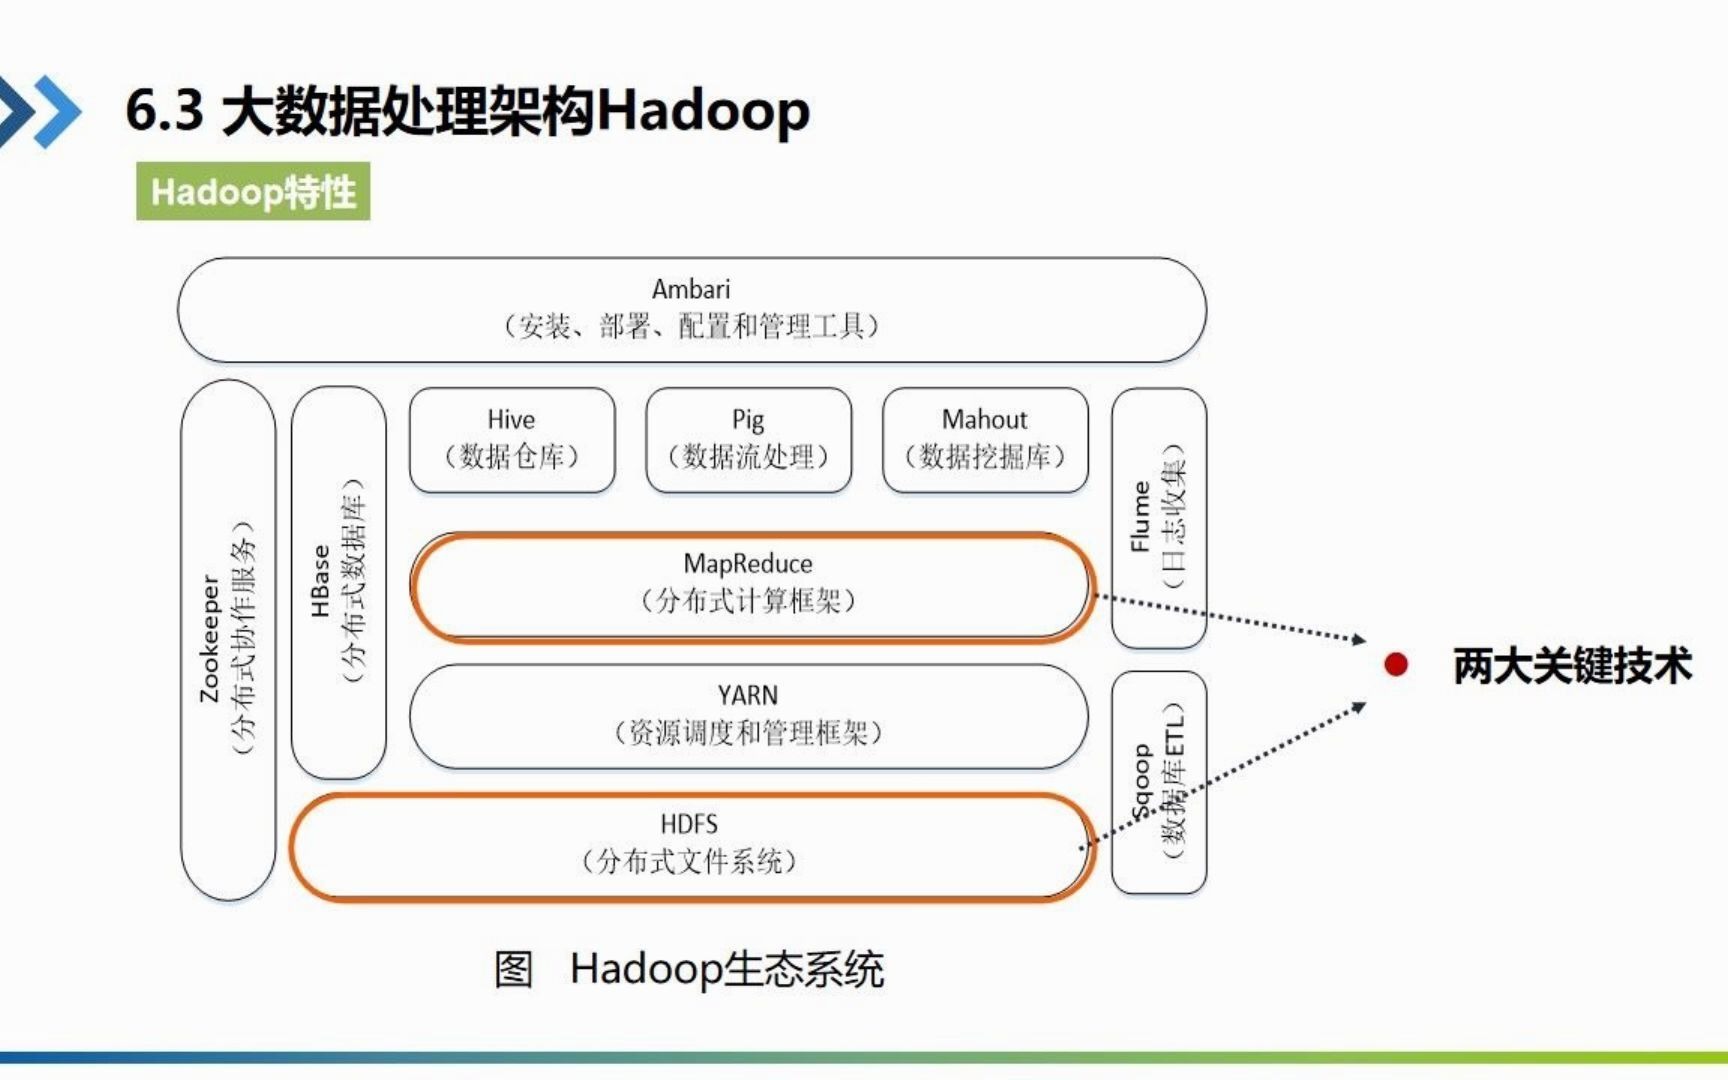

Hive架构核心组件解析
理解Hive架构是掌握其应用的前提,Hive并非一个独立的数据库,而是建立在Hadoop之上的数据仓库工具,其核心设计思想是将结构化的数据文件映射为一张数据库表,并提供完整的SQL查询功能。
用户接口层:交互的桥梁
用户通过不同的接口与Hive进行交互,这些接口构成了Hive架构的最外层。
CLI(命令行接口)
这是最基础的交互方式,通过shell命令直接执行HiveQL语句,适合脚本自动化处理和初步调试,但在复杂查询中体验较差。
Web UI
提供图形化界面,方便查看元数据信息和简单的查询结果,对于非技术人员或需要快速预览数据场景非常友好。
JDBC/ODBC驱动
这是企业级应用中最常用的接口,BI工具(如Tableau、FineBI)通过JDBC连接Hive,实现报表自动化生成,这种集成方式保证了数据的一致性和实时性(针对离线数据而言)。
元数据存储:数据的大脑
元数据是Hive的“字典”,存储了表名、列信息、分区信息、HDFS路径等关键信息。
Metastore服务
Metastore是一个独立的服务进程,负责管理元数据,它通常存储在关系型数据库中,如MySQL、Derby或PostgreSQL。
元数据管理策略
– Derby:默认嵌入式数据库,仅支持单用户访问,适合本地测试,严禁用于生产环境。
– MySQL:业界主流选择,支持多用户并发访问,稳定性高,需配置远程访问权限。
– 高可用方案:对于超大型集群,可采用Hive Metastore Server集群配合外部存储,确保元数据服务的高可用性。

Hive执行引擎与优化机制
Hive本身不存储数据,也不直接处理计算,它依赖Hadoop的MapReduce、Tez或Spark作为执行引擎,理解引擎差异对性能优化至关重要。
MapReduce引擎:经典但缓慢
早期Hive默认使用MapReduce引擎,其特点是将每个HiveQL语句转换为一个或多个MapReduce作业。
- 优点:稳定性极高,兼容性好,适合对延迟不敏感的离线批处理。
- 缺点:磁盘I/O开销大,作业启动时间长,不适合交互式查询。
- 适用场景:每天凌晨运行的T+1报表生成、大规模数据ETL任务。
Tez引擎:中间结果优化
Tez是一个通用的数据应用框架,旨在克服MapReduce的局限性。
- 核心优势:支持有向无环图(DAG)执行计划,能够复用中间结果,减少磁盘写入。
- 性能提升:相比MapReduce,Tez在复杂查询场景下性能提升显著,延迟降低约50%-70%。
- 配置要点:需在Hive配置中启用
hive.execution.engine=tez,并正确配置Tez资源。
Spark引擎:内存计算加速
Spark作为新一代计算引擎,凭借其内存计算特性,在Hive中展现出强大潜力。
- 内存优势:数据在内存中处理,避免了大量的磁盘I/O,速度比MapReduce快10-100倍。
- 混合架构:Hive on Spark结合了Hive的元数据管理能力和Spark的计算能力,成为当前大数据平台的主流选择。
- 实施建议:对于实时性要求较高的离线分析,建议优先采用Hive on Spark架构。
生产环境实战与常见问题排查
在实际工作中,Hive的性能调优和数据治理是保证数仓稳定运行的关键。
数据倾斜解决方案

数据倾斜是导致Hive任务运行缓慢甚至失败的主要原因,当某个Key的数据量远大于其他Key时,会导致个别Reducer负载过高。
识别倾斜
观察TaskTracker日志,若发现部分Task运行时间远超其他Task,且数据量分布不均,则可能存在倾斜。
优化策略
– 参数调整:设置`hive.groupby.skewindata=true`,让Hive自动进行Map端预聚合。
– 加盐处理:在Join操作中,为Key添加随机前缀,将热点Key分散到不同Reducer,最后再进行全局聚合。
– 过滤无效数据:在Join前过滤掉空值或异常Key,减少无效计算。
小文件合并机制
HDFS不适合存储大量小文件,这会NameNode内存压力巨大,并影响MapReduce任务效率。
合并场景
– 数据导入后:使用`Hive`的`INSERT OVERWRITE`或`Concatenate`命令合并小文件。
– 查询前优化:在查询语句中加入`SET hive.merge.mapfiles=true;`和`SET hive.merge.mapredfiles=true;`,强制在Map或MapReduce结束后合并输出文件。
最佳实践
建议将HDFS块大小设置为128MB或256MB,并在ETL流程中定期执行小文件合并任务,保持数据文件的整洁。
Hive与其他大数据组件对比
选择合适的数据仓库工具需结合具体业务场景,Hive并非万能,了解其边界有助于架构选型。
Hive vs HBase
| 特性 | Hive | HBase |
|---|---|---|
| 数据模型 | 列族存储,适合批量读写 | 列族存储,适合随机读写 |
| 查询方式 | SQL,离线分析 | API,实时查询 |
| 延迟性 | 高延迟(分钟/小时级) | 低延迟(毫秒/秒级) |
| 适用场景 | 数据仓库、报表分析 | 实时索引、用户画像存储 |

业内专家指出,Hive适合用于历史数据的深度挖掘和分析,而HBase适合用于在线业务的高频读写场景,两者常配合使用,Hive负责离线分析,结果写入HBase供在线服务调用。
Hive vs Spark SQL
Spark SQL是Spark生态中的模块,提供类似Hive的SQL接口。
- 性能对比:Spark SQL基于内存计算,通常比Hive on MapReduce快10倍以上,与Hive on Tez相当或略优。
- 兼容性:Spark SQL兼容Hive的语法和元数据,可无缝迁移Hive表。
- 趋势判断:随着Spark生态的成熟,越来越多的企业开始逐步将Hive任务迁移至Spark SQL,以获得更好的性能和更统一的计算引擎。
Hive数据仓库架构详解常见问题
Hive支持实时数据查询吗?
Hive设计初衷是用于离线批处理,不支持毫秒级实时查询,若需实时分析,建议结合Kafka和Spark Streaming,或使用ClickHouse、StarRocks等OLAP引擎,Hive可通过外部表间接读取Kafka数据,但延迟通常在分钟级以上。
如何保证Hive数据的安全性?
企业级Hive部署需启用Kerberos认证和Sentry或Ranger权限管理,通过配置ACL(访问控制列表),限制不同用户对特定库、表或列的访问权限,对敏感数据字段进行加密或脱敏处理,确保数据合规。
Hive元数据丢失怎么办?
Hive元数据存储在外部关系型数据库中,若数据库损坏,可通过备份恢复,建议定期备份Metastore数据库,并采用主从复制架构提高可用性,若元数据与HDFS数据不一致,可使用MSCK REPAIR TABLE命令同步分区信息,或使用DESCRIBE FORMATTED命令检查表结构。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/472486.html