分布式数据存储在哪里?核心答案是:数据被分散存放在多个独立物理节点上,这些节点通过软件定义组成统一存储池,节点可以分布在同一机柜、不同楼层甚至跨数据中心。你问“数据到底存在哪台机器上”,其实没有固定答案分布式存储的精髓就是让数据在多个位置间动态分布,既保证高可用,又隐藏了具体路径。参考2
分布式存储数据放在哪里:节点到机房的完整链路
要理解“数据在哪”,必须先看分布式存储的物理承载层,数据最终落在硬盘上,但硬盘装在服务器里,服务器放在机柜中,机柜属于某个数据中心,分布式存储的“分散”体现在所有这些层级。
物理节点是基本单元
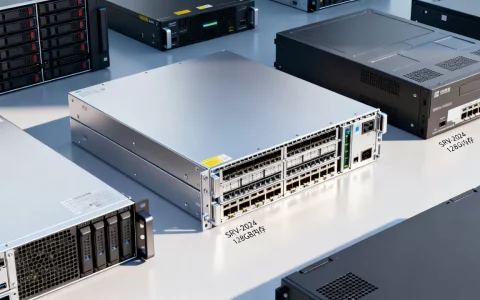
每个节点就是一台通用服务器,自带CPU、内存和若干块硬盘,节点之间通过万兆或25GbE网络互联,数据以固定大小的块(通常是4MB或64MB)切分后,根据策略分布到不同节点的硬盘上,业内共识认为,至少3个副本是保证数据不丢的常见做法,每个副本必须放在不同节点,这意味着你的数据同时存在于至少3台服务器的硬盘里,任何一台宕机都不影响读取。
从机架到数据中心:故障域隔离
光把副本放在不同节点还不够,节点可能因为同一电源或网络交换机而同时失效,所以分布式存储会定义故障域:机架、楼层、数据中心,副本会分布在不同机架(避免机架掉电)或不同数据中心(避免地震洪水),大型公有云厂商会把数据副本分散到同一城市的不同可用区,甚至跨地域,你的一条记录可能成都机房存一份,上海机房存一份,广州机房存一份,物理距离越远,容灾能力越强,但延迟也越高。参考2
元数据服务决定你访问哪一份
数据虽然分散,但用户访问时不知道具体路径,分布式存储内部有一个元数据服务(或分布式元数据集群),它维护着一张“数据→位置”的映射表,当你写入一个文件,元数据服务分配3个节点IP和磁盘偏移量,数据直接写入那些位置,读取时,元数据服务返回距离你最近或负载最低的副本位置,所以从用户视角,数据“在”集群里,但实际存放位置由元数据实时调度。
分布式存储与集中式存储对比:数据存放逻辑的差异
很多企业纠结“到底用分布式还是集中式”,核心分歧就在数据存放方式上,集中式存储(如传统SAN/NAS)把所有数据放在一台阵列或双控设备里,虽然读写快,但单点风险高,分布式存储则把数据打散,存在成百上千台节点上,下面用三点对比说明差异。
存放粒度不同
- 集中式:数据以完整LUN或文件系统形式存放在固定硬盘上,扩容必须换机头或加扩展柜。
- 分布式:数据被切分为小块,均匀分布到所有节点硬盘上,扩容时新节点自动加入存储池,数据自动重平衡,无需手动迁移。
冗余机制不同
- 集中式:通常依赖RAID(如RAID5、RAID6)保护单台设备内的硬盘故障,一旦阵列本身故障,所有数据不可用。
- 分布式:依靠多副本或纠删码,副本跨节点存放。大部分分布式系统默认三副本,允许同时坏掉两个节点不会丢数据,纠删码(如EC 4+2)则用更少空间实现类似容错,但重建开销更大。
访问路径不同
- 集中式:所有IO经过存储控制器,控制器成为瓶颈。
- 分布式:客户端直接与持有数据的节点通信(如Ceph的RADOS直接访问OSD),无中心瓶颈,并发能力随节点数量线性增长。
行业共识认为,分布式存储更适合海量数据、高并发场景,而集中式在低延迟小规模场景仍有优势,如果你不确定自己业务适合哪种,可以直接咨询集成商,他们会根据你的企业分布式存储方案需求给出对比测试。
企业架构选型:分布式存储方案怎么选,关注数据存放策略
当你决定采用分布式存储,下一步就是选择具体方案,不同方案对数据存放的控制粒度、成本、运维要求差异很大,你需要从下面几个维度判断。
数据存放位置的控制权
- 私有化部署:硬件放在自己机房,数据完全在本地,适合金融、政务等强合规场景,你可以选择如

国内分布式存储厂商
(如华为、新华三、曙光、XSKY等)的软硬件一体机,或纯软件方案跑在通用服务器上。 - 公有云对象存储:数据存放在云厂商的全球数据中心,你无法指定具体物理位置,但可以选地域(如华东2、华北3)。分布式存储价格按使用量计费,无需初期投入,长期运行成本可能高于自建。
- 混合云:冷数据放在本地,热数据或者备份数据放在云端,数据存放策略需要统一命名空间,部分厂商提供跨云调度能力。
性能与成本的权衡
- 如果追求极致性能,选择全闪存节点,副本数可以降到2(但风险高,不推荐),或者使用EC降低冗余开销,但全闪存节点成本高,分布式存储价格主要受硬盘类型、节点数量、副本/EC比率影响。
- 如果追求容量,选择大容量HDD节点,搭配EC 4+2,有效容量利用率可达80%以上,但重建时间长,需要预留一定性能余量。
具体实操:如何查看数据存放位置
以Ceph为例,你可以在客户端执行ceph osd map <pool-name> <object>查看对象所在OSD列表,然后用ceph osd tree确认OSD所在的服务器和机架,这让你清楚知道数据“在哪台机器、哪个机架、哪个机房”,对于运维人员,定期检查数据分布是否均衡很重要,使用ceph balancer命令可自动调整。参考2
分布式存储价格的主要影响因素
“分布式存储价格”没有统一报价,因为它由多个变数组成,以下因素直接决定总成本。
硬件成本
- 节点数量:最少3节点(三副本时),但通常推荐8-12节点起步,才能发挥分布式的线性扩展优势,节点越多,管理软件和网络设备成本越高。
- 硬盘类型:全SSD方案价格是HDD方案的5-10倍,归档场景用SATA HDD,高性能场景用NVMe SSD。
- 网络设备:万兆交换机是基础,25GbE/100GbE用于高性能场景,网络设备成本可能占整体15%-20%。
软件许可与运维
- 开源软件(如Ceph、MinIO)免费,但需要专业团队部署和维护。
相当一部分企业
选择商业发行版(如Red Hat Ceph Storage、XSKY星辰天合),按节点或容量收费,每年服务费约是硬件成本的15%-20%。 - 公有云对象存储无前期硬件成本,按存储量、请求次数、外网流量计费,以简米云OSS为例,标准型存储单价在0.12元/GB/月左右,但频繁访问会产生附加费用,长期大量存储时,自建在三年内可能更划算。
隐含成本
- 电力与制冷:分布式存储节点多,功耗集中,单节点功耗约200-400W,40节点集群一年电费可能超过10万元。
- 机房空间:自建需要机柜、UPS、空调等。较大比例的企业选择托管在IDC,按机柜租赁,年费数万到数十万不等。
你可以在需求文档中要求供应商提供分布式存储价格的TCO(总拥有成本)计算表,把硬件、软件、运维、电费、空间都列出来,再做对比。
关于分布式数据存储位置的常见疑问
分布式存储的数据放在本地还是上云?
看业务对延迟和合规的要求,需要低延迟和物理控制权,选本地部署;需要弹性扩容和免运维,选公有云对象存储,很多企业采用混合云:本地存核心数据,云端存备份和归档。两者没有绝对优劣,取决于你的预算和风险承受能力。
分布式存储数据放在哪里最安全?
安全取决于冗余策略和故障域设置,至少三副本且跨机架是最低要求,如果数据重要性极高,应该跨数据中心部署,甚至跨地域容灾,但成本会显著增加。安全等级与投入成正比,没有绝对安全,只有可接受的风险水平。
分布式存储与集中式存储的数据存放本质区别是什么?
本质区别在于数据是否打散并存放在多个自治节点上,集中式存储数据存放在单台设备,外部访问要经过单一控制器;分布式存储数据分片后存放在成百上千台节点,每块数据有多个副本,访问路径由元数据动态分配,系统无单点故障。这个区别决定了分布式存储的天花板远高于集中式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/521839.html